ネットワークセキュリティ
AI クローラーリスト: 29 のボットの User-Agent と、IP で検証できるもの
用途別にまとめた 29 の AI クローラーリスト。User-Agent、robots.txt の記述、レンジファイルに加え、GeoIPHub が IP で検証する 16 のボットを紹介します。2026 年 11 月 9 日確認。
対象範囲: 2026 年 11 月 9 日に開くことができたページで運営元が文書化している、AI 用途のボットです。Meta は広告用クローラーの meta-externalads も文書化していますが、これは数えていません。運営元の文書がないまま他のリストで出回っている名前は、確認した内容とともに別のリストにまとめています。
運営元は、この 29 のボットのうち 25 について証明手段を公開しています。GeoIPHub の API が検証するのは 16 です。残りの 9 は、運営元の文書に欠けがあるわけではありません。GeoIPHub が読み込んでいないファイルやページであり、どれに当たるかはリストに示しています。
ほかのリストは名前とトークンを挙げますが、User-Agent ヘッダーの名前は誰でも書き込めるため、何も証明しません。運営元による証明には 5 つの形があります。JSON ファイル、アドレスを載せた Web ページ、逆引き DNS、署名、そして何もないケースです。この記事は、IP によるボット検出に関する取り組みの一部です。以下では、用途別の各ボット、件数と日付を付けた 22 のレンジファイル、読み込んでいるファイルのうち 14 から取った実在のアドレスに対して GeoIPHub の API が返した内容、ログの 1 行を正しいファイルと照合するスニペット、そしてログには現れない名前や出典を確認できなかった名前を順に紹介します。
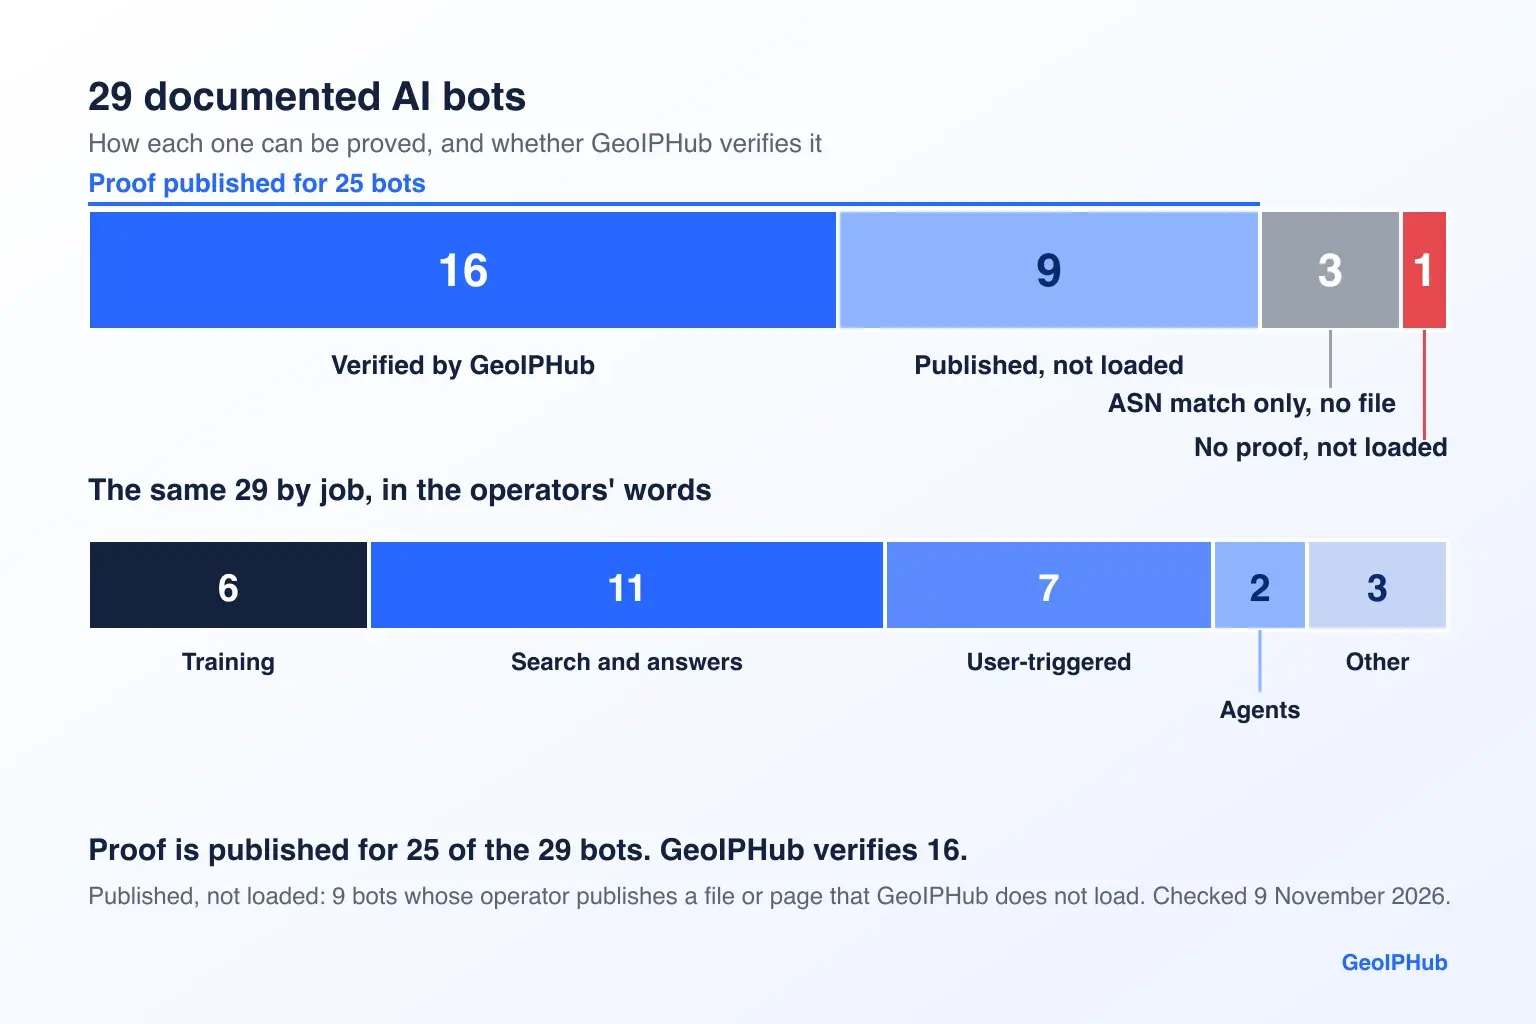
AI クローラーリスト: 用途別 29 のボット
この AI クローラーリストでは、文書化された 29 のボットとその AI クローラー User-Agent を、運営元が示す用途で分類しています。学習、検索、ユーザー起点のフェッチ、エージェント、そしてそのいずれにも当てはまらない少数のグループです。どの項目にも 4 つの用語を使います。証明は運営元が公開しているものを指します。レンジファイル、アドレスを載せた Web ページ、逆引き DNS、署名、または何もない、のいずれかです。検証済みは、そのボット自身のファイルのアドレスが、表示した日付に GeoIPHub の API で verified: true を返したことを意味します。ASN のみ照合は、運営元のネットワークを照合して verified: false を返すことを意味します。未読み込みは、その運営元のリストを GeoIPHub が読み込んでいないことを意味します。
分類は運営元自身の言葉に従っており、きれいに分かれるわけではありません。OpenAI は「両方のボットを許可しているサイトでは、1 回のクロール結果を両方の用途に使うことがあります」(原文: "If your site has allowed both bots, we may use the results from just one crawl for both use cases")と述べています。Meta は「学習などの用途」と述べています。Amazon は「学習に使われることがあります」と述べています。Apple のクローラーはまず検索用であり、モデルの学習の「助けにも使われることがあります」。Cloudflare のボットドキュメントも同じ 3 分類を採っています。Search(「検索インデックスや RAG データベースを構築するためのクロール」)、Agent(「人間に代わってページを訪れる、ユーザー指示のエージェント」)、Training(「モデルを学習またはファインチューニングするためのクロール」)です。
モデルを学習する AI クローラーはどれですか?
運営元自身の記述によると 6 つです。
GPTBot (OpenAI)
- UA の断片:GPTBot/1.4
- 証明:ファイル
- robots.txt、運営元の記述:「GPTBot を禁止することは、サイトのコンテンツを生成 AI の基盤モデルの学習に使用しないでほしいという意思表示です。」
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
ClaudeBot (Anthropic)
- UA の断片:ClaudeBot
- 証明:ファイル(共有)
- robots.txt、運営元の記述:「Anthropic のボットは、robots.txt の業界標準ディレクティブを尊重することで『クロール禁止』のシグナルを尊重します。」
- GeoIPHub での検証:検証済み(Anthropic として)
- 確認日:2026-11-09
MistralAI-Training (Mistral)
- UA の断片:MistralAI-Training/1.0
- 証明:なし
- robots.txt、運営元の記述:「ウェブマスターは robots.txt ファイルでこの user agent を禁止できます。」
- GeoIPHub での検証:未読み込み(mistralai-training-ips.json は 404 を返す)
- 確認日:2026-11-09
meta-externalagent (Meta)
- UA の断片:meta-externalagent/1.1
- 証明:なし
- robots.txt、運営元の記述:「これらのクローラーをブロックするには、該当するクローラーの disallow を robots.txt に追加してください。」
- GeoIPHub での検証:ASN のみ照合、未検証
- 確認日:2026-11-09
Amazonbot (Amazon)
- UA の断片:Amazonbot/0.1
- 証明:Web ページのみ
- robots.txt、運営元の記述:「記載されたこれらの user agent による自動クロールは Robots Exclusion Protocol を尊重し、user-agent と allow/disallow ディレクティブに従います。」
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
KimiBot (Moonshot)
- UA の断片:KimiBot/1.0
- 証明:ファイル(1 ファイル、3 つの名前)
- robots.txt、運営元の記述:引用なし
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
目的を運営元の言葉で見ると、GPTBot は「生成 AI の基盤モデルの学習に使われる可能性のあるコンテンツをクロールするために使用される」とされています。MistralAI-Training は「Mistral の生成 AI モデルを学習するためのデータセット構築に役立てるため、ウェブコンテンツをクロールする」とされています。KimiBot は「Kimi の基盤モデルの学習に使われる可能性のあるコンテンツをクロールする」とされています。
検索と回答を支える AI クローラーはどれですか?
11 あり、GeoIPHub が読み込んでいるセットにある従来型の検索クローラー 2 つを含みます。
OAI-SearchBot (OpenAI)
- UA の断片:OAI-SearchBot/1.4
- 証明:ファイル
- robots.txt、運営元の記述:「OAI-SearchBot をオプトアウトしたサイトは、ChatGPT の検索回答に表示されません」
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
Claude-SearchBot (Anthropic)
- UA の断片:Claude-SearchBot
- 証明:ファイル(共有)
- robots.txt、運営元の記述:ClaudeBot と同じ Anthropic の文
- GeoIPHub での検証:検証済み(Anthropic として)
- 確認日:2026-11-09
PerplexityBot (Perplexity)
- UA の断片:PerplexityBot/1.0
- 証明:ファイル
- robots.txt、運営元の記述:引用なし
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
MistralAI-Index (Mistral)
- UA の断片:MistralAI-Index/1.0
- 証明:ファイル
- robots.txt、運営元の記述:引用なし
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
meta-webindexer (Meta)
- UA の断片:meta-webindexer/1.1
- 証明:なし
- robots.txt、運営元の記述:meta-externalagent と同じ Meta の文
- GeoIPHub での検証:ASN のみ照合、未検証
- 確認日:2026-11-09
Amzn-SearchBot (Amazon)
- UA の断片:Amzn-SearchBot/0.1
- 証明:Web ページのみ
- robots.txt、運営元の記述:「robots.txt ファイルに Amzn-SearchBot の記載がなく、ほかの検索ボットを許可している場合、Amzn-SearchBot はほかの検索ボットに与えられた robots.txt のディレクティブに従ってクロールします。」
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
Applebot (Apple)
- UA の断片:Applebot/0.1
- 証明:ファイル + 逆引き DNS
- robots.txt、運営元の記述:「Applebot は、Applebot を対象とした一般的な検索クロールでは、標準的な robots.txt ディレクティブを尊重します。」
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
Bingbot (Microsoft)
- UA の断片:Bingbot
- 証明:ファイル
- robots.txt、運営元の記述:引用なし(Microsoft のページは JavaScript が必要なため読めませんでした)
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
DuckAssistBot (DuckDuckGo)
- UA の断片:DuckAssistBot/1.2
- 証明:ファイル
- robots.txt、運営元の記述:「DuckAssistBot の user agent を禁止するようファイルを更新すると、変更は 72 時間後に反映され、DuckAssistBot はサイトのクロールを停止します。」
- GeoIPHub での検証:検証済み(DuckDuckBot のアドレスもこの名前を返す)
- 確認日:2026-11-09
Kimi-SearchBot (Moonshot)
- UA の断片:Kimi-SearchBot/1.0
- 証明:ファイル(共有)
- robots.txt、運営元の記述:引用なし
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
YouBot (You.com)
- UA の断片:YouBot/1.0
- 証明:署名 + 逆引き DNS + Web ページのみ(1 つの /24)
- robots.txt、運営元の記述:「robots.txt のディレクティブとクロール頻度の設定を尊重します」
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
Bingbot と Applebot をここに入れたのは、GeoIPHub が読み込んでいるセットに含まれ、Apple が自社のクローラーはモデルの学習に役立てられることがあると述べているためです。Microsoft のクローラーのページは JavaScript が必要で読めませんでしたが、10 月 30 日の投稿では Bingbot を通じて AI の設定を行うとしています。YouBot は 3 つの証明がそろう唯一の項目です。you.com/.well-known/http-message-signatures-directory にある署名ディレクトリ、youbot-68-67-112-106 という形式の逆引き DNS、そして「正規の YouBot のリクエストは 68.67.112.0/24 から送信されます。」という記述です。
目的を運営元の言葉で見ると、PerplexityBot は「Perplexity の検索結果でウェブサイトを表示しリンクするために設計されています。AI の基盤モデルのためにコンテンツをクロールするものではありません。」とされています。MistralAI-Index は「インデックス作成のみを目的としたウェブの自動クロール用」とされています。DuckAssistBot は「AI による回答支援のためにページをリアルタイムでクロールする」もので、「このデータは AI モデルの学習には一切使用されません。」とされています。
ユーザーの依頼でページを取得する AI クローラーはどれですか?
7 つあり、ほかに Google のユーザー起点のフェッチャーがあります。
ChatGPT-User (OpenAI)
- UA の断片:ChatGPT-User/1.0
- 証明:ファイル
- robots.txt、運営元の記述:「これらの動作はユーザーが開始するため、robots.txt のルールが適用されない場合があります。」
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
Claude-User (Anthropic)
- UA の断片:Claude-User
- 証明:ファイル(共有)
- robots.txt、運営元の記述:Anthropic の全ボットに共通の文(ClaudeBot を参照)。ユーザー起点の例外は見つかりませんでした
- GeoIPHub での検証:検証済み(Anthropic として)
- 確認日:2026-11-09
Perplexity-User (Perplexity)
- UA の断片:Perplexity-User/1.0
- 証明:ファイル
- robots.txt、運営元の記述:「ユーザーがフェッチを依頼したため、このフェッチャーは通常 robots.txt のルールを無視します。」
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
MistralAI-User (Mistral)
- UA の断片:MistralAI-User/1.0
- 証明:ファイル
- robots.txt、運営元の記述:「MistralAI-User は、これらのユーザーのリクエストをどのサイトに対して行えるかを制御します。」
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
meta-externalfetcher (Meta)
- UA の断片:meta-externalfetcher/1.1
- 証明:なし
- robots.txt、運営元の記述:「ユーザーが依頼したフェッチを行うため、robots.txt を回避することがあります」
- GeoIPHub での検証:ASN のみ照合、未検証
- 確認日:2026-11-09
Amzn-User (Amazon)
- UA の断片:Amzn-User/0.1
- 証明:Web ページのみ
- robots.txt、運営元の記述:「Amzn-User の動作はユーザーが開始することがあるため、robots.txt のすべてのディレクティブに従うとは限りません。」
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
Kimi-User (Moonshot)
- UA の断片:Kimi-User/1.0
- 証明:ファイル(共有)
- robots.txt、運営元の記述:「動作はユーザー起点のため、robots.txt のルールが直接適用されない場合があります」
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
Google のページには Google-GeminiNotebook も挙げられており、これは「Gemini Notebook のユーザーがソースとして指定した個々の URL を取得する」とされています。Google のユーザー起点のレンジファイルのどれに含まれるかは書かれていないため、検証できず、リストからは外しました。
エージェントである AI ボットはどれですか?
2 つあり、どちらもユーザーに代わってウェブを操作するエージェントとして文書化されています。
Google-Agent (Google)
- UA の断片:Google-Agent
- 証明:ファイル(+ 署名、試験中)
- robots.txt、運営元の記述:ユーザー起点のフェッチャーは「通常 robots.txt のルールを無視します」(ページ全体への記述)
- GeoIPHub での検証:検証済み
- 確認日:2026-11-09
Claude-Agent (Anthropic)
- UA の断片:Claude-Agent/1.0
- 証明:ファイル(SAIL、TOML 形式で JSON ではない)
- robots.txt、運営元の記述:「Anthropic のロボット(クローラーとフェッチャー)に対する設定はそれぞれ独立しており、個別に管理できます。」(エージェントのページはブラウザ自体の robots.txt の扱いには触れていません)
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
Google-Agent は「Google のインフラ上でホストされたエージェントが、ユーザーの依頼を受けてウェブを操作し、アクションを実行するために使用する」とされています。Claude-Agent については、Anthropic は「完全な文字列ではなく Claude-Agent トークンで照合する」ように述べています。
そのどれにも当てはまらない AI ボットはどれですか?
3 つあり、運営元はそれぞれ別の用途として文書化しています。
OAI-AdsBot (OpenAI)
- UA の断片:OAI-AdsBot/1.0
- 証明:ファイル
- robots.txt、運営元の記述:引用なし(OpenAI のページに該当する記述は見つかりませんでした)
- GeoIPHub での検証:未読み込み
- 確認日:2026-11-09
CCBot (Common Crawl)
- UA の断片:CCBot/2.0
- 証明:ファイル + 逆引き DNS
- robots.txt、運営元の記述:ページには
User-agent: CCBotとDisallow: /が示されている - GeoIPHub での検証:検証済み(カテゴリ
archiver) - 確認日:2026-11-09
Google-CloudVertexBot (Google)
- UA の断片:Google-CloudVertexBot
- 証明:ファイル(Google の共通クローラーファイル)
- robots.txt、運営元の記述:引用なし
- GeoIPHub での検証:検証済み(共通クローラーファイルを共有)
- 確認日:2026-11-09
OAI-AdsBot は「ChatGPT に広告として提出されたウェブページの安全性を検証するために使用される」とされています。Google-CloudVertexBot は「Vertex AI Agents を構築するため、サイト所有者の依頼に基づいてクロールする」とされています。Common Crawl は「CCBot を偽って名乗るクローラーがあることを把握しています」と述べています。Cloudflare の AI Crawl Control のリファレンスは CCBot を AI クローラーとして挙げていますが、学習との結び付けはサードパーティによるもので、Common Crawl によるものではありません。
各用途のボットをブロックするとどうなるかは、AI クローラーのブロックで解説しています。
ユーザー起点のボットの robots.txt の扱いは、運営元自身の言葉でもそれぞれ異なる
ChatGPT-User、Perplexity-User、Claude-User のような AI のユーザー起点ボットは、共通の robots.txt ルールを持っているわけではありません。運営元ごとに言っていることが違い、1 社は特別なことを何も述べていません。多くの運営元が挙げる理由は、このフェッチが 1 人のユーザーのために動くものだ、という点です。
- ChatGPT-User (OpenAI):「これらの動作はユーザーが開始するため、robots.txt のルールが適用されない場合があります。」
- Perplexity-User (Perplexity):「ユーザーがフェッチを依頼したため、このフェッチャーは通常 robots.txt のルールを無視します。」
- Google-Agent を含むユーザー起点のフェッチャー (Google):「ユーザーがフェッチを依頼したため、これらのフェッチャーは通常 robots.txt のルールを無視します。」
- meta-externalfetcher (Meta):「ユーザーが依頼したフェッチを行うため、robots.txt を回避することがあります」
- Amzn-User (Amazon):「Amzn-User の動作はユーザーが開始することがあるため、robots.txt のすべてのディレクティブに従うとは限りません。」
- Kimi-User (Moonshot):「動作はユーザー起点のため、robots.txt のルールが直接適用されない場合があります」
- MistralAI-User (Mistral):「MistralAI-User は、これらのユーザーのリクエストをどのサイトに対して行えるかを制御します。」
- Claude-User (Anthropic):「Anthropic のボットは、robots.txt の業界標準ディレクティブを尊重することで『クロール禁止』のシグナルを尊重します。」および「Claude-User により、サイト所有者は、これらのユーザー起点のリクエストでどのサイトにアクセスできるかを制御できます。」
Anthropic は例外です。その文にはユーザー起点の除外がありません。「適用されない場合がある」「通常無視する」「回避することがある」「すべてに従うとは限らない」は強さの異なる 4 つの表現であり、グループ全体に 1 つのルールを当てはめると、ほとんどを誤って伝えることになります。
IP レンジを公開している AI クローラーはどれですか? 10 の運営元による 22 のレンジファイル
10 の運営元が、確認できた AI ボット向けに 22 のレンジファイルを公開しており、GeoIPHub はそのうち 17 を読み込んでいます。これらの AI クローラー IP レンジには 4 つの状態があります。OpenAI、Perplexity、Mistral、Google のエージェント用ファイルは、ボットごとに 1 つの JSON ファイルを提供しています。Anthropic の 3 つのボットは 1 つのファイルを共有しており、Kimi の 3 ファイルと DuckDuckGo の 2 ファイルはバイト単位で同一です。Amazon の 3 つのボットは Web ページのみで、それぞれに独自の creationTime があります。Meta と MistralAI-Training は何も公開しておらず、前のセクションの運営元についてはファイルを見つけられませんでした。Claude-Agent はより新しい形式で、claude.com/.well-known/sail にある TOML ファイルとして公開しています(draft-kelley-webbotauth-sail-00)。 ClaudeBot と PerplexityBot の IP レンジでは、各ファイルから実在のルックアップを 1 件ずつたどります。
GeoIPHub は 10 の運営元の公式レンジファイルを 19 読み込んでいます。そのうち 17 がこのリストにあります。残りの 2 つは、下記の DuckDuckGo のファイルと同一の duckduckbot.json と、AI ボットではない Ahrefs です。22 のファイルは、重複を除くと 20 のリストです。2026 年 11 月 9 日 09:51 UTC に取得し、すべて HTTP 200 でした。
1. GPTBot
- ファイル:gptbot.json
- IPv4 / IPv6 プレフィックス:18 / 0
creationTime:2026-09-22- 読み込み:はい
2. OAI-SearchBot
- ファイル:searchbot.json
- IPv4 / IPv6 プレフィックス:39 / 0
creationTime:2026-01-02- 読み込み:はい
3. ChatGPT-User
- ファイル:chatgpt-user.json
- IPv4 / IPv6 プレフィックス:237 / 0
creationTime:2026-11-06- 読み込み:はい
4. OAI-AdsBot
- ファイル:adsbot.json
- IPv4 / IPv6 プレフィックス:2 / 0
creationTime:2026-05-12- 読み込み:いいえ
5. ClaudeBot, Claude-User, Claude-SearchBot
- ファイル:bots.json
- IPv4 / IPv6 プレフィックス:14 / 0
creationTime:2026-10-20- 読み込み:はい
6. Claude-Agent
- ファイル:sail (TOML)
- IPv4 / IPv6 プレフィックス:9 / 0
creationTime:更新日 2026-10-22- 読み込み:いいえ
7. Googlebot と共通クローラー(Google-CloudVertexBot を含む)
- ファイル:common-crawlers.json
- IPv4 / IPv6 プレフィックス:170 / 147
creationTime:2026-11-06- 読み込み:はい
8. 特殊用途クローラー
- ファイル:special-crawlers.json
- IPv4 / IPv6 プレフィックス:136 / 136
creationTime:2026-11-06- 読み込み:はい
9. ユーザー起点のフェッチャー
- ファイル:user-triggered-fetchers.json
- IPv4 / IPv6 プレフィックス:544 / 544
creationTime:2026-11-06- 読み込み:はい
10. ユーザー起点のフェッチャー(google.com)
- ファイル:user-triggered-fetchers-google.json
- IPv4 / IPv6 プレフィックス:252 / 252
creationTime:2026-11-06- 読み込み:はい
11. Google-Agent
- ファイル:user-triggered-agents.json
- IPv4 / IPv6 プレフィックス:12 / 8
creationTime:2026-11-06- 読み込み:はい
12. PerplexityBot
- ファイル:perplexitybot.json
- IPv4 / IPv6 プレフィックス:13 / 0
creationTime:2026-10-28- 読み込み:はい
13. Perplexity-User
- ファイル:perplexity-user.json
- IPv4 / IPv6 プレフィックス:10 / 0
creationTime:2026-10-28- 読み込み:はい
14. MistralAI-User
- ファイル:mistralai-user-ips.json
- IPv4 / IPv6 プレフィックス:4 / 0
creationTime:2025-02-19- 読み込み:はい
15. MistralAI-Index
- ファイル:mistralai-index-ips.json
- IPv4 / IPv6 プレフィックス:2 / 0
creationTime:2026-04-19- 読み込み:はい
16. Bingbot
- ファイル:bingbot.json
- IPv4 / IPv6 プレフィックス:29 / 0
creationTime:2024-01-03- 読み込み:はい
17. Applebot
- ファイル:applebot.json
- IPv4 / IPv6 プレフィックス:24 / 0
creationTime:2026-09-15- 読み込み:はい
18. DuckAssistBot(duckduckbot.json と同じリスト)
- ファイル:duckassistbot.json
- IPv4 / IPv6 プレフィックス:486 / 0
creationTime:2026-09-01- 読み込み:はい
19. CCBot
- ファイル:ccbot.json
- IPv4 / IPv6 プレフィックス:4 / 1
creationTime:2026-08-11- 読み込み:はい
20. KimiBot
- ファイル:kimibot.json
- IPv4 / IPv6 プレフィックス:4 / 0
creationTime:2026-05-18- 読み込み:いいえ
21. Kimi-User
- ファイル:kimi-user.json
- IPv4 / IPv6 プレフィックス:4 / 0
creationTime:2026-05-18- 読み込み:いいえ
22. Kimi-SearchBot
- ファイル:kimi-searchbot.json
- IPv4 / IPv6 プレフィックス:4 / 0
creationTime:2026-05-18- 読み込み:いいえ
ファイルの日付は、リストが変わっていないことの証明にはなりません。Bingbot のファイルは、日付が 2024-01-03 のまま、プレフィックスが 28 から 29 に増えました。10 月 29 日の記事では 28、11 月 9 日には 29 と数えましたが、それ以前のコピーがないため、どのプレフィックスが追加されたのかは分かりません。Google の特殊用途ファイルとユーザー起点ファイルには AI 以外のフェッチャーも含まれており、Google は AI のフェッチャーをそこに載せています。
Amazon の 3 つのページはファイルではありません。developer.amazon.com/amazonbot/ip-addresses/(Amazonbot)、.../searchbot-ip-addresses/(Amzn-SearchBot)、.../live-ip-addresses/(Amzn-User)には、埋め込まれた creationTime の値としてそれぞれ 2026-09-08、2026-09-08、2025-11-04 があります。GeoIPHub はこれらを読み込んでいません。DuckDuckGo の 2 ファイルは MD5 ハッシュが同じで、Kimi の 3 ファイルも同様です。Anthropic の 1 つのファイルは 3 つのボットをカバーしており、Anthropic は「クローラーの送信元 IP アドレスがこのリストにある場合、そのクローラーは Anthropic から来ていることを示します。」と述べています。
この日付の時点で、gptbot.json と searchbot.json では 6 つのプレフィックスが同一です。4.227.36.0/25、74.7.175.128/25、74.7.228.0/25、74.7.230.0/25、74.7.241.128/25、74.7.244.0/25 です。chatgpt-user.json にはこれらと共通するものはありません。これらのファイルから許可リストを作る方法は、検証済みクローラー IP リストで紹介しています。
GeoIPHub が検証できる AI ボットは? 11 月 9 日時点で 29 のうち 16
GeoIPHub の API は、読み込んでいるファイルの範囲内にアドレスがあれば検証済みとしますが、それが証明するのは運営元であり、ボットではありません。読み込んでいる 17 ファイルのうち 14(Google の特殊用途ファイルと 2 つのユーザー起点フェッチャーファイルを除くすべて)から実在のアドレスを 1 つずつ取り、さらに対照用の 3 例を加えて、キーなしで約 14 秒間隔で、2026 年 11 月 9 日の 09:52 から 09:55 UTC に照会しました。検証済みの照会はすべて、verification_method: "ip_range_list"、scoring.recommended_action: "allow"、そして 0 の fraud_score も返しました。
OAI-SearchBot
- アドレス(ファイルより):4.227.36.1 (searchbot.json と gptbot.json)
verified:truename:OAISearchBotoperator:OpenAIcategory:ai- UTC:09:52:11
GPTBot
- アドレス(ファイルより):132.196.86.1 (gptbot.json)
verified:truename:GPTBotoperator:OpenAIcategory:ai- UTC:09:52:25
ChatGPT-User
- アドレス(ファイルより):104.208.184.193
verified:truename:ChatGPTUseroperator:OpenAIcategory:ai- UTC:09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- アドレス(ファイルより):216.73.216.10 (bots.json)
verified:truename:ClaudeBotoperator:Anthropiccategory:ai- UTC:09:52:52
PerplexityBot
- アドレス(ファイルより):107.20.236.150
verified:truename:PerplexityBotoperator:Perplexitycategory:ai- UTC:09:53:06
Perplexity-User
- アドレス(ファイルより):18.97.43.80
verified:truename:PerplexityUseroperator:Perplexitycategory:ai- UTC:09:53:20
MistralAI-User
- アドレス(ファイルより):20.240.160.161
verified:truename:MistralAIUseroperator:Mistralcategory:ai- UTC:09:53:33
MistralAI-Index
- アドレス(ファイルより):135.225.57.92
verified:truename:MistralAIIndexoperator:Mistralcategory:ai- UTC:09:53:47
Google-Agent
- アドレス(ファイルより):136.121.16.1
verified:truename:GoogleUserTriggeredAgentoperator:Googlecategory:ai- UTC:09:54:01
Google-CloudVertexBot
- アドレス(ファイルより):192.178.4.1 (common-crawlers.json)
verified:truename:Googlebotoperator:Googlecategory:search_engine- UTC:09:54:15
DuckAssistBot
- アドレス(ファイルより):104.43.54.127
verified:truename:DuckAssistBotoperator:DuckDuckGocategory:ai- UTC:09:54:30
CCBot
- アドレス(ファイルより):18.97.9.169
verified:truename:CCBotoperator:CommonCrawlcategory:archiver- UTC:09:54:46
Applebot
- アドレス(ファイルより):17.241.208.161
verified:truename:Applebotoperator:Applecategory:search_engine- UTC:09:55:00
Bingbot
- アドレス(ファイルより):157.55.39.1
verified:truename:Bingbotoperator:Microsoftcategory:search_engine- UTC:09:55:14
OAI-AdsBot(ファイル未読み込み)
- アドレス(ファイルより):130.131.229.129 (adsbot.json)
verified:false、is_crawler: falsename:なしoperator:なしcategory:なし- UTC:09:55:28
Amazonbot(ページ未読み込み)
- アドレス(ファイルより):3.81.245.78(Amazon のページ)
verified:false、is_crawler: falsename:なしoperator:なしcategory:なし- UTC:09:55:42
Meta(ネットワーク、ファイルなし)
- アドレス(ファイルより):31.13.64.1
verified:false、unverified: truename:Facebook-Botoperator:Metacategory:social_preview- UTC:09:55:56
落とし穴は name フィールドにあります。name は最後に読み込まれたファイルのラベルなので、Anthropic の 3 つのボットはすべて ClaudeBot を返し、DuckDuckBot のアドレスは DuckAssistBot を返し、Google-CloudVertexBot は Googlebot を返します。category は用途を表すフィールドではありません。CCBot は archiver を返し、Applebot と Bingbot は search_engine を返します。名乗ったトークンと operator をキーにし、CommonCrawl はスペースなしで書いてください。
意外だったのは 4.227.36.1 です。これは 4.227.36.0/25 の中にあり、このプレフィックスは gptbot.json と searchbot.json の両方に載っています。実際のレスポンスを抜粋したものは次のとおりです。
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
GPTBot のリクエストが OAISearchBot を返すと言っているわけではありません。両方のファイルに含まれるアドレスがその名前を返しているのであり、GeoIPHub のルックアップは、どのボットがリクエストを送ったかを判別できません。OpenAI 自身も「1 回のクロール結果を両方の用途に使うことがあります」(原文: "may use the results from just one crawl for both use cases")と述べています。IP が証明するのは OpenAI であり、どのボットかを示すのは User-Agent です。OpenAI の各ボットの役割は、OpenAI の記事で解説しています。
未読み込みのケースは単純です。OAI-AdsBot のファイルは公開されていて 130.131.229.129 もその中にありますが、GeoIPHub の API は is_crawler: false とホスティングの結果(スコア 15、allow、AS8075 Microsoft)を返します。Amazonbot 自身のページには 3.81.245.78 が載っており、API は同種の結果(スコア 16、allow、AS14618 Amazon)を返します。GeoIPHub のデータには、本物の OAI-AdsBot をそのクラウド上のほかのアドレスと区別する材料がありません。Meta の 31.13.64.1 は Meta のネットワーク(AS32934)上のアドレスで、verified: false です。クロールしている様子は確認していません。
API は、どのファイルに一致したかも、そのファイルをいつ取得したかも返しません。また、ルックアップがあなたの User-Agent を目にすることはありません。フィールドの詳細はクローラーのフィールドにあります。ログのアドレスとその User-Agent をクローラー IP 検証ツールに貼り付けることもできます。このツールは threat.crawler.verified を読み取り、運営元と User-Agent が名乗る bot をブラウザー内で比較します。
ログの IP を正しいファイルと照合する
このスニペットは、ログ 1 行の IP とそれが名乗る User-Agent を受け取り、User-Agent が示すボットのファイルだけを読み込んで、そのアドレスがファイルに含まれているかどうかと、ほかにどのファイルが同じアドレスを載せているかを報告します。許可や拒否の判断は行わず、リストも書き出しません。これはサンプルであってパーサーではありません。ボットトークンが 2 つ含まれる User-Agent では、最も長いものに一致します。
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
各ログ行の形式は <ip> <User-Agent> です。2026 年 11 月 9 日 10:01 UTC に次のサンプルで実行しました。45.33.32.156 は Nmap の公開スキャン用ホストです(そのようなリクエストは送っていません)。203.0.113.9 と 2001:db8::1 はドキュメント用のアドレスです。
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
OAI-AdsBot がここで通るのは、GeoIPHub の API が読み込んでいなくても、スニペットがファイルそのものを読むからです。User-Agent トークン 1 つにつきファイル 1 つを対応させるのは、Perplexity のルールに従っています。「各ボットには独自の IP レンジがあるため、各 User-Agent をそれぞれ自身の IP レンジと照合してください。」ファイルに到達できない場合は「not verified」であり、「verified」にはなりません。SSL_CERT_FILE を存在しないパスに向けると、すべての行が not verified: ... file unavailable と表示されました。不正な IP 文字列は、実行を止めずに「not verified」と表示します。スニペットが独自の User-Agent を設定しているのは、2026 年 11 月 9 日に claude.com が Python のデフォルトの User-Agent に 403 を返した一方、ほかのファイルは 200 を返したためです。
ファイルがないボットについては、AI クローラーとエージェントを検証する方法で逆引き DNS と署名の手法を解説しています。Google は「Web Bot Auth プロトコルも試験している」と述べ、https://agent.bot.goog の ID を使っています。YouBot は署名ディレクトリを公開しています。
ログに現れない名前と、出典を確認できなかったボット
ほかのリストにある名前の中には、クローラーではないものや、開くことのできる運営元のページがないものがあります。うち 3 つは、リクエスト元として現れることのない制御用トークンなので、ログに記録することも、IP で検証することもできません。
Google-Extended (Google)
- ログに現れる?:いいえ
- 運営元の記述:「Google-Extended には個別の HTTP リクエスト用 user agent 文字列がありません。クロールは Google の既存の user agent 文字列で行われ、robots.txt の user-agent トークンは制御の目的で使用されます。」
- 尊重する側:Google
Applebot-Extended (Apple)
- ログに現れる?:いいえ
- 運営元の記述:「Applebot-Extended はウェブページをクロールしません。」および「Applebot-Extended は、Applebot user agent がクロールしたデータをどのように使用するかを決めるためだけに使用されます。」
- 尊重する側:Apple
__usage_ai-training (共有(IETF aipref ドラフト))
- ログに現れる?:いいえ、robots.txt のグループ名である
- 運営元の記述:Microsoft: 「2027 年 2 月 1 日から、Microsoft はクロールの際に新しい設定を尊重します」。Google: 「2027 年初頭に、AIPREF の共有された機械可読な学習設定シグナル(『user-agent: __usage_ai-training』を使用)のサポートを予定しています」。Anthropic: 「2026 年 10 月 30 日時点で、Anthropic は機械可読なシグナルの認識を開始しました」
- 尊重する側:Anthropic は 2026-10-30 から(ページにはトークン名の記載なし)、Microsoft は 2027-02-01 から、Google は「2027 年初頭」(予定)、OpenAI は未確認
Anthropic のページは、このシグナルは「IETF の aipref ワーキンググループでの作業に基づくドラフト」("a draft based on work done by the IETF ... in its aipref working group")に基づいていると述べています。OpenAI のヘルプページは開けなかったため、OpenAI については何も主張しません。
2026 年 11 月 9 日の時点で、以下のボットについては運営元が運営するページを見つけられませんでした。このリストは、何を確認したかを示しています。ここに載っていないボットが存在する可能性はあり、これらの運営元がクローラーを運用していないと言っているわけではありません。
ByteDance: Bytespider
- 2026-11-09 に確認したもの:bytedance.com/robots.txt、bytedance.com/en/bytespider (404)、bytespider.bytedance.com(DNS なし)、zhanzhang.toutiao.com のトップページ(クローラーに関する記載なし)
- 結果:ByteDance のページは見つかりませんでした。レンジが存在するかどうかはサードパーティの間でも意見が分かれているため、用途もレンジも記載しません
xAI: Grok 関連のトークン
- 2026-11-09 に確認したもの:docs.x.ai/llms.txt(クローラーや robots.txt に関する記載なし)、docs.x.ai/docs/crawler (404)、x.ai/grok-bot.json (403)
- 結果:何も見つかりませんでした
Cohere: cohere-ai、cohere-training-data-crawler
- 2026-11-09 に確認したもの:docs.cohere.com/docs/cohere-web-crawlers(開ける。ボットの表は「N/A」)、cohere.com/crawler (404)、cohere.com/cohere-ai.json (404)
- 結果:ページには次のようにあります。「現時点では、生成 AI の基盤モデルを学習する目的で、ウェブコンテンツをクロールまたはスクレイピングするために Cohere のボットや user agent を使用していません。」
DeepSeek: DeepSeekBot
- 2026-11-09 に確認したもの:deepseek.com/robots.txt、api-docs.deepseek.com/llms.txt(一致なし)、deepseek.com/deepseekbot.json (404)
- 結果:何も見つかりませんでした
古くなっている名前もあります。anthropic-ai と Claude-Web は Anthropic のページになく、FacebookBot は Meta のページになく、Gemini-Deep-Research は読んだ 4 つの Google クローラーページのどれにも出てきません。読んだページには文書化されていないため、これらをボットとして一覧に載せることはしません。
このリストの確認方法と、更新のされ方
GeoIPHub は、各運営元のページを開き、各ファイルを取得し、数え直し、上記のルックアップを実行して、この AI クローラーリストを確認しました。項目の日付が変わるのは、その項目を再確認したときだけです。
確認した変更を日付とともに挙げます。Bingbot のファイルは、日付が 2024-01-03 で固定されたまま、28 から 29 のプレフィックスになりました。ChatGPT-User のファイルは 234 のプレフィックスだったものが、10 月 29 日に 235 になり、2026 年 11 月 6 日付けのファイルでは 237 になりました。Perplexity の 2 つのファイルは、10 月 27 日には 4 と 8 のプレフィックスで、10 月 28 日には 10 と 13 でした。Anthropic のファイルは、AI クローラーのブロックに関する記事の時点では 38 のプレフィックス(ファイルの日付は 10 月 7 日)でしたが、現在は 14 で、日付は 10 月 20 日です。運営元についても GeoIPHub の API についても、更新スケジュールは明示していません。API は取得日を返さないため、運営元が最近追加したプレフィックスはまだ検証できない場合があります。
ヘッダーの名前は主張にすぎず、運営元がファイルを公開している場合は、そのファイルが証明です。
よくある質問
AI クローラーリストとは何ですか?
AI 企業や検索プロダクトがウェブページを取得するために動かしている自動クライアントの一覧です。各クライアントの User-Agent、役割(学習、検索、ユーザー起点のフェッチ、エージェント)、そしてどのように証明できるかを載せています。2026 年 11 月 9 日時点で、GeoIPHub のリストには運営元が文書化している 29 のボットがあり、GeoIPHub の API はそのうち 16 を IP で検証します。
GPTBot と ClaudeBot の違いは何ですか?
GPTBot は OpenAI の学習用クローラー、ClaudeBot は Anthropic の学習用クローラーです。どちらもレンジファイルを公開しており、Anthropic の 1 つのファイルは Claude-User と Claude-SearchBot もカバーしています。GeoIPHub の API は、どちらのファイルのアドレスでも検証できます。OpenAI の各ボットの役割は GPTBot vs OAI-SearchBot vs ChatGPT-User で解説しています。
IP レンジを公開している AI クローラーはどれですか?
2026 年 11 月 9 日時点で、10 の運営元が、確認できた AI ボット向けに 22 のレンジファイルを公開しています。OpenAI、Anthropic、Google、Perplexity、Mistral、Microsoft、Apple、DuckDuckGo、Common Crawl、Moonshot です。GeoIPHub はそのうち 17 を読み込んでいます。Amazon はアドレスを Web ページに掲載しており、Meta と MistralAI-Training は何も公開していません。
User-Agent で AI クローラーを検証できますか?
できません。User-Agent はどのクライアントでも送れる文字列です。GeoIPHub のルックアップが受け取るのは IP だけです。そのアドレスが OpenAI や Anthropic のファイルに含まれているかどうかは分かりますが、その運営元と User-Agent が名乗るボットを突き合わせる処理は、自社のコードで行います。
Meta の AI クローラーはどの User-Agent を使いますか?
Meta は、学習用に meta-externalagent/1.1、Meta AI の検索用に meta-webindexer/1.1、ユーザーが依頼したフェッチ用に meta-externalfetcher/1.1 を文書化しています。Meta はレンジファイルを公開していないため、GeoIPHub はそのネットワークを ASN で照合し、verified: false を返します。
CCBot は AI クローラーですか?
CCBot は Common Crawl のクローラーで、Common Crawl はそのために IP ファイルと逆引き DNS を公開しています。ほかのリストが AI クローラーとして扱うのは、CCBot が構築するアーカイブが学習に使われうるからです。この結び付けはそれらのリストのものであり、Common Crawl 自身の見解ではありません。GeoIPHub はそのファイルを検証し、カテゴリ archiver を返します。
GeoIPHub API を支えるチーム
GeoIPHub IP インテリジェンス API とそのスキャナーを開発している GeoIPHub チームが執筆しています。下書きは AI の支援を受けて作成し、チームが編集しています。API の例は、「説明用」と明記したものを除き、本番 API に対する実際のルックアップです。