 Seguridad de red
Lista de rastreadores de IA: User-Agents de 29 bots y cuáles puedes verificar por IP
Una lista de rastreadores de IA con 29 bots por función, con User-Agents, texto de robots.txt y archivos de rangos, y los 16 que GeoIPHub verifica por IP, comprobada el 9 de noviembre de 2026.
Alcance: los bots que un operador documenta en una página que pudimos abrir el 9 de noviembre de 2026, tal como se usan para IA. Meta también documenta meta-externalads, un rastreador de anuncios, que no contamos. Los nombres que circulan en otras listas sin documentación del operador están en una lista aparte, con lo que comprobamos.
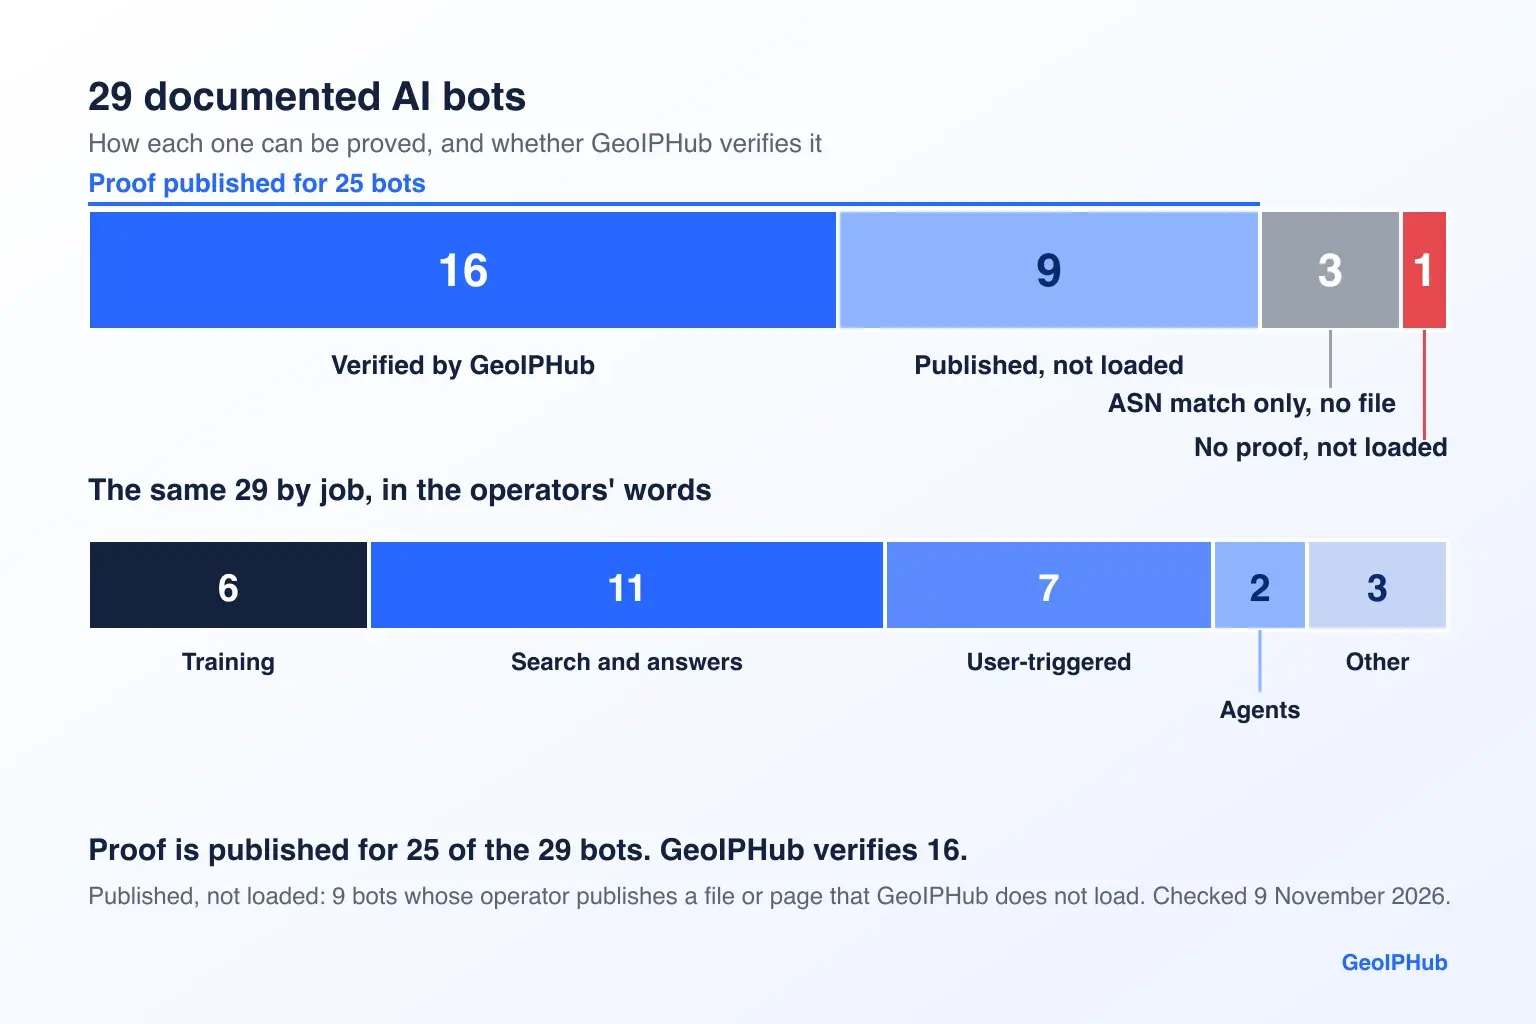
Los operadores publican una forma de demostrar la identidad de 25 de estos 29 bots. La API de GeoIPHub verifica 16. Los otros nueve no son una laguna en lo que documentan los operadores: son archivos y páginas que no cargamos, y la lista indica cuáles.
Otras listas dan nombres y tokens, pero un nombre en una cabecera User-Agent no demuestra nada, porque cualquiera puede escribirlo. La prueba de los operadores adopta cinco formas: un archivo JSON, una página web de direcciones, DNS inverso, una firma o nada. Esta entrada forma parte de nuestro trabajo sobre la detección de bots por IP. A continuación: cada bot por función, los 22 archivos de rangos con sus recuentos y fechas, lo que devolvió la API de GeoIPHub para una dirección real de 14 de los archivos que cargamos, un fragmento que comprueba una línea de registro contra el archivo correcto, y los nombres que nunca llegan a tus registros o que no pudimos documentar.
La lista de rastreadores de IA: 29 bots por función
Esta lista de rastreadores de IA ordena 29 bots documentados y sus user agents según la función que declara su operador: entrenamiento, búsqueda, obtención activada por el usuario, agentes y un breve grupo que no es ninguna de ellas. En todas las entradas se usan cuatro términos. Prueba significa lo que publica el operador: un archivo de rangos, una página web de direcciones, DNS inverso, una firma o nada. Verificado significa que una dirección del archivo propio de ese bot devolvió verified: true en la API de GeoIPHub en la fecha indicada. Solo coincidencia por ASN significa que reconocemos la red del operador y devolvemos verified: false. No cargado significa que no cargamos la lista del operador.
La agrupación sigue las palabras de los operadores y no es nítida. OpenAI dice «If your site has allowed both bots, we may use the results from just one crawl for both use cases» (si tu sitio ha permitido ambos bots, podemos usar los resultados de un solo rastreo para ambos casos de uso). Meta dice «use cases such as training» (casos de uso como el entrenamiento). Amazon dice «may be used to train» (puede usarse para entrenar). El rastreador de Apple es primero de búsqueda y «may also be used to help train» (también puede usarse para ayudar a entrenar) sus modelos. La documentación de bots de Cloudflare traza la misma división en tres: Search («Crawling to build search indexes or RAG databases», rastreo para construir índices de búsqueda o bases de datos RAG), Agent («User-directed agents visiting a page on behalf of a human», agentes dirigidos por el usuario que visitan una página en nombre de una persona) y Training («Crawling to train or fine-tune models», rastreo para entrenar o ajustar modelos).
¿Qué rastreadores de IA entrenan modelos?
Seis, según las propias palabras de sus operadores.
GPTBot (OpenAI)
- Fragmento de UA: GPTBot/1.4
- Prueba: archivo
- robots.txt, palabras del operador: «Disallowing GPTBot indicates a site’s content should not be used in training generative AI foundation models.» (Bloquear GPTBot indica que el contenido de un sitio no debe usarse para entrenar modelos fundacionales de IA generativa.)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
ClaudeBot (Anthropic)
- Fragmento de UA: ClaudeBot
- Prueba: archivo (compartido)
- robots.txt, palabras del operador: «Anthropic's Bots respect «do not crawl» signals by honoring industry standard directives in robots.txt.» (Los bots de Anthropic respetan las señales de «no rastrear» al acatar las directivas estándar del sector en robots.txt.)
- Verificado por GeoIPHub: verificado (como Anthropic)
- Comprobado: 2026-11-09
MistralAI-Training (Mistral)
- Fragmento de UA: MistralAI-Training/1.0
- Prueba: ninguna
- robots.txt, palabras del operador: «Webmasters can disallow this user agent in their robots.txt file.» (Los webmasters pueden bloquear este user agent en su archivo robots.txt.)
- Verificado por GeoIPHub: no cargado (mistralai-training-ips.json devuelve 404)
- Comprobado: 2026-11-09
meta-externalagent (Meta)
- Fragmento de UA: meta-externalagent/1.1
- Prueba: ninguna
- robots.txt, palabras del operador: «In order to block these crawlers, add a disallow for the relevant crawler to robots.txt.» (Para bloquear estos rastreadores, añade un disallow para el rastreador correspondiente en robots.txt.)
- Verificado por GeoIPHub: solo coincidencia por ASN, sin verificar
- Comprobado: 2026-11-09
Amazonbot (Amazon)
- Fragmento de UA: Amazonbot/0.1
- Prueba: solo página web
- robots.txt, palabras del operador: «Automated crawling from these listed user agents respects the Robots Exclusion Protocol, honoring the user-agent and the allow/disallow directives.» (El rastreo automatizado de estos user agents listados respeta el Protocolo de exclusión de robots y acata el user-agent y las directivas allow/disallow.)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
KimiBot (Moonshot)
- Fragmento de UA: KimiBot/1.0
- Prueba: archivo (un archivo, tres nombres)
- robots.txt, palabras del operador: no citado
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
Propósito, en palabras de los operadores: GPTBot se «used to crawl content that may be used in training our generative AI foundation models» (usa para rastrear contenido que puede usarse para entrenar nuestros modelos fundacionales de IA generativa). MistralAI-Training «crawls web content to help build datasets for training Mistral generative AI models» (rastrea contenido web para ayudar a construir conjuntos de datos con los que entrenar los modelos de IA generativa de Mistral). KimiBot «crawls content potentially used to train Kimi's foundation models» (rastrea contenido que potencialmente se usa para entrenar los modelos fundacionales de Kimi).
¿Qué rastreadores de IA alimentan la búsqueda y las respuestas?
Once, incluidos dos rastreadores de búsqueda clásicos que están en nuestro conjunto cargado.
OAI-SearchBot (OpenAI)
- Fragmento de UA: OAI-SearchBot/1.4
- Prueba: archivo
- robots.txt, palabras del operador: «Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers» (Los sitios que se excluyan de OAI-SearchBot no se mostrarán en las respuestas de búsqueda de ChatGPT)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
Claude-SearchBot (Anthropic)
- Fragmento de UA: Claude-SearchBot
- Prueba: archivo (compartido)
- robots.txt, palabras del operador: la misma frase de Anthropic que para ClaudeBot
- Verificado por GeoIPHub: verificado (como Anthropic)
- Comprobado: 2026-11-09
PerplexityBot (Perplexity)
- Fragmento de UA: PerplexityBot/1.0
- Prueba: archivo
- robots.txt, palabras del operador: no citado
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
MistralAI-Index (Mistral)
- Fragmento de UA: MistralAI-Index/1.0
- Prueba: archivo
- robots.txt, palabras del operador: no citado
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
meta-webindexer (Meta)
- Fragmento de UA: meta-webindexer/1.1
- Prueba: ninguna
- robots.txt, palabras del operador: la misma frase de Meta que para meta-externalagent
- Verificado por GeoIPHub: solo coincidencia por ASN, sin verificar
- Comprobado: 2026-11-09
Amzn-SearchBot (Amazon)
- Fragmento de UA: Amzn-SearchBot/0.1
- Prueba: solo página web
- robots.txt, palabras del operador: «If robots.txt files don't mention Amzn-SearchBot but allow other search bots, Amzn-SearchBot will crawl in accordance with the robots.txt directives given to other search bots.» (Si los archivos robots.txt no mencionan a Amzn-SearchBot pero permiten a otros bots de búsqueda, Amzn-SearchBot rastreará conforme a las directivas de robots.txt dadas a otros bots de búsqueda.)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
Applebot (Apple)
- Fragmento de UA: Applebot/0.1
- Prueba: archivo + DNS inverso
- robots.txt, palabras del operador: «Applebot respects standard robots.txt directives in general search crawls that are targeted at Applebot.» (Applebot respeta las directivas estándar de robots.txt en los rastreos de búsqueda generales dirigidos a Applebot.)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
Bingbot (Microsoft)
- Fragmento de UA: Bingbot
- Prueba: archivo
- robots.txt, palabras del operador: no citado (la página de Microsoft necesita JavaScript, así que no pudimos leerla)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
DuckAssistBot (DuckDuckGo)
- Fragmento de UA: DuckAssistBot/1.2
- Prueba: archivo
- robots.txt, palabras del operador: «Once you've updated the file to disallow the DuckAssistBot user agent, the change will take effect after 72 hours and DuckAssistBot will stop crawling your site.» (Una vez que actualices el archivo para bloquear el user agent DuckAssistBot, el cambio surtirá efecto tras 72 horas y DuckAssistBot dejará de rastrear tu sitio.)
- Verificado por GeoIPHub: verificado (las direcciones de DuckDuckBot también devuelven este nombre)
- Comprobado: 2026-11-09
Kimi-SearchBot (Moonshot)
- Fragmento de UA: Kimi-SearchBot/1.0
- Prueba: archivo (compartido)
- robots.txt, palabras del operador: no citado
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
YouBot (You.com)
- Fragmento de UA: YouBot/1.0
- Prueba: firma + DNS inverso + solo página web (un /24)
- robots.txt, palabras del operador: «It respects robots.txt directives and crawl rate preferences» (Respeta las directivas de robots.txt y las preferencias de velocidad de rastreo)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
Bingbot y Applebot están aquí porque están en nuestro conjunto cargado y Apple dice que su rastreador puede ayudar a entrenar sus modelos. No pudimos leer la página de rastreadores de Microsoft, que necesita JavaScript, pero su entrada del 30 de octubre establece las preferencias de IA mediante Bingbot. YouBot es la única entrada con tres pruebas: un directorio de firmas en you.com/.well-known/http-message-signatures-directory, DNS inverso con la forma youbot-68-67-112-106 y la declaración «Legitimate YouBot requests originate from 68.67.112.0/24.» (Las solicitudes legítimas de YouBot proceden de 68.67.112.0/24.)
Propósito, en palabras de los operadores: PerplexityBot está «designed to surface and link websites in search results on Perplexity. It is not used to crawl content for AI foundation models.» (diseñado para mostrar y enlazar sitios web en los resultados de búsqueda de Perplexity. No se usa para rastrear contenido para modelos fundacionales de IA.) MistralAI-Index es «for automated crawling of the web for indexing purposes only» (para el rastreo automatizado de la web solo con fines de indexación). DuckAssistBot «crawls pages in real-time for our AI-assisted answers» (rastrea páginas en tiempo real para nuestras respuestas asistidas por IA) y «This data is not used in any way to train AI models.» (Estos datos no se usan de ninguna manera para entrenar modelos de IA.)
¿Qué rastreadores de IA obtienen una página porque un usuario lo pidió?
Siete, además de los fetchers activados por el usuario de Google.
ChatGPT-User (OpenAI)
- Fragmento de UA: ChatGPT-User/1.0
- Prueba: archivo
- robots.txt, palabras del operador: «Because these actions are initiated by a user, robots.txt rules may not apply.» (Como un usuario inicia estas acciones, es posible que las reglas de robots.txt no se apliquen.)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
Claude-User (Anthropic)
- Fragmento de UA: Claude-User
- Prueba: archivo (compartido)
- robots.txt, palabras del operador: la frase de Anthropic para todos sus bots (véase ClaudeBot); no encontramos ninguna excepción para lo activado por el usuario
- Verificado por GeoIPHub: verificado (como Anthropic)
- Comprobado: 2026-11-09
Perplexity-User (Perplexity)
- Fragmento de UA: Perplexity-User/1.0
- Prueba: archivo
- robots.txt, palabras del operador: «Since a user requested the fetch, this fetcher generally ignores robots.txt rules.» (Como un usuario solicitó la obtención, este fetcher generalmente ignora las reglas de robots.txt.)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
MistralAI-User (Mistral)
- Fragmento de UA: MistralAI-User/1.0
- Prueba: archivo
- robots.txt, palabras del operador: «MistralAI-User governs which sites these user requests can be made to.» (MistralAI-User rige a qué sitios se pueden dirigir estas solicitudes de usuarios.)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
meta-externalfetcher (Meta)
- Fragmento de UA: meta-externalfetcher/1.1
- Prueba: ninguna
- robots.txt, palabras del operador: «may bypass robots.txt because it performs fetches that were requested by the user» (puede saltarse robots.txt porque realiza obtenciones que solicitó el usuario)
- Verificado por GeoIPHub: solo coincidencia por ASN, sin verificar
- Comprobado: 2026-11-09
Amzn-User (Amazon)
- Fragmento de UA: Amzn-User/0.1
- Prueba: solo página web
- robots.txt, palabras del operador: «Because actions taken by Amzn-User can be initiated by a user, it may not follow all robots.txt directives.» (Como un usuario puede iniciar las acciones de Amzn-User, es posible que no siga todas las directivas de robots.txt.)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
Kimi-User (Moonshot)
- Fragmento de UA: Kimi-User/1.0
- Prueba: archivo (compartido)
- robots.txt, palabras del operador: «because actions are user-triggered, robots.txt rules may not directly apply» (como las acciones las activa el usuario, es posible que las reglas de robots.txt no se apliquen directamente)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
La página de Google también nombra a Google-GeminiNotebook, que «requests individual URLs that Gemini Notebook users have provided as sources» (solicita URL individuales que los usuarios de Gemini Notebook han proporcionado como fuentes). No dice en cuál de los archivos de rangos de Google para lo activado por el usuario figura, así que no pudimos probarlo y lo dejamos fuera de la lista.
¿Qué bots de IA son agentes?
Dos, ambos documentados como agentes que navegan por la web para un usuario.
Google-Agent (Google)
- Fragmento de UA: Google-Agent
- Prueba: archivo (+ firma, en fase de prueba)
- robots.txt, palabras del operador: los fetchers activados por el usuario «generally ignore robots.txt rules» (generalmente ignoran las reglas de robots.txt) (declaración a nivel de página)
- Verificado por GeoIPHub: verificado
- Comprobado: 2026-11-09
Claude-Agent (Anthropic)
- Fragmento de UA: Claude-Agent/1.0
- Prueba: archivo (SAIL, TOML, no JSON)
- robots.txt, palabras del operador: «Your preferences for Anthropic's robots (crawlers and fetchers) are independent and you can manage them separately.» (Tus preferencias para los robots de Anthropic (rastreadores y fetchers) son independientes y puedes gestionarlas por separado.) (la página del agente no aborda robots.txt para el propio navegador)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
Google-Agent es «used by agents hosted on Google infrastructure to navigate the web and perform actions upon user request» (usado por agentes alojados en la infraestructura de Google para navegar por la web y realizar acciones a petición del usuario). Sobre Claude-Agent, Anthropic dice «match on the Claude-Agent token rather than the full string» (compara con el token Claude-Agent en lugar de con la cadena completa).
¿Qué bots de IA no son ninguno de estos?
Tres, cada uno documentado por su operador para una función distinta.
OAI-AdsBot (OpenAI)
- Fragmento de UA: OAI-AdsBot/1.0
- Prueba: archivo
- robots.txt, palabras del operador: no citado (no encontramos ninguna declaración en la página de OpenAI)
- Verificado por GeoIPHub: no cargado
- Comprobado: 2026-11-09
CCBot (Common Crawl)
- Fragmento de UA: CCBot/2.0
- Prueba: archivo + DNS inverso
- robots.txt, palabras del operador: la página da
User-agent: CCBotyDisallow: / - Verificado por GeoIPHub: verificado (categoría
archiver) - Comprobado: 2026-11-09
Google-CloudVertexBot (Google)
- Fragmento de UA: Google-CloudVertexBot
- Prueba: archivo (archivo de rastreadores comunes de Google)
- robots.txt, palabras del operador: no citado
- Verificado por GeoIPHub: verificado (archivo compartido de rastreadores comunes)
- Comprobado: 2026-11-09
OAI-AdsBot se «used to validate the safety of web pages submitted as ads on ChatGPT» (usa para validar la seguridad de las páginas web enviadas como anuncios en ChatGPT). Google-CloudVertexBot «crawls requested by the site owners' for building Vertex AI Agents» (rastrea a petición de los propietarios de sitios para construir Vertex AI Agents). Common Crawl dice «we are aware of crawlers falsely identifying themselves as CCBot» (sabemos que hay rastreadores que se hacen pasar falsamente por CCBot). La referencia de AI Crawl Control de Cloudflare incluye a CCBot como rastreador de IA; ese vínculo con el entrenamiento es de un tercero, no de Common Crawl.
Lo que cuesta bloquear cada función se explica en bloquear rastreadores de IA.
Los bots activados por el usuario tratan robots.txt de forma distinta, según las propias palabras de sus operadores
Los bots de IA activados por el usuario, como ChatGPT-User, Perplexity-User y Claude-User, no comparten una misma regla de robots.txt: cada operador dice algo distinto, y uno no dice nada especial. La obtención actúa en nombre de una persona, que es la razón que dan la mayoría.
- ChatGPT-User (OpenAI): «Because these actions are initiated by a user, robots.txt rules may not apply.» (Como un usuario inicia estas acciones, es posible que las reglas de robots.txt no se apliquen.)
- Perplexity-User (Perplexity): «Since a user requested the fetch, this fetcher generally ignores robots.txt rules.» (Como un usuario solicitó la obtención, este fetcher generalmente ignora las reglas de robots.txt.)
- fetchers activados por el usuario, incluido Google-Agent (Google): «Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules.» (Como un usuario solicitó la obtención, estos fetchers generalmente ignoran las reglas de robots.txt.)
- meta-externalfetcher (Meta): «may bypass robots.txt because it performs fetches that were requested by the user» (puede saltarse robots.txt porque realiza obtenciones que solicitó el usuario)
- Amzn-User (Amazon): «Because actions taken by Amzn-User can be initiated by a user, it may not follow all robots.txt directives.» (Como un usuario puede iniciar las acciones de Amzn-User, es posible que no siga todas las directivas de robots.txt.)
- Kimi-User (Moonshot): «because actions are user-triggered, robots.txt rules may not directly apply» (como las acciones las activa el usuario, es posible que las reglas de robots.txt no se apliquen directamente)
- MistralAI-User (Mistral): «MistralAI-User governs which sites these user requests can be made to.» (MistralAI-User rige a qué sitios se pueden dirigir estas solicitudes de usuarios.)
- Claude-User (Anthropic): «Anthropic's Bots respect «do not crawl» signals by honoring industry standard directives in robots.txt.» (Los bots de Anthropic respetan las señales de «no rastrear» al acatar las directivas estándar del sector en robots.txt.) y «Claude-User allows site owners to control which sites can be accessed through these user-initiated requests.» (Claude-User permite a los propietarios de sitios controlar a qué sitios se puede acceder mediante estas solicitudes iniciadas por el usuario.)
Anthropic es la excepción: su frase no contiene ninguna excepción para lo activado por el usuario. «May not apply» (puede que no se apliquen), «generally ignore» (generalmente ignoran), «may bypass» (puede saltarse) y «may not follow all» (puede que no siga todas) son cuatro grados distintos de intensidad, así que una única regla para todo el grupo falsearía la mayoría.
¿Qué rastreadores de IA publican rangos de IP? 22 archivos de rangos de 10 operadores
Diez operadores publican 22 archivos de rangos para los bots de IA que pudimos encontrar; GeoIPHub carga 17 de ellos. Estos rangos de IP de rastreadores de IA se presentan en cuatro estados. OpenAI, Perplexity, Mistral y el archivo de agentes de Google dan un archivo JSON por bot. Los tres bots de Anthropic comparten un archivo, y los tres archivos de Kimi y los dos de DuckDuckGo son idénticos byte a byte. Los tres bots de Amazon tienen solo una página web, cada una con su propio creationTime. Meta y MistralAI-Training no publican nada, y no encontramos ningún archivo de los operadores de la última sección. Claude-Agent publica en un formato más reciente, un archivo TOML en claude.com/.well-known/sail (draft-kelley-webbotauth-sail-00). Los rangos de IP de ClaudeBot y PerplexityBot sigue una consulta real de cada archivo.
GeoIPHub carga 19 archivos oficiales de rangos de 10 operadores. 17 de ellos están en esta lista; los otros dos son duckduckbot.json, idéntico al archivo de DuckDuckGo que figura abajo, y Ahrefs, que no es un bot de IA. Los 22 archivos son 20 listas distintas. Obtenidos el 9 de noviembre de 2026 a las 09:51 UTC, todos con HTTP 200:
1. GPTBot
- Archivo: gptbot.json
- Prefijos IPv4 / IPv6: 18 / 0
creationTime: 2026-09-22- Cargado: sí
2. OAI-SearchBot
- Archivo: searchbot.json
- Prefijos IPv4 / IPv6: 39 / 0
creationTime: 2026-01-02- Cargado: sí
3. ChatGPT-User
- Archivo: chatgpt-user.json
- Prefijos IPv4 / IPv6: 237 / 0
creationTime: 2026-11-06- Cargado: sí
4. OAI-AdsBot
- Archivo: adsbot.json
- Prefijos IPv4 / IPv6: 2 / 0
creationTime: 2026-05-12- Cargado: no
5. ClaudeBot, Claude-User, Claude-SearchBot
- Archivo: bots.json
- Prefijos IPv4 / IPv6: 14 / 0
creationTime: 2026-10-20- Cargado: sí
6. Claude-Agent
- Archivo: sail (TOML)
- Prefijos IPv4 / IPv6: 9 / 0
creationTime: modificado 2026-10-22- Cargado: no
7. Googlebot y rastreadores comunes, incluido Google-CloudVertexBot
- Archivo: common-crawlers.json
- Prefijos IPv4 / IPv6: 170 / 147
creationTime: 2026-11-06- Cargado: sí
8. Rastreadores de casos especiales
- Archivo: special-crawlers.json
- Prefijos IPv4 / IPv6: 136 / 136
creationTime: 2026-11-06- Cargado: sí
9. Fetchers activados por el usuario
- Archivo: user-triggered-fetchers.json
- Prefijos IPv4 / IPv6: 544 / 544
creationTime: 2026-11-06- Cargado: sí
10. Fetchers activados por el usuario (google.com)
- Archivo: user-triggered-fetchers-google.json
- Prefijos IPv4 / IPv6: 252 / 252
creationTime: 2026-11-06- Cargado: sí
11. Google-Agent
- Archivo: user-triggered-agents.json
- Prefijos IPv4 / IPv6: 12 / 8
creationTime: 2026-11-06- Cargado: sí
12. PerplexityBot
- Archivo: perplexitybot.json
- Prefijos IPv4 / IPv6: 13 / 0
creationTime: 2026-10-28- Cargado: sí
13. Perplexity-User
- Archivo: perplexity-user.json
- Prefijos IPv4 / IPv6: 10 / 0
creationTime: 2026-10-28- Cargado: sí
14. MistralAI-User
- Archivo: mistralai-user-ips.json
- Prefijos IPv4 / IPv6: 4 / 0
creationTime: 2025-02-19- Cargado: sí
15. MistralAI-Index
- Archivo: mistralai-index-ips.json
- Prefijos IPv4 / IPv6: 2 / 0
creationTime: 2026-04-19- Cargado: sí
16. Bingbot
- Archivo: bingbot.json
- Prefijos IPv4 / IPv6: 29 / 0
creationTime: 2024-01-03- Cargado: sí
17. Applebot
- Archivo: applebot.json
- Prefijos IPv4 / IPv6: 24 / 0
creationTime: 2026-09-15- Cargado: sí
18. DuckAssistBot (misma lista que duckduckbot.json)
- Archivo: duckassistbot.json
- Prefijos IPv4 / IPv6: 486 / 0
creationTime: 2026-09-01- Cargado: sí
19. CCBot
- Archivo: ccbot.json
- Prefijos IPv4 / IPv6: 4 / 1
creationTime: 2026-08-11- Cargado: sí
20. KimiBot
- Archivo: kimibot.json
- Prefijos IPv4 / IPv6: 4 / 0
creationTime: 2026-05-18- Cargado: no
21. Kimi-User
- Archivo: kimi-user.json
- Prefijos IPv4 / IPv6: 4 / 0
creationTime: 2026-05-18- Cargado: no
22. Kimi-SearchBot
- Archivo: kimi-searchbot.json
- Prefijos IPv4 / IPv6: 4 / 0
creationTime: 2026-05-18- Cargado: no
La fecha de un archivo no demuestra que la lista no haya cambiado: el archivo de Bingbot pasó de 28 a 29 prefijos mientras su fecha seguía siendo 2024-01-03. Contamos 28 en nuestra entrada del 29 de octubre y 29 el 9 de noviembre, y no tenemos ninguna copia anterior, así que no podemos decir qué prefijo se añadió. Los archivos de casos especiales y de fetchers activados por el usuario de Google también cubren fetchers que no son de IA; Google incluye entre ellos sus fetchers de IA.
Las tres páginas de Amazon no son archivos. developer.amazon.com/amazonbot/ip-addresses/ (Amazonbot), .../searchbot-ip-addresses/ (Amzn-SearchBot) y .../live-ip-addresses/ (Amzn-User) llevan valores creationTime incrustados de 2026-09-08, 2026-09-08 y 2025-11-04. No las cargamos. Los dos archivos de DuckDuckGo tienen el mismo hash MD5, igual que los tres de Kimi. El único archivo de Anthropic cubre tres bots, y Anthropic dice «If a crawler has a source IP address on this list, it indicates that the crawler is coming from Anthropic.» (Si un rastreador tiene una dirección IP de origen en esta lista, indica que el rastreador procede de Anthropic.)
Seis prefijos son idénticos en gptbot.json y searchbot.json en esta fecha: 4.227.36.0/25, 74.7.175.128/25, 74.7.228.0/25, 74.7.230.0/25, 74.7.241.128/25 y 74.7.244.0/25. chatgpt-user.json no comparte ninguno con ellos. Nuestra lista de IP de rastreadores verificados muestra cómo construir una lista de permitidos a partir de estos archivos.
¿Qué bots de IA puede verificar GeoIPHub? 16 de 29 el 9 de noviembre
La API de GeoIPHub verifica una dirección cuando está dentro de un archivo que cargamos, y eso demuestra el operador, no el bot. Consultamos una dirección real de 14 de los 17 archivos que cargamos (todos salvo el archivo de casos especiales de Google y sus dos archivos de fetchers activados por el usuario), más tres casos de contraste, sin clave, con unos 14 segundos de diferencia, el 9 de noviembre de 2026 de 09:52 a 09:55 UTC. Cada consulta verificada también devolvió verification_method: "ip_range_list", scoring.recommended_action: "allow" y un fraud_score de 0.
OAI-SearchBot
- Dirección (del archivo): 4.227.36.1 (searchbot.json y gptbot.json)
verified: truename: OAISearchBotoperator: OpenAIcategory: ai- UTC: 09:52:11
GPTBot
- Dirección (del archivo): 132.196.86.1 (gptbot.json)
verified: truename: GPTBotoperator: OpenAIcategory: ai- UTC: 09:52:25
ChatGPT-User
- Dirección (del archivo): 104.208.184.193
verified: truename: ChatGPTUseroperator: OpenAIcategory: ai- UTC: 09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- Dirección (del archivo): 216.73.216.10 (bots.json)
verified: truename: ClaudeBotoperator: Anthropiccategory: ai- UTC: 09:52:52
PerplexityBot
- Dirección (del archivo): 107.20.236.150
verified: truename: PerplexityBotoperator: Perplexitycategory: ai- UTC: 09:53:06
Perplexity-User
- Dirección (del archivo): 18.97.43.80
verified: truename: PerplexityUseroperator: Perplexitycategory: ai- UTC: 09:53:20
MistralAI-User
- Dirección (del archivo): 20.240.160.161
verified: truename: MistralAIUseroperator: Mistralcategory: ai- UTC: 09:53:33
MistralAI-Index
- Dirección (del archivo): 135.225.57.92
verified: truename: MistralAIIndexoperator: Mistralcategory: ai- UTC: 09:53:47
Google-Agent
- Dirección (del archivo): 136.121.16.1
verified: truename: GoogleUserTriggeredAgentoperator: Googlecategory: ai- UTC: 09:54:01
Google-CloudVertexBot
- Dirección (del archivo): 192.178.4.1 (common-crawlers.json)
verified: truename: Googlebotoperator: Googlecategory: search_engine- UTC: 09:54:15
DuckAssistBot
- Dirección (del archivo): 104.43.54.127
verified: truename: DuckAssistBotoperator: DuckDuckGocategory: ai- UTC: 09:54:30
CCBot
- Dirección (del archivo): 18.97.9.169
verified: truename: CCBotoperator: CommonCrawlcategory: archiver- UTC: 09:54:46
Applebot
- Dirección (del archivo): 17.241.208.161
verified: truename: Applebotoperator: Applecategory: search_engine- UTC: 09:55:00
Bingbot
- Dirección (del archivo): 157.55.39.1
verified: truename: Bingbotoperator: Microsoftcategory: search_engine- UTC: 09:55:14
OAI-AdsBot (archivo no cargado)
- Dirección (del archivo): 130.131.229.129 (adsbot.json)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC: 09:55:28
Amazonbot (página no cargada)
- Dirección (del archivo): 3.81.245.78 (página de Amazon)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC: 09:55:42
Meta (red, sin archivo)
- Dirección (del archivo): 31.13.64.1
verified: false,unverified: truename: Facebook-Botoperator: Metacategory: social_preview- UTC: 09:55:56
Las trampas están en el campo name. name es la etiqueta del archivo que se cargó en último lugar, así que los tres bots de Anthropic devuelven ClaudeBot, las direcciones de DuckDuckBot devuelven DuckAssistBot y Google-CloudVertexBot devuelve Googlebot. category no es un campo de función: CCBot devuelve archiver, y Applebot y Bingbot devuelven search_engine. Usa como clave el token declarado más operator, y escribe CommonCrawl sin espacio.
La sorpresa fue 4.227.36.1. Está dentro de 4.227.36.0/25, que figura tanto en gptbot.json como en searchbot.json. Una copia recortada de la respuesta real:
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
No decimos que una solicitud de GPTBot devuelva OAISearchBot. La dirección, que está en ambos archivos, devuelve ese nombre, y nuestra consulta no puede saber qué bot envió una solicitud. La propia OpenAI dice que «may use the results from just one crawl for both use cases» (puede usar los resultados de un solo rastreo para ambos casos de uso). La IP demuestra OpenAI y el User-Agent dice qué bot es; la entrada sobre OpenAI explica qué hace cada bot de OpenAI.
Los casos no cargados son sencillos. El archivo de OAI-AdsBot está publicado y 130.131.229.129 está dentro de él, pero nuestra API devuelve is_crawler: false y una respuesta de alojamiento (puntuación 15, allow, AS8075 Microsoft). La propia página de Amazonbot lista 3.81.245.78 y la API devuelve el mismo tipo de respuesta (puntuación 16, allow, AS14618 Amazon). Nada en nuestros datos separa a un OAI-AdsBot real de cualquier otra dirección de esa nube. 31.13.64.1 de Meta es una dirección de la red de Meta (AS32934), verified: false; no observamos que rastreara.
La API no devuelve qué archivo coincidió ni cuándo se obtuvo, y una consulta nunca ve tu User-Agent. Los detalles de los campos están en los campos de rastreador, y puedes pegar una dirección y su user agent de tus registros en el verificador de IP de rastreadores. Lee threat.crawler.verified y compara el operador con el bot que nombra tu user agent, en tu navegador..
Comprueba una IP de tus registros contra el archivo correcto
Este fragmento toma la IP de una línea de registro y el User-Agent que declara, carga solo el archivo del bot nombrado en el User-Agent e informa de si la dirección está en él y qué otros archivos también la listan. No toma ninguna decisión de permitir o bloquear y no escribe ninguna lista. Es un ejemplo, no un analizador: un User-Agent con dos tokens de bot coincide con el más largo.
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
Cada línea de registro es <ip> <User-Agent>. Lo ejecutamos el 9 de noviembre de 2026 a las 10:01 UTC con esta muestra, donde 45.33.32.156 es el host público de escaneo de Nmap (no envió ninguna solicitud de ese tipo) y 203.0.113.9 y 2001:db8::1 son direcciones de documentación:
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
OAI-AdsBot pasa aquí porque el fragmento lee el archivo directamente, aunque nuestra API no lo cargue. Un token de User-Agent se asigna a un archivo, siguiendo la regla de Perplexity: «Each bot has its own IP ranges, so match each User-Agent against its own IP ranges.» (Cada bot tiene sus propios rangos de IP, así que compara cada User-Agent con sus propios rangos de IP.) Un archivo inaccesible significa «not verified», nunca «verified»: con SSL_CERT_FILE apuntando a una ruta que no existe, cada línea imprimió not verified: ... file unavailable. Una cadena de IP incorrecta imprime «not verified» en lugar de detener la ejecución. El fragmento establece su propio User-Agent porque claude.com devolvió 403 al User-Agent predeterminado de Python el 9 de noviembre de 2026, mientras que los demás archivos devolvieron 200.
Para los bots sin archivo, los métodos están en cómo verificar rastreadores y agentes de IA: DNS inverso y firmas. Google dice que «is also experimenting with the Web Bot Auth protocol» (también está experimentando con el protocolo Web Bot Auth), con la identidad https://agent.bot.goog, y YouBot publica un directorio de firmas.
Nombres que nunca llegan a tus registros y bots que no pudimos documentar
Algunos nombres de otras listas no son rastreadores, o no tienen una página del operador que pudiéramos abrir. Tres son tokens de control que nunca aparecen como solicitante, así que ninguno puede registrarse ni verificarse por IP.
Google-Extended (Google)
- ¿En tus registros?: No
- Palabras del operador: «Google-Extended doesn't have a separate HTTP request user agent string. Crawling is done with existing Google user agent strings; the robots.txt user-agent token is used in a control capacity.» (Google-Extended no tiene una cadena de user agent de solicitud HTTP independiente. El rastreo se hace con las cadenas de user agent de Google existentes; el token user-agent de robots.txt se usa con una función de control.)
- Respetado por: Google
Applebot-Extended (Apple)
- ¿En tus registros?: No
- Palabras del operador: «Applebot-Extended does not crawl webpages.» (Applebot-Extended no rastrea páginas web.) y «Applebot-Extended is only used to determine how to use the data crawled by the Applebot user agent.» (Applebot-Extended solo se usa para determinar cómo usar los datos rastreados por el user agent Applebot.)
- Respetado por: Apple
__usage_ai-training (compartido (borrador aipref del IETF))
- ¿En tus registros?: No, es el nombre de un grupo de robots.txt
- Palabras del operador: Microsoft: «Starting February 1, 2027, Microsoft will honor the new preferences as it crawls» (A partir del 1 de febrero de 2027, Microsoft respetará las nuevas preferencias al rastrear). Google: «intends to support the AIPREF shared machine-readable training preference signal (with «user-agent: __usage_ai-training») in early 2027» (tiene la intención de admitir la señal compartida de preferencia de entrenamiento legible por máquina AIPREF (con «user-agent: __usage_ai-training») a principios de 2027). Anthropic: «As of October 30, 2026, Anthropic has begun recognizing a machine-readable signal» (Desde el 30 de octubre de 2026, Anthropic ha empezado a reconocer una señal legible por máquina)
- Respetado por: Anthropic desde 2026-10-30 (su página no nombra el token); Microsoft desde 2027-02-01; Google «a principios de 2027» (intención); OpenAI sin verificar
La página de Anthropic dice que su señal se basa en «a draft based on work done by the IETF ... in its aipref working group» (un borrador basado en el trabajo realizado por el IETF ... en su grupo de trabajo aipref). No pudimos abrir las páginas de ayuda de OpenAI, así que no afirmamos nada sobre OpenAI.
El 9 de noviembre de 2026 no pudimos encontrar una página gestionada por el operador para los bots siguientes. Esta lista dice qué comprobamos. Un bot que falte aquí puede existir igualmente; no estamos diciendo que estos operadores no ejecuten ningún rastreador.
ByteDance: Bytespider
- Qué comprobamos el 2026-11-09: bytedance.com/robots.txt; bytedance.com/en/bytespider (404); bytespider.bytedance.com (sin DNS); página de inicio de zhanzhang.toutiao.com (sin texto sobre rastreadores)
- Resultado: No se encontró ninguna página de ByteDance. Terceros discrepan sobre si existen rangos, así que no indicamos ninguna función ni rangos
xAI: tokens relacionados con Grok
- Qué comprobamos el 2026-11-09: docs.x.ai/llms.txt (sin texto sobre rastreadores ni robots.txt); docs.x.ai/docs/crawler (404); x.ai/grok-bot.json (403)
- Resultado: No se encontró nada
Cohere: cohere-ai, cohere-training-data-crawler
- Qué comprobamos el 2026-11-09: docs.cohere.com/docs/cohere-web-crawlers (se abre; la tabla de bots dice «N/A»); cohere.com/crawler (404); cohere.com/cohere-ai.json (404)
- Resultado: La página dice: «We do not use Cohere bots or user agents for the purpose of crawling or scraping web content to train generative AI foundation models at this time.» (No usamos bots ni user agents de Cohere para rastrear o extraer contenido web con el fin de entrenar modelos fundacionales de IA generativa en este momento.)
DeepSeek: DeepSeekBot
- Qué comprobamos el 2026-11-09: deepseek.com/robots.txt; api-docs.deepseek.com/llms.txt (sin coincidencias); deepseek.com/deepseekbot.json (404)
- Resultado: No se encontró nada
Algunos nombres están obsoletos. anthropic-ai y Claude-Web no están en la página de Anthropic, FacebookBot no está en la página de Meta y Gemini-Deep-Research no aparece en ninguna de las cuatro páginas de rastreadores de Google que leímos. No están documentados en las páginas que leímos, así que no listamos ninguno de ellos como bot.
Cómo se comprobó esta lista y cómo cambia
GeoIPHub comprobó esta lista de rastreadores de IA abriendo la página de cada operador, obteniendo cada archivo, volviendo a contar y ejecutando las consultas anteriores. La fecha de una entrada solo cambia cuando volvemos a comprobar esa entrada.
Cambios que vimos, cada uno con su fecha: el archivo de Bingbot pasó de 28 a 29 prefijos con una fecha congelada de 2024-01-03. El archivo de ChatGPT-User tenía 234 prefijos, luego 235 el 29 de octubre y después 237 en un archivo fechado el 6 de noviembre de 2026. Los dos archivos de Perplexity tenían 4 y 8 prefijos el 27 de octubre y 10 y 13 el 28 de octubre. El archivo de Anthropic tenía 38 prefijos en nuestra entrada sobre bloquear rastreadores de IA (archivo fechado el 7 de octubre) y ahora tiene 14, con fecha del 20 de octubre. No indicamos ningún calendario de actualización, ni para los operadores ni para nuestra API. La API no devuelve la fecha de obtención, así que un prefijo que un operador añadió hace poco puede no verificarse todavía.
El nombre de la cabecera es una afirmación, y la prueba es el archivo del operador cuando el operador publica uno.
Preguntas frecuentes
¿Qué es una lista de rastreadores de IA?
Una lista de los clientes automatizados que las empresas de IA y los productos de búsqueda ejecutan para obtener páginas web, con el user agent de cada uno, su función (entrenamiento, búsqueda, obtención activada por el usuario o agente) y la forma de demostrar su identidad. El 9 de noviembre de 2026 la lista de GeoIPHub tiene 29 bots que los operadores documentan, y la API de GeoIPHub verifica 16 de ellos por IP.
¿Cuál es la diferencia entre GPTBot y ClaudeBot?
GPTBot es el rastreador de entrenamiento de OpenAI y ClaudeBot es el de Anthropic. Cada uno publica un archivo de rangos, y el único archivo de Anthropic también cubre Claude-User y Claude-SearchBot. La API de GeoIPHub verifica una dirección de cualquiera de los dos archivos. Lo que hace cada bot de OpenAI se explica en GPTBot vs OAI-SearchBot vs ChatGPT-User.
¿Qué rastreadores de IA publican rangos de IP?
El 9 de noviembre de 2026, diez operadores publican 22 archivos de rangos para los bots de IA que pudimos encontrar: OpenAI, Anthropic, Google, Perplexity, Mistral, Microsoft, Apple, DuckDuckGo, Common Crawl y Moonshot. GeoIPHub carga 17 de ellos. Amazon muestra las direcciones en páginas web, y Meta y MistralAI-Training no publican ninguna.
¿Puedo verificar un rastreador de IA por su user agent?
No. Un user agent es una cadena que cualquier cliente puede enviar. La consulta de GeoIPHub solo recibe la IP: puede decirte que la dirección está dentro del archivo de OpenAI o de Anthropic, y es tu propio código el que compara ese operador con el bot que nombra el User-Agent.
¿Qué user agent usa el rastreador de IA de Meta?
Meta documenta meta-externalagent/1.1 para el entrenamiento, meta-webindexer/1.1 para la búsqueda de Meta AI y meta-externalfetcher/1.1 para las obtenciones solicitadas por el usuario. Meta no publica ningún archivo de rangos, así que GeoIPHub reconoce su red por ASN y devuelve verified: false.
¿CCBot es un rastreador de IA?
CCBot es el rastreador de Common Crawl, y Common Crawl publica un archivo de IP y DNS inverso para él. Otras listas lo llaman rastreador de IA porque el archivo que construye puede usarse para entrenamiento; ese vínculo es de ellas, no una afirmación de Common Crawl. GeoIPHub verifica su archivo y devuelve la categoría archiver.
El equipo detrás de la API de GeoIPHub
Escrito por el equipo de GeoIPHub, las personas que crean la API de inteligencia IP de GeoIPHub y su escáner. Los borradores se preparan con ayuda de IA y el equipo los edita; los ejemplos de la API son consultas reales contra la API en producción, salvo que se indique que son ilustrativos.
 Inteligencia IP