 Netzwerksicherheit
KI-Crawler-Liste: User-Agents von 29 Bots und welche Sie per IP verifizieren können
Eine KI-Crawler-Liste mit 29 Bots nach Aufgabe, samt User-Agents, robots.txt-Wortlaut und Range-Dateien, und den 16, die GeoIPHub per IP verifiziert; geprüft am 9. November 2026.
Umfang: Bots, die ein Betreiber auf einer Seite dokumentiert, die wir am 9. November 2026 öffnen konnten, soweit sie für KI genutzt werden. Meta dokumentiert außerdem meta-externalads, einen Werbe-Crawler, den wir nicht mitgezählt haben. Namen, die auf anderen Listen ohne Dokumentation des Betreibers kursieren, stehen in einer eigenen Liste, zusammen mit dem, was wir geprüft haben.
Für 25 dieser 29 Bots veröffentlichen die Betreiber einen Nachweis. Die API von GeoIPHub verifiziert 16. Die übrigen neun sind keine Lücke in dem, was Betreiber dokumentieren: Es sind Dateien und Seiten, die wir nicht laden, und die Liste sagt, welche.
Andere Listen nennen Namen und Tokens, aber ein Name in einem User-Agent-Header beweist nichts, denn jeder kann ihn eintippen. Der Nachweis der Betreiber kommt in fünf Formen: eine JSON-Datei, eine Webseite mit Adressen, Reverse DNS, eine Signatur oder nichts. Dieser Beitrag gehört zu unserer Arbeit an der Bot-Erkennung per IP. Im Folgenden: jeder Bot nach Aufgabe, die 22 Range-Dateien mit ihren Anzahlen und Daten, was die API von GeoIPHub für eine echte Adresse aus 14 der Dateien zurückgab, die wir laden, ein Snippet, das eine Logzeile gegen die richtige Datei prüft, und die Namen, die nie in Ihren Logs erscheinen oder die wir nicht belegen konnten.
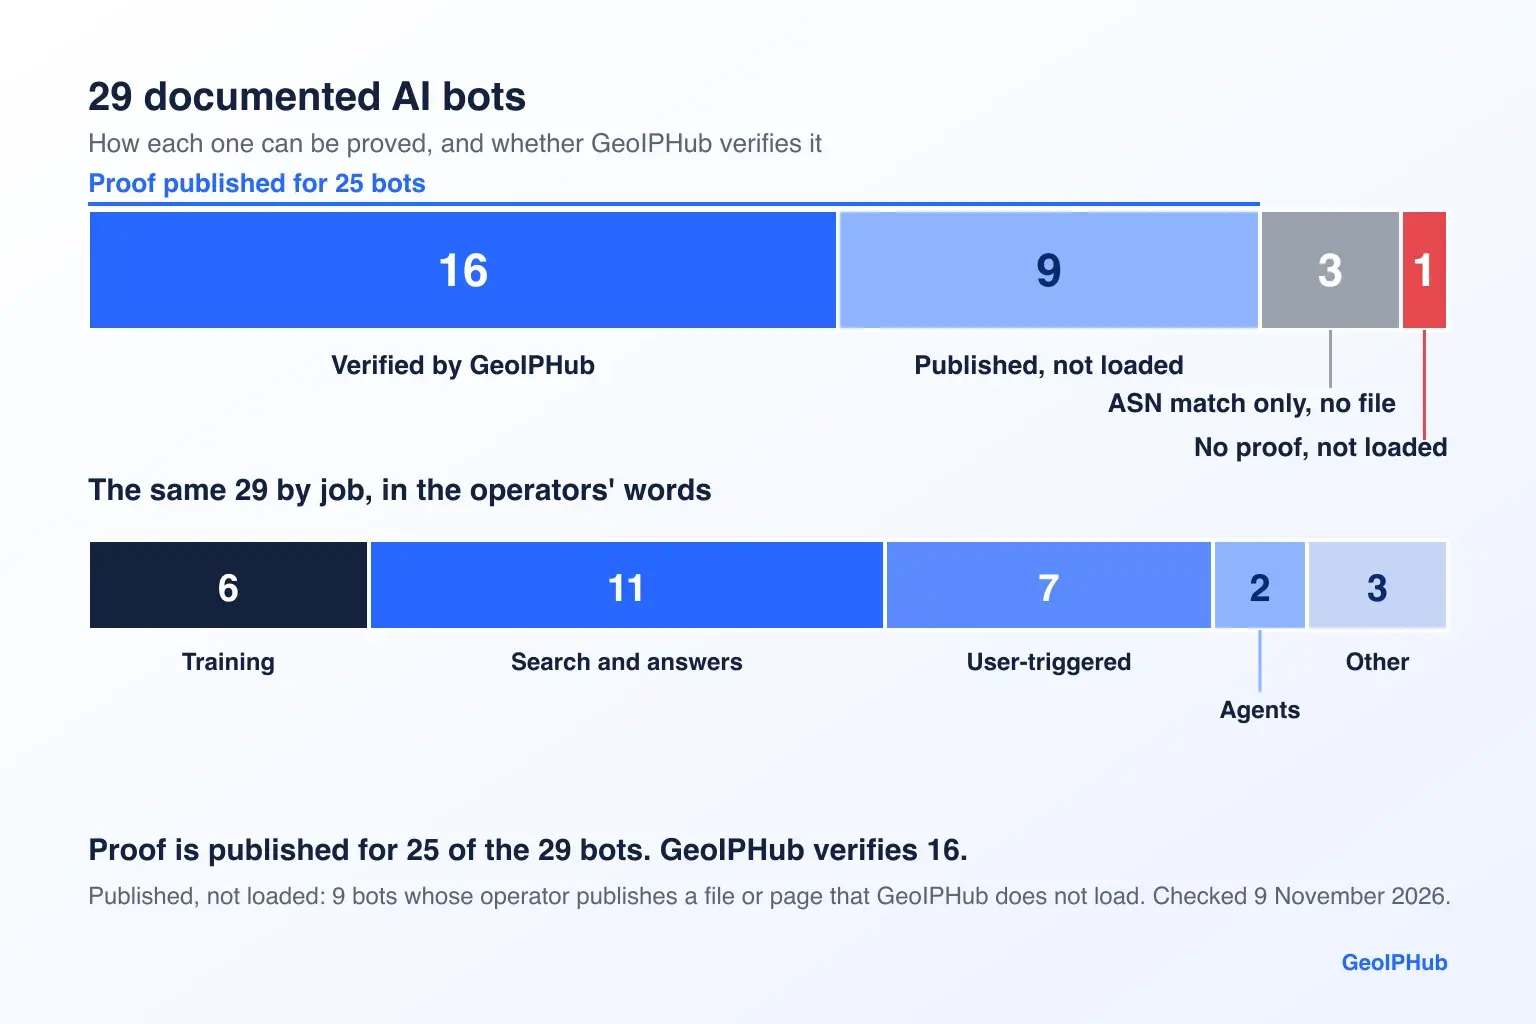
Die KI-Crawler-Liste: 29 Bots nach Aufgabe
Diese KI-Crawler-Liste ordnet 29 dokumentierte Bots und ihre KI-Crawler-User-Agents nach der Aufgabe, die ihr Betreiber nennt: Training, Suche, nutzerausgelöster Abruf, Agenten und eine kurze Gruppe, die nichts davon ist. In jedem Eintrag werden vier Begriffe verwendet. Nachweis bezeichnet, was der Betreiber veröffentlicht: eine Range-Datei, eine Webseite mit Adressen, Reverse DNS, eine Signatur oder nichts. Verifiziert bedeutet, dass eine Adresse aus der eigenen Datei dieses Bots am angegebenen Datum in der API von GeoIPHub verified: true zurückgab. Nur ASN-Treffer bedeutet, dass wir das Netz des Betreibers zuordnen und verified: false zurückgeben. Nicht geladen bedeutet, dass wir die Liste des Betreibers nicht laden.
Die Gruppierung folgt den Worten der Betreiber und ist nicht trennscharf. OpenAI sagt: „Wenn Ihre Website beide Bots zugelassen hat, verwenden wir möglicherweise die Ergebnisse nur eines Crawls für beide Anwendungsfälle“ (englisch: „If your site has allowed both bots, we may use the results from just one crawl for both use cases“). Meta sagt „Anwendungsfälle wie Training“ („use cases such as training“). Amazon sagt „kann zum Training verwendet werden“ („may be used to train“). Der Crawler von Apple ist in erster Linie ein Such-Crawler und „kann auch zum Training“ seiner Modelle beitragen („may also be used to help train“). Die Bot-Dokumentation von Cloudflare zieht dieselbe Dreiteilung: Search („Crawling, um Suchindizes oder RAG-Datenbanken aufzubauen“), Agent („Nutzergesteuerte Agenten, die im Auftrag eines Menschen eine Seite besuchen“) und Training („Crawling, um Modelle zu trainieren oder zu feintunen“).
Welche KI-Crawler trainieren Modelle?
Sechs, nach dem eigenen Wortlaut ihrer Betreiber.
GPTBot (OpenAI)
- UA-Fragment: GPTBot/1.4
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: „Wer GPTBot per Disallow ausschließt, signalisiert, dass die Inhalte einer Website nicht zum Training generativer KI-Basismodelle verwendet werden sollen.“
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
ClaudeBot (Anthropic)
- UA-Fragment: ClaudeBot
- Nachweis: Datei (gemeinsam)
- robots.txt, Wortlaut des Betreibers: „Die Bots von Anthropic respektieren ‚Nicht crawlen‘-Signale, indem sie branchenübliche Direktiven in der robots.txt befolgen.“
- Von GeoIPHub verifiziert: verifiziert (als Anthropic)
- Geprüft: 2026-11-09
MistralAI-Training (Mistral)
- UA-Fragment: MistralAI-Training/1.0
- Nachweis: keiner
- robots.txt, Wortlaut des Betreibers: „Webmaster können diesen User-Agent in ihrer robots.txt-Datei per Disallow ausschließen.“
- Von GeoIPHub verifiziert: nicht geladen (mistralai-training-ips.json liefert 404)
- Geprüft: 2026-11-09
meta-externalagent (Meta)
- UA-Fragment: meta-externalagent/1.1
- Nachweis: keiner
- robots.txt, Wortlaut des Betreibers: „Um diese Crawler zu blockieren, fügen Sie in der robots.txt ein Disallow für den jeweiligen Crawler hinzu.“
- Von GeoIPHub verifiziert: nur ASN-Treffer, unverifiziert
- Geprüft: 2026-11-09
Amazonbot (Amazon)
- UA-Fragment: Amazonbot/0.1
- Nachweis: nur Webseite
- robots.txt, Wortlaut des Betreibers: „Automatisiertes Crawling durch diese aufgeführten User-Agents respektiert das Robots Exclusion Protocol und befolgt den User-Agent sowie die Allow-/Disallow-Direktiven.“
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
KimiBot (Moonshot)
- UA-Fragment: KimiBot/1.0
- Nachweis: Datei (eine Datei, drei Namen)
- robots.txt, Wortlaut des Betreibers: nicht zitiert
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
Der Zweck in den Worten der Betreiber: GPTBot wird „verwendet, um Inhalte zu crawlen, die möglicherweise zum Training unserer generativen KI-Basismodelle genutzt werden“. MistralAI-Training „crawlt Webinhalte, um Datensätze für das Training generativer KI-Modelle von Mistral aufzubauen“. KimiBot „crawlt Inhalte, die potenziell zum Training der Basismodelle von Kimi genutzt werden“.
Welche KI-Crawler treiben Suche und Antworten an?
Elf, darunter zwei klassische Such-Crawler, die in unserem geladenen Satz enthalten sind.
OAI-SearchBot (OpenAI)
- UA-Fragment: OAI-SearchBot/1.4
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: „Websites, die OAI-SearchBot ausgeschlossen haben, werden in den Suchantworten von ChatGPT nicht angezeigt“
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
Claude-SearchBot (Anthropic)
- UA-Fragment: Claude-SearchBot
- Nachweis: Datei (gemeinsam)
- robots.txt, Wortlaut des Betreibers: derselbe Anthropic-Satz wie bei ClaudeBot
- Von GeoIPHub verifiziert: verifiziert (als Anthropic)
- Geprüft: 2026-11-09
PerplexityBot (Perplexity)
- UA-Fragment: PerplexityBot/1.0
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: nicht zitiert
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
MistralAI-Index (Mistral)
- UA-Fragment: MistralAI-Index/1.0
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: nicht zitiert
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
meta-webindexer (Meta)
- UA-Fragment: meta-webindexer/1.1
- Nachweis: keiner
- robots.txt, Wortlaut des Betreibers: derselbe Meta-Satz wie bei meta-externalagent
- Von GeoIPHub verifiziert: nur ASN-Treffer, unverifiziert
- Geprüft: 2026-11-09
Amzn-SearchBot (Amazon)
- UA-Fragment: Amzn-SearchBot/0.1
- Nachweis: nur Webseite
- robots.txt, Wortlaut des Betreibers: „Wenn robots.txt-Dateien Amzn-SearchBot nicht erwähnen, aber andere Such-Bots zulassen, crawlt Amzn-SearchBot gemäß den robots.txt-Direktiven, die für andere Such-Bots gelten.“
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
Applebot (Apple)
- UA-Fragment: Applebot/0.1
- Nachweis: Datei + Reverse DNS
- robots.txt, Wortlaut des Betreibers: „Applebot respektiert im Allgemeinen die üblichen robots.txt-Direktiven bei allgemeinen Such-Crawls, die auf Applebot ausgerichtet sind.“
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
Bingbot (Microsoft)
- UA-Fragment: Bingbot
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: nicht zitiert (die Seite von Microsoft benötigt JavaScript, daher konnten wir sie nicht lesen)
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
DuckAssistBot (DuckDuckGo)
- UA-Fragment: DuckAssistBot/1.2
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: „Sobald Sie die Datei aktualisiert haben, um den User-Agent DuckAssistBot auszuschließen, wird die Änderung nach 72 Stunden wirksam, und DuckAssistBot hört auf, Ihre Website zu crawlen.“
- Von GeoIPHub verifiziert: verifiziert (Adressen von DuckDuckBot liefern diesen Namen ebenfalls)
- Geprüft: 2026-11-09
Kimi-SearchBot (Moonshot)
- UA-Fragment: Kimi-SearchBot/1.0
- Nachweis: Datei (gemeinsam)
- robots.txt, Wortlaut des Betreibers: nicht zitiert
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
YouBot (You.com)
- UA-Fragment: YouBot/1.0
- Nachweis: Signatur + Reverse DNS + nur Webseite (ein /24)
- robots.txt, Wortlaut des Betreibers: „Er respektiert robots.txt-Direktiven und Präferenzen zur Crawl-Rate“
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
Bingbot und Applebot stehen hier, weil sie in unserem geladenen Satz sind und Apple sagt, sein Crawler könne zum Training seiner Modelle beitragen. Die Crawler-Seite von Microsoft konnten wir nicht lesen, da sie JavaScript benötigt, doch sein Beitrag vom 30. Oktober legt KI-Präferenzen über Bingbot fest. YouBot ist der einzige Eintrag mit drei Nachweisen: ein Signaturverzeichnis unter you.com/.well-known/http-message-signatures-directory, Reverse DNS in der Form youbot-68-67-112-106 und die Aussage „Legitime YouBot-Anfragen stammen von 68.67.112.0/24.“
Der Zweck in den Worten der Betreiber: PerplexityBot ist „darauf ausgelegt, Websites in den Suchergebnissen von Perplexity anzuzeigen und zu verlinken. Er wird nicht verwendet, um Inhalte für KI-Basismodelle zu crawlen.“ MistralAI-Index dient „dem automatisierten Crawlen des Webs ausschließlich zu Indexierungszwecken“. DuckAssistBot „crawlt Seiten in Echtzeit für unsere KI-gestützten Antworten“ und „Diese Daten werden in keiner Weise zum Training von KI-Modellen verwendet.“
Welche KI-Crawler rufen eine Seite ab, weil ein Nutzer darum bat?
Sieben, dazu die nutzerausgelösten Fetcher von Google.
ChatGPT-User (OpenAI)
- UA-Fragment: ChatGPT-User/1.0
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: „Da diese Aktionen von einem Nutzer ausgelöst werden, gelten robots.txt-Regeln möglicherweise nicht.“
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
Claude-User (Anthropic)
- UA-Fragment: Claude-User
- Nachweis: Datei (gemeinsam)
- robots.txt, Wortlaut des Betreibers: der Satz von Anthropic für alle seine Bots (siehe ClaudeBot); keine Ausnahme für nutzerausgelöste Abrufe gefunden
- Von GeoIPHub verifiziert: verifiziert (als Anthropic)
- Geprüft: 2026-11-09
Perplexity-User (Perplexity)
- UA-Fragment: Perplexity-User/1.0
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: „Da ein Nutzer den Abruf angefordert hat, ignoriert dieser Fetcher robots.txt-Regeln in der Regel.“
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
MistralAI-User (Mistral)
- UA-Fragment: MistralAI-User/1.0
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: „MistralAI-User bestimmt, auf welche Websites diese Nutzeranfragen gerichtet werden können.“
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
meta-externalfetcher (Meta)
- UA-Fragment: meta-externalfetcher/1.1
- Nachweis: keiner
- robots.txt, Wortlaut des Betreibers: „kann robots.txt umgehen, weil er Abrufe durchführt, die der Nutzer angefordert hat“
- Von GeoIPHub verifiziert: nur ASN-Treffer, unverifiziert
- Geprüft: 2026-11-09
Amzn-User (Amazon)
- UA-Fragment: Amzn-User/0.1
- Nachweis: nur Webseite
- robots.txt, Wortlaut des Betreibers: „Weil Aktionen von Amzn-User von einem Nutzer ausgelöst werden können, befolgt er möglicherweise nicht alle robots.txt-Direktiven.“
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
Kimi-User (Moonshot)
- UA-Fragment: Kimi-User/1.0
- Nachweis: Datei (gemeinsam)
- robots.txt, Wortlaut des Betreibers: „weil die Aktionen nutzerausgelöst sind, gelten robots.txt-Regeln möglicherweise nicht unmittelbar“
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
Die Seite von Google nennt außerdem Google-GeminiNotebook, das „einzelne URLs abruft, die Nutzer von Gemini Notebook als Quellen angegeben haben“. Sie sagt nicht, welche der nutzerausgelösten Range-Dateien von Google ihn aufführt, daher konnten wir ihn nicht testen und haben ihn in der Liste weggelassen.
Welche KI-Bots sind Agenten?
Zwei, beide dokumentiert als Agenten, die für einen Nutzer im Web navigieren.
Google-Agent (Google)
- UA-Fragment: Google-Agent
- Nachweis: Datei (+ Signatur, in Erprobung)
- robots.txt, Wortlaut des Betreibers: nutzerausgelöste Fetcher „ignorieren robots.txt-Regeln in der Regel“ (Aussage auf Seitenebene)
- Von GeoIPHub verifiziert: verifiziert
- Geprüft: 2026-11-09
Claude-Agent (Anthropic)
- UA-Fragment: Claude-Agent/1.0
- Nachweis: Datei (SAIL, TOML, nicht JSON)
- robots.txt, Wortlaut des Betreibers: „Ihre Präferenzen für die Roboter von Anthropic (Crawler und Fetcher) sind voneinander unabhängig, und Sie können sie getrennt verwalten.“ (die Agentenseite behandelt robots.txt für den Browser selbst nicht)
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
Google-Agent wird „von Agenten verwendet, die auf der Infrastruktur von Google gehostet werden, um im Web zu navigieren und auf Nutzeranfrage Aktionen auszuführen“. Für Claude-Agent sagt Anthropic, man solle „auf das Token Claude-Agent abgleichen statt auf den vollständigen String“.
Welche KI-Bots sind nichts davon?
Drei, jeder von seinem Betreiber für eine andere Aufgabe dokumentiert.
OAI-AdsBot (OpenAI)
- UA-Fragment: OAI-AdsBot/1.0
- Nachweis: Datei
- robots.txt, Wortlaut des Betreibers: nicht zitiert (auf der Seite von OpenAI keine Aussage gefunden)
- Von GeoIPHub verifiziert: nicht geladen
- Geprüft: 2026-11-09
CCBot (Common Crawl)
- UA-Fragment: CCBot/2.0
- Nachweis: Datei + Reverse DNS
- robots.txt, Wortlaut des Betreibers: die Seite nennt
User-agent: CCBotundDisallow: / - Von GeoIPHub verifiziert: verifiziert (Kategorie
archiver) - Geprüft: 2026-11-09
Google-CloudVertexBot (Google)
- UA-Fragment: Google-CloudVertexBot
- Nachweis: Datei (die Common-Crawlers-Datei von Google)
- robots.txt, Wortlaut des Betreibers: nicht zitiert
- Von GeoIPHub verifiziert: verifiziert (gemeinsame Common-Crawlers-Datei)
- Geprüft: 2026-11-09
OAI-AdsBot wird „verwendet, um die Sicherheit von Webseiten zu prüfen, die als Anzeigen in ChatGPT eingereicht werden“. Google-CloudVertexBot „crawlt auf Anforderung der Websitebetreiber, um Vertex AI Agents aufzubauen“. Common Crawl sagt: „Uns ist bekannt, dass Crawler sich fälschlich als CCBot ausgeben.“ Die Referenz zu AI Crawl Control von Cloudflare führt CCBot als KI-Crawler auf; diese Verbindung zum Training stammt von einem Dritten, nicht von Common Crawl.
Was das Blockieren jeder Aufgabe kostet, behandelt KI-Crawler blockieren.
Nutzerausgelöste Bots behandeln robots.txt unterschiedlich, in den eigenen Worten ihrer Betreiber
Nutzerausgelöste KI-Bots wie ChatGPT-User, Perplexity-User und Claude-User folgen nicht einer gemeinsamen robots.txt-Regel: Jeder Betreiber sagt etwas anderes, und einer sagt gar nichts Besonderes. Der Abruf handelt für eine einzelne Person, und das ist der Grund, den die meisten nennen.
- ChatGPT-User (OpenAI): „Da diese Aktionen von einem Nutzer ausgelöst werden, gelten robots.txt-Regeln möglicherweise nicht.“
- Perplexity-User (Perplexity): „Da ein Nutzer den Abruf angefordert hat, ignoriert dieser Fetcher robots.txt-Regeln in der Regel.“
- nutzerausgelöste Fetcher, darunter Google-Agent (Google): „Da der Abruf von einem Nutzer angefordert wurde, ignorieren diese Fetcher robots.txt-Regeln in der Regel.“
- meta-externalfetcher (Meta): „kann robots.txt umgehen, weil er Abrufe durchführt, die der Nutzer angefordert hat“
- Amzn-User (Amazon): „Weil Aktionen von Amzn-User von einem Nutzer ausgelöst werden können, befolgt er möglicherweise nicht alle robots.txt-Direktiven.“
- Kimi-User (Moonshot): „weil die Aktionen nutzerausgelöst sind, gelten robots.txt-Regeln möglicherweise nicht unmittelbar“
- MistralAI-User (Mistral): „MistralAI-User bestimmt, auf welche Websites diese Nutzeranfragen gerichtet werden können.“
- Claude-User (Anthropic): „Die Bots von Anthropic respektieren ‚Nicht crawlen‘-Signale, indem sie branchenübliche Direktiven in der robots.txt befolgen.“ und „Claude-User erlaubt Websitebetreibern zu steuern, auf welche Websites über diese nutzerinitiierten Anfragen zugegriffen werden kann.“
Anthropic ist der Ausreißer: Sein Satz enthält keine Ausnahme für nutzerausgelöste Abrufe. „Gelten möglicherweise nicht“, „ignorieren in der Regel“, „kann umgehen“ und „befolgt möglicherweise nicht alle“ sind vier unterschiedliche Stärken, eine einzige Regel für die ganze Gruppe würde die meisten davon falsch wiedergeben.
Welche KI-Crawler veröffentlichen IP-Bereiche? 22 Range-Dateien von 10 Betreibern
Zehn Betreiber veröffentlichen 22 Range-Dateien für die KI-Bots, die wir finden konnten; GeoIPHub lädt 17 davon. Diese IP-Bereiche von KI-Crawlern kommen in vier Zuständen vor. OpenAI, Perplexity, Mistral und die Agentendatei von Google liefern eine JSON-Datei pro Bot. Die drei Bots von Anthropic teilen sich eine Datei, und die drei Dateien von Kimi sowie die zwei Dateien von DuckDuckGo sind byteidentisch. Die drei Bots von Amazon haben nur eine Webseite, jeweils mit eigenem creationTime. Meta und MistralAI-Training veröffentlichen nichts, und von den Betreibern im letzten Abschnitt fanden wir keine Datei. Claude-Agent veröffentlicht in einem neueren Format, einer TOML-Datei unter claude.com/.well-known/sail (draft-kelley-webbotauth-sail-00). IP-Bereiche von ClaudeBot und PerplexityBot verfolgt eine echte Abfrage aus jeder Datei.
GeoIPHub lädt 19 offizielle Range-Dateien von 10 Betreibern. 17 davon stehen in dieser Liste; die anderen beiden sind duckduckbot.json, identisch mit der DuckDuckGo-Datei unten, und Ahrefs, das kein KI-Bot ist. Die 22 Dateien sind 20 verschiedene Listen. Abgerufen am 9. November 2026 um 09:51 UTC, alle mit HTTP 200:
1. GPTBot
- Datei: gptbot.json
- IPv4- / IPv6-Präfixe: 18 / 0
creationTime: 2026-09-22- Geladen: ja
2. OAI-SearchBot
- Datei: searchbot.json
- IPv4- / IPv6-Präfixe: 39 / 0
creationTime: 2026-01-02- Geladen: ja
3. ChatGPT-User
- Datei: chatgpt-user.json
- IPv4- / IPv6-Präfixe: 237 / 0
creationTime: 2026-11-06- Geladen: ja
4. OAI-AdsBot
- Datei: adsbot.json
- IPv4- / IPv6-Präfixe: 2 / 0
creationTime: 2026-05-12- Geladen: nein
5. ClaudeBot, Claude-User, Claude-SearchBot
- Datei: bots.json
- IPv4- / IPv6-Präfixe: 14 / 0
creationTime: 2026-10-20- Geladen: ja
6. Claude-Agent
- Datei: sail (TOML)
- IPv4- / IPv6-Präfixe: 9 / 0
creationTime: geändert 2026-10-22- Geladen: nein
7. Googlebot und Common Crawlers, darunter Google-CloudVertexBot
- Datei: common-crawlers.json
- IPv4- / IPv6-Präfixe: 170 / 147
creationTime: 2026-11-06- Geladen: ja
8. Sonderfall-Crawler
- Datei: special-crawlers.json
- IPv4- / IPv6-Präfixe: 136 / 136
creationTime: 2026-11-06- Geladen: ja
9. Nutzerausgelöste Fetcher
- Datei: user-triggered-fetchers.json
- IPv4- / IPv6-Präfixe: 544 / 544
creationTime: 2026-11-06- Geladen: ja
10. Nutzerausgelöste Fetcher (google.com)
- Datei: user-triggered-fetchers-google.json
- IPv4- / IPv6-Präfixe: 252 / 252
creationTime: 2026-11-06- Geladen: ja
11. Google-Agent
- Datei: user-triggered-agents.json
- IPv4- / IPv6-Präfixe: 12 / 8
creationTime: 2026-11-06- Geladen: ja
12. PerplexityBot
- Datei: perplexitybot.json
- IPv4- / IPv6-Präfixe: 13 / 0
creationTime: 2026-10-28- Geladen: ja
13. Perplexity-User
- Datei: perplexity-user.json
- IPv4- / IPv6-Präfixe: 10 / 0
creationTime: 2026-10-28- Geladen: ja
14. MistralAI-User
- Datei: mistralai-user-ips.json
- IPv4- / IPv6-Präfixe: 4 / 0
creationTime: 2025-02-19- Geladen: ja
15. MistralAI-Index
- Datei: mistralai-index-ips.json
- IPv4- / IPv6-Präfixe: 2 / 0
creationTime: 2026-04-19- Geladen: ja
16. Bingbot
- Datei: bingbot.json
- IPv4- / IPv6-Präfixe: 29 / 0
creationTime: 2024-01-03- Geladen: ja
17. Applebot
- Datei: applebot.json
- IPv4- / IPv6-Präfixe: 24 / 0
creationTime: 2026-09-15- Geladen: ja
18. DuckAssistBot (dieselbe Liste wie duckduckbot.json)
- Datei: duckassistbot.json
- IPv4- / IPv6-Präfixe: 486 / 0
creationTime: 2026-09-01- Geladen: ja
19. CCBot
- Datei: ccbot.json
- IPv4- / IPv6-Präfixe: 4 / 1
creationTime: 2026-08-11- Geladen: ja
20. KimiBot
- Datei: kimibot.json
- IPv4- / IPv6-Präfixe: 4 / 0
creationTime: 2026-05-18- Geladen: nein
21. Kimi-User
- Datei: kimi-user.json
- IPv4- / IPv6-Präfixe: 4 / 0
creationTime: 2026-05-18- Geladen: nein
22. Kimi-SearchBot
- Datei: kimi-searchbot.json
- IPv4- / IPv6-Präfixe: 4 / 0
creationTime: 2026-05-18- Geladen: nein
Das Datum einer Datei beweist nicht, dass die Liste unverändert ist: Die Datei von Bingbot ging von 28 auf 29 Präfixe, während ihr Datum bei 2024-01-03 blieb. Wir zählten 28 in unserem Beitrag vom 29. Oktober und 29 am 9. November, und wir haben keine frühere Kopie, können also nicht sagen, welches Präfix hinzukam. Die Sonderfall- und die nutzerausgelösten Dateien von Google decken auch Fetcher ab, die keine KI sind; Google führt seine KI-Fetcher darunter auf.
Die drei Seiten von Amazon sind keine Dateien. developer.amazon.com/amazonbot/ip-addresses/ (Amazonbot), .../searchbot-ip-addresses/ (Amzn-SearchBot) und .../live-ip-addresses/ (Amzn-User) tragen eingebettete creationTime-Werte von 2026-09-08, 2026-09-08 und 2025-11-04. Wir laden sie nicht. Die zwei Dateien von DuckDuckGo haben denselben MD5-Hash, ebenso die drei von Kimi. Die eine Datei von Anthropic deckt drei Bots ab, und Anthropic sagt: „Wenn ein Crawler eine Quell-IP-Adresse hat, die auf dieser Liste steht, bedeutet das, dass der Crawler von Anthropic kommt.“
Sechs Präfixe sind an diesem Datum in gptbot.json und searchbot.json identisch: 4.227.36.0/25, 74.7.175.128/25, 74.7.228.0/25, 74.7.230.0/25, 74.7.241.128/25 und 74.7.244.0/25. chatgpt-user.json teilt keines davon mit ihnen. Unsere verifizierte Crawler-IP-Liste zeigt, wie sich aus diesen Dateien eine Allowlist bauen lässt.
Welche KI-Bots kann GeoIPHub verifizieren? 16 von 29 am 9. November
Die API von GeoIPHub verifiziert eine Adresse, wenn sie in einer Datei liegt, die wir laden, und das beweist den Betreiber, nicht den Bot. Wir haben aus 14 der 17 Dateien, die wir laden (alle außer der Sonderfall-Datei von Google und ihren beiden Dateien für nutzerausgelöste Fetcher), je eine echte Adresse abgefragt, dazu drei Kontrastfälle, ohne API-Schlüssel, im Abstand von etwa 14 Sekunden, am 9. November 2026 von 09:52 bis 09:55 UTC. Jede verifizierte Abfrage gab außerdem verification_method: "ip_range_list", scoring.recommended_action: "allow" und einen fraud_score von 0 zurück.
OAI-SearchBot
- Adresse (aus Datei): 4.227.36.1 (searchbot.json und gptbot.json)
verified: truename: OAISearchBotoperator: OpenAIcategory: ai- UTC: 09:52:11
GPTBot
- Adresse (aus Datei): 132.196.86.1 (gptbot.json)
verified: truename: GPTBotoperator: OpenAIcategory: ai- UTC: 09:52:25
ChatGPT-User
- Adresse (aus Datei): 104.208.184.193
verified: truename: ChatGPTUseroperator: OpenAIcategory: ai- UTC: 09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- Adresse (aus Datei): 216.73.216.10 (bots.json)
verified: truename: ClaudeBotoperator: Anthropiccategory: ai- UTC: 09:52:52
PerplexityBot
- Adresse (aus Datei): 107.20.236.150
verified: truename: PerplexityBotoperator: Perplexitycategory: ai- UTC: 09:53:06
Perplexity-User
- Adresse (aus Datei): 18.97.43.80
verified: truename: PerplexityUseroperator: Perplexitycategory: ai- UTC: 09:53:20
MistralAI-User
- Adresse (aus Datei): 20.240.160.161
verified: truename: MistralAIUseroperator: Mistralcategory: ai- UTC: 09:53:33
MistralAI-Index
- Adresse (aus Datei): 135.225.57.92
verified: truename: MistralAIIndexoperator: Mistralcategory: ai- UTC: 09:53:47
Google-Agent
- Adresse (aus Datei): 136.121.16.1
verified: truename: GoogleUserTriggeredAgentoperator: Googlecategory: ai- UTC: 09:54:01
Google-CloudVertexBot
- Adresse (aus Datei): 192.178.4.1 (common-crawlers.json)
verified: truename: Googlebotoperator: Googlecategory: search_engine- UTC: 09:54:15
DuckAssistBot
- Adresse (aus Datei): 104.43.54.127
verified: truename: DuckAssistBotoperator: DuckDuckGocategory: ai- UTC: 09:54:30
CCBot
- Adresse (aus Datei): 18.97.9.169
verified: truename: CCBotoperator: CommonCrawlcategory: archiver- UTC: 09:54:46
Applebot
- Adresse (aus Datei): 17.241.208.161
verified: truename: Applebotoperator: Applecategory: search_engine- UTC: 09:55:00
Bingbot
- Adresse (aus Datei): 157.55.39.1
verified: truename: Bingbotoperator: Microsoftcategory: search_engine- UTC: 09:55:14
OAI-AdsBot (Datei nicht geladen)
- Adresse (aus Datei): 130.131.229.129 (adsbot.json)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC: 09:55:28
Amazonbot (Seite nicht geladen)
- Adresse (aus Datei): 3.81.245.78 (Seite von Amazon)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC: 09:55:42
Meta (Netz, keine Datei)
- Adresse (aus Datei): 31.13.64.1
verified: false,unverified: truename: Facebook-Botoperator: Metacategory: social_preview- UTC: 09:55:56
Die Fallstricke stecken im Feld name. name ist die Bezeichnung der Datei, die zuletzt geladen wurde, daher geben alle drei Bots von Anthropic ClaudeBot zurück, DuckDuckBot-Adressen geben DuckAssistBot zurück und Google-CloudVertexBot gibt Googlebot zurück. category ist kein Aufgabenfeld: CCBot gibt archiver zurück, Applebot und Bingbot geben search_engine zurück. Schlüsseln Sie nach dem behaupteten Token plus operator, und schreiben Sie CommonCrawl ohne Leerzeichen.
Die Überraschung war 4.227.36.1. Die Adresse liegt in 4.227.36.0/25, das sowohl gptbot.json als auch searchbot.json aufführen. Eine gekürzte Kopie der echten Antwort:
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
Wir behaupten nicht, dass eine GPTBot-Anfrage OAISearchBot zurückgibt. Die Adresse, die in beiden Dateien steht, gibt diesen Namen zurück, und unsere Abfrage kann nicht erkennen, welcher Bot eine Anfrage gesendet hat. OpenAI selbst sagt, es „verwendet möglicherweise die Ergebnisse nur eines Crawls für beide Anwendungsfälle“. Die IP beweist OpenAI und der User-Agent sagt, welcher Bot es ist; der OpenAI-Beitrag behandelt, was die einzelnen OpenAI-Bots tun.
Die nicht geladenen Fälle sind eindeutig. Die Datei von OAI-AdsBot ist veröffentlicht und 130.131.229.129 liegt darin, aber unsere API gibt is_crawler: false und eine Hosting-Antwort zurück (Score 15, allow, AS8075 Microsoft). Die eigene Seite von Amazonbot führt 3.81.245.78 auf, und die API gibt dieselbe Art von Antwort zurück (Score 16, allow, AS14618 Amazon). Nichts in unseren Daten unterscheidet einen echten OAI-AdsBot von jeder anderen Adresse in dieser Cloud. Die Adresse 31.13.64.1 von Meta liegt im Netz von Meta (AS32934), verified: false; wir haben nicht beobachtet, dass sie crawlt.
Die API gibt weder zurück, welche Datei gepasst hat, noch wann sie abgerufen wurde, und eine Abfrage sieht nie Ihren User-Agent. Details zu den Feldern stehen in den Crawler-Feldern, und Sie können eine Adresse samt User-Agent aus Ihren Logs in den Crawler-IP-Verifizierer einfügen. Er liest threat.crawler.verified und gleicht den Betreiber im Browser mit dem Bot ab, den Ihr User-Agent nennt.
Eine IP aus Ihren Logs gegen die richtige Datei prüfen
Dieses Snippet nimmt die IP einer Logzeile und den User-Agent, den sie behauptet, lädt nur die Datei des Bots, den der User-Agent nennt, und meldet, ob die Adresse darin steht und welche anderen Dateien sie ebenfalls aufführen. Es trifft keine Allow- oder Block-Entscheidung und schreibt keine Liste. Es ist ein Beispiel, kein Parser: Ein User-Agent mit zwei Bot-Tokens passt auf das längste.
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
Jede Logzeile hat die Form <ip> <User-Agent>. Wir haben es am 9. November 2026 um 10:01 UTC mit diesem Beispiel ausgeführt, in dem 45.33.32.156 der öffentliche Scan-Host von Nmap ist (er hat keine solche Anfrage gesendet) und 203.0.113.9 sowie 2001:db8::1 Dokumentationsadressen sind:
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
OAI-AdsBot besteht hier, weil das Snippet die Datei selbst liest, auch wenn unsere API sie nicht lädt. Ein User-Agent-Token wird einer Datei zugeordnet, nach der Regel von Perplexity: „Jeder Bot hat seine eigenen IP-Bereiche, gleichen Sie also jeden User-Agent mit seinen eigenen IP-Bereichen ab.“ Eine nicht erreichbare Datei bedeutet „nicht verifiziert“, nie „verifiziert“: Mit einem SSL_CERT_FILE, das auf einen nicht existierenden Pfad zeigte, gab jede Zeile not verified: ... file unavailable aus. Eine ungültige IP-Zeichenfolge gibt „not verified“ aus, statt den Lauf zu beenden. Das Snippet setzt seinen eigenen User-Agent, weil claude.com am 9. November 2026 auf den Standard-User-Agent von Python mit 403 antwortete, während die anderen Dateien 200 lieferten.
Für die Bots ohne Datei stehen die Methoden in so verifizieren Sie KI-Crawler und Agenten: Reverse DNS und Signaturen. Google sagt, es „experimentiert auch mit dem Web-Bot-Auth-Protokoll“ und nutzt dafür die Identität https://agent.bot.goog, und YouBot veröffentlicht ein Signaturverzeichnis.
Namen, die nie in Ihren Logs erscheinen, und Bots, die wir nicht belegen konnten
Manche Namen auf anderen Listen sind keine Crawler oder haben keine Betreiberseite, die wir öffnen konnten. Drei sind Steuer-Tokens, die nie als Anfragender auftreten, daher kann keines davon geloggt oder per IP verifiziert werden.
Google-Extended (Google)
- In Ihren Logs?: Nein
- Wortlaut des Betreibers: „Google-Extended hat keinen eigenen HTTP-Anfrage-User-Agent-String. Das Crawling erfolgt mit bestehenden Google-User-Agent-Strings; das robots.txt-User-Agent-Token wird in einer Steuerfunktion verwendet.“
- Beachtet von: Google
Applebot-Extended (Apple)
- In Ihren Logs?: Nein
- Wortlaut des Betreibers: „Applebot-Extended crawlt keine Webseiten.“ und „Applebot-Extended wird nur verwendet, um zu bestimmen, wie die vom User-Agent Applebot gecrawlten Daten verwendet werden.“
- Beachtet von: Apple
__usage_ai-training (gemeinsam (IETF-aipref-Entwurf))
- In Ihren Logs?: Nein, es ist ein Gruppenname in der robots.txt
- Wortlaut des Betreibers: Microsoft: „Ab dem 1. Februar 2027 wird Microsoft die neuen Präferenzen beim Crawlen beachten“. Google: „beabsichtigt, das gemeinsame maschinenlesbare Trainingspräferenz-Signal AIPREF (mit ‚user-agent: __usage_ai-training‘) Anfang 2027 zu unterstützen“. Anthropic: „Seit dem 30. Oktober 2026 erkennt Anthropic ein maschinenlesbares Signal an“
- Beachtet von: Anthropic ab 2026-10-30 (seine Seite nennt das Token nicht); Microsoft ab 2027-02-01; Google „Anfang 2027“ (Absicht); OpenAI nicht verifiziert
Die Seite von Anthropic sagt, ihr Signal beruhe auf „einem Entwurf, der auf Arbeiten der IETF ... in ihrer aipref-Arbeitsgruppe basiert“. Die Hilfeseiten von OpenAI konnten wir nicht öffnen, daher treffen wir keine Aussage über OpenAI.
Am 9. November 2026 konnten wir für die folgenden Bots keine vom Betreiber geführte Seite finden. Diese Liste sagt, was wir geprüft haben. Ein Bot, der hier fehlt, kann dennoch existieren; wir behaupten nicht, dass diese Betreiber keinen Crawler betreiben.
ByteDance: Bytespider
- Was wir am 2026-11-09 geprüft haben: bytedance.com/robots.txt; bytedance.com/en/bytespider (404); bytespider.bytedance.com (kein DNS); Startseite von zhanzhang.toutiao.com (kein Crawler-Text)
- Ergebnis: Keine ByteDance-Seite gefunden. Dritte sind uneins, ob Bereiche existieren, daher nennen wir weder Aufgabe noch Bereich
xAI: Grok-bezogene Tokens
- Was wir am 2026-11-09 geprüft haben: docs.x.ai/llms.txt (kein Crawler- oder robots.txt-Text); docs.x.ai/docs/crawler (404); x.ai/grok-bot.json (403)
- Ergebnis: Nichts gefunden
Cohere: cohere-ai, cohere-training-data-crawler
- Was wir am 2026-11-09 geprüft haben: docs.cohere.com/docs/cohere-web-crawlers (öffnet sich; die Bot-Tabelle lautet „N/A“); cohere.com/crawler (404); cohere.com/cohere-ai.json (404)
- Ergebnis: Die Seite sagt: „Wir verwenden Cohere-Bots oder User-Agents derzeit nicht zum Crawlen oder Scrapen von Webinhalten, um generative KI-Basismodelle zu trainieren.“
DeepSeek: DeepSeekBot
- Was wir am 2026-11-09 geprüft haben: deepseek.com/robots.txt; api-docs.deepseek.com/llms.txt (keine Treffer); deepseek.com/deepseekbot.json (404)
- Ergebnis: Nichts gefunden
Einige Namen sind veraltet. anthropic-ai und Claude-Web stehen nicht auf der Seite von Anthropic, FacebookBot steht nicht auf der Seite von Meta, und Gemini-Deep-Research erscheint auf keiner der vier Crawler-Seiten von Google, die wir gelesen haben. Sie sind auf den gelesenen Seiten nicht dokumentiert, daher führen wir keinen davon als Bot.
Wie diese Liste geprüft wurde und wie sie sich ändert
GeoIPHub hat diese KI-Crawler-Liste geprüft, indem es die Seite jedes Betreibers öffnete, jede Datei abrief, nachzählte und die obigen Abfragen ausführte. Das Datum eines Eintrags ändert sich nur, wenn wir genau diesen Eintrag erneut prüfen.
Änderungen, die wir sahen, jeweils mit Datum: Die Datei von Bingbot ging von 28 auf 29 Präfixe unter einem eingefrorenen Datum 2024-01-03. Die Datei von ChatGPT-User hatte 234 Präfixe, dann 235 am 29. Oktober, dann 237 in einer Datei mit dem Datum 6. November 2026. Die zwei Dateien von Perplexity hatten am 27. Oktober 4 und 8 Präfixe und am 28. Oktober 10 und 13. Die Datei von Anthropic hatte in unserem Beitrag zum Blockieren von KI-Crawlern 38 Präfixe (Datei vom 7. Oktober) und hat jetzt 14, datiert auf den 20. Oktober. Wir nennen keinen Aktualisierungsrhythmus, weder für Betreiber noch für unsere API. Die API gibt das Abrufdatum nicht zurück, daher verifiziert ein kürzlich vom Betreiber hinzugefügtes Präfix möglicherweise noch nicht.
Der Name im Header ist eine Behauptung, und der Nachweis ist die Datei des Betreibers, sofern der Betreiber eine veröffentlicht.
Häufig gestellte Fragen
Was ist eine KI-Crawler-Liste?
Eine Liste der automatisierten Clients, die KI-Unternehmen und Suchprodukte betreiben, um Webseiten abzurufen, mit dem User-Agent jedes Clients, seiner Aufgabe (Training, Suche, nutzerausgelöster Abruf oder Agent) und der Art, wie er sich nachweisen lässt. Am 9. November 2026 enthält die Liste von GeoIPHub 29 Bots, die Betreiber dokumentieren, und die API von GeoIPHub verifiziert 16 davon per IP.
Was ist der Unterschied zwischen GPTBot und ClaudeBot?
GPTBot ist der Trainings-Crawler von OpenAI und ClaudeBot der von Anthropic. Beide veröffentlichen eine Range-Datei, und die eine Datei von Anthropic deckt auch Claude-User und Claude-SearchBot ab. Die API von GeoIPHub verifiziert eine Adresse aus beiden Dateien. Was die einzelnen OpenAI-Bots tun, behandelt GPTBot vs OAI-SearchBot vs ChatGPT-User.
Welche KI-Crawler veröffentlichen IP-Bereiche?
Am 9. November 2026 veröffentlichen zehn Betreiber 22 Range-Dateien für KI-Bots, die wir finden konnten: OpenAI, Anthropic, Google, Perplexity, Mistral, Microsoft, Apple, DuckDuckGo, Common Crawl und Moonshot. GeoIPHub lädt 17 davon. Amazon führt Adressen auf Webseiten auf, und Meta und MistralAI-Training veröffentlichen keine.
Kann ich einen KI-Crawler anhand seines User-Agents verifizieren?
Nein. Ein User-Agent ist ein String, den jeder Client senden kann. Die Abfrage von GeoIPHub nimmt nur die IP entgegen: Sie kann Ihnen sagen, dass die Adresse in der Datei von OpenAI oder Anthropic steht, und Ihr eigener Code vergleicht diesen Betreiber mit dem Bot, den der User-Agent nennt.
Welchen User-Agent verwendet der KI-Crawler von Meta?
Meta dokumentiert meta-externalagent/1.1 für das Training, meta-webindexer/1.1 für die Meta-AI-Suche und meta-externalfetcher/1.1 für vom Nutzer angeforderte Abrufe. Meta veröffentlicht keine Range-Datei, daher ordnet GeoIPHub sein Netz per ASN zu und gibt verified: false zurück.
Ist CCBot ein KI-Crawler?
CCBot ist der Crawler von Common Crawl, und Common Crawl veröffentlicht dafür eine IP-Datei und Reverse DNS. Andere Listen nennen ihn einen KI-Crawler, weil das Archiv, das er aufbaut, für Training genutzt werden kann; diese Verbindung stammt von ihnen, nicht aus einer Aussage von Common Crawl. GeoIPHub verifiziert seine Datei und gibt die Kategorie archiver zurück.
Das Team hinter der GeoIPHub-API
Verfasst vom GeoIPHub-Team, den Menschen, die die GeoIPHub-API für IP-Intelligence und ihren Scanner entwickeln. Entwürfe entstehen mit KI-Unterstützung und werden vom Team redigiert; API-Beispiele sind echte Abfragen gegen die Live-API, sofern nicht als illustrativ gekennzeichnet.
 IP-Intelligence