网络安全
AI 爬虫列表:29 个 bot 的 User-Agent,以及哪些可以按 IP 验证
按用途整理的 29 个 AI 爬虫列表,含 User-Agent、robots.txt 原话和 IP 段文件,以及 GeoIPHub 可按 IP 验证的 16 个 bot,核对日期为 2026 年 11 月 9 日。
范围:我们在 2026 年 11 月 9 日能够打开的页面上,由运营方记录并用于 AI 的 bot。Meta 还记录了 meta-externalads,这是一个广告爬虫,我们没有计入。在其他列表中流传、但运营方没有文档的名称,列在单独的列表中,并附上我们核对的内容。
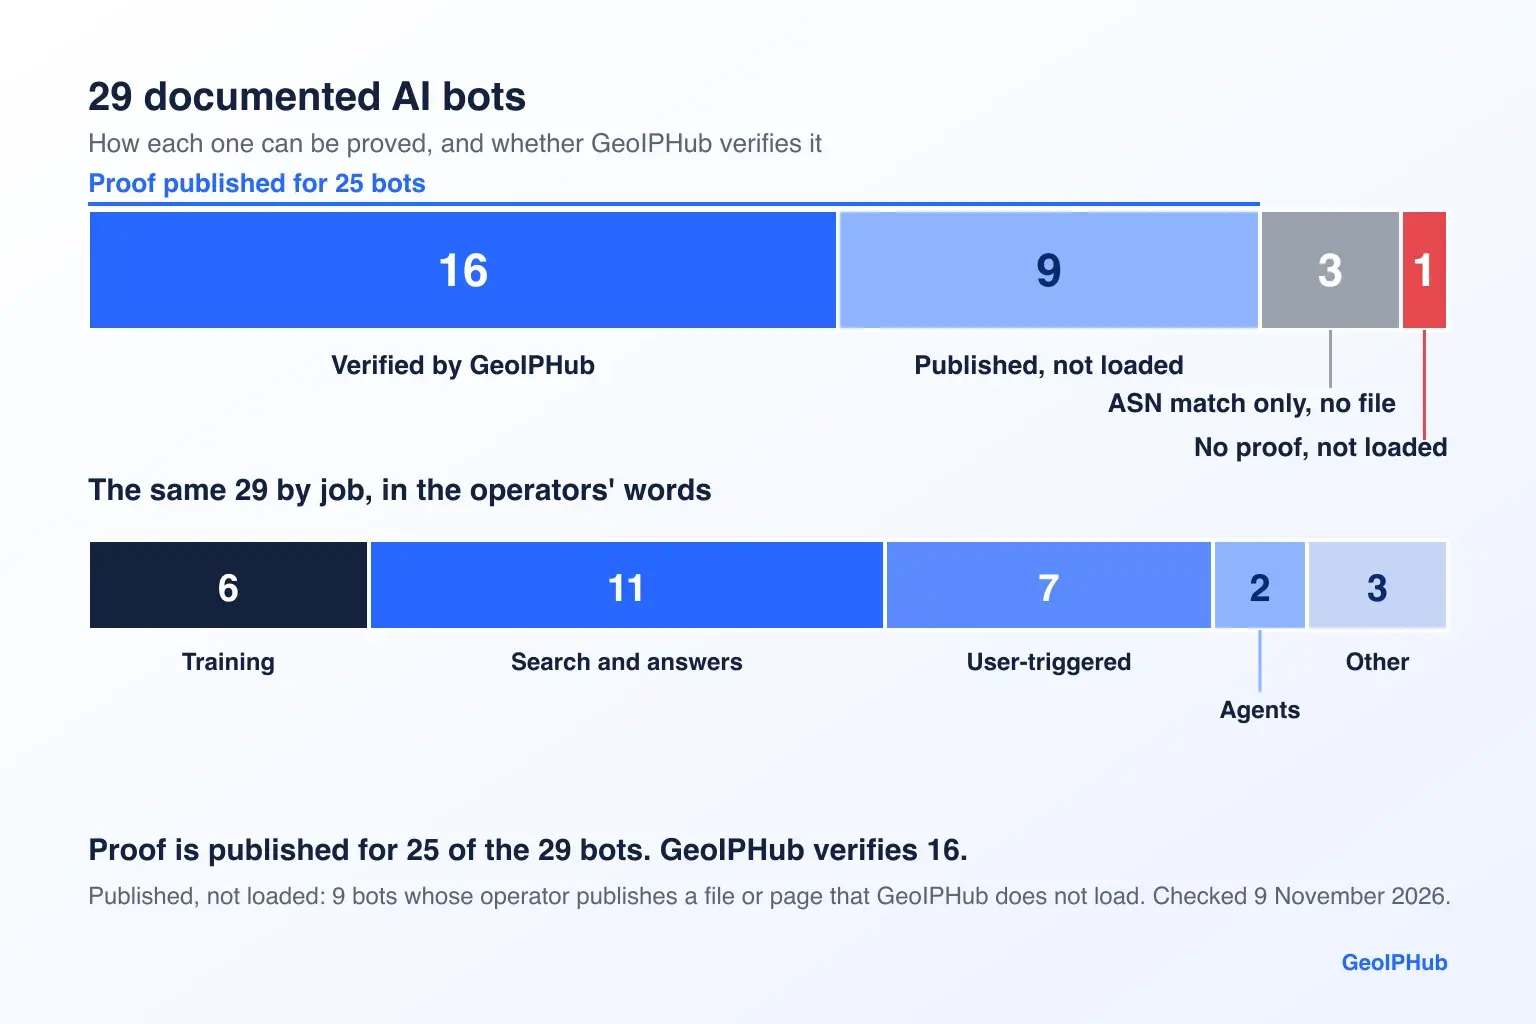
运营方为这 29 个 bot 中的 25 个公布了证明方式。GeoIPHub 的 API 验证其中 16 个。其余 9 个并不是运营方文档中的缺口:它们是我们没有加载的文件和页面,列表会说明是哪些。
其他列表只给出名称和 token,但 User-Agent 头里的名称什么也证明不了,因为任何人都可以随便写。运营方提供的证明有五种形式:JSON 文件、列有地址的网页、反向 DNS、签名,或者什么都没有。本文是我们 基于 IP 的 bot 检测 工作的一部分。下文依次介绍:按用途划分的各个 bot、22 份 IP 段文件及其数量和日期、GeoIPHub 的 API 针对我们加载的文件中 14 份里的真实地址返回了什么、一段用来对照正确文件检查日志行的代码,以及那些不会出现在您日志中或我们无法找到来源的名称。
AI 爬虫列表:按用途划分的 29 个 bot
这份 AI 爬虫列表把 29 个已记录的 bot 及其 AI 爬虫 User-Agent,按运营方声明的用途分类:训练、搜索、用户触发抓取、agent,以及一小组不属于上述任何一类的 bot。每个条目都用到四个术语。证明指运营方公布的内容:IP 段文件、列有地址的网页、反向 DNS、签名,或者什么都没有。已验证指在所示日期,来自该 bot 自己文件的地址在 GeoIPHub 的 API 中返回了 verified: true。仅 ASN 匹配指我们匹配运营方的网络,并返回 verified: false。未加载指我们没有加载该运营方的列表。
分组依据的是运营方自己的说法,并不是泾渭分明的。OpenAI 说“如果您的网站允许这两个 bot,我们可能只用一次抓取的结果同时满足两种用途”("If your site has allowed both bots, we may use the results from just one crawl for both use cases")。Meta 说“用于训练等用途”。Amazon 说“可能被用于训练”。Apple 的爬虫首先服务于搜索,同时“也可能被用来帮助训练”其模型。Cloudflare 的 bot 文档划分出同样的三类:Search(“抓取内容以构建搜索索引或 RAG 数据库”)、Agent(“代表人类访问页面的、由用户指挥的 agent”)和 Training(“抓取内容以训练或微调模型”)。
哪些 AI 爬虫用于训练模型?
按运营方自己的说法,有 6 个。
GPTBot (OpenAI)
- UA 片段:GPTBot/1.4
- 证明:文件
- robots.txt,运营方原话:“禁止 GPTBot 表示该网站的内容不应被用于训练生成式 AI 基础模型。”
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
ClaudeBot (Anthropic)
- UA 片段:ClaudeBot
- 证明:文件(共享)
- robots.txt,运营方原话:“Anthropic 的 bot 遵守‘请勿抓取’信号,会遵循 robots.txt 中的行业标准指令。”
- GeoIPHub 验证:已验证(以 Anthropic 名义)
- 核对日期:2026-11-09
MistralAI-Training (Mistral)
- UA 片段:MistralAI-Training/1.0
- 证明:无
- robots.txt,运营方原话:“网站管理员可以在其 robots.txt 文件中禁止这个 user agent。”
- GeoIPHub 验证:未加载(mistralai-training-ips.json 返回 404)
- 核对日期:2026-11-09
meta-externalagent (Meta)
- UA 片段:meta-externalagent/1.1
- 证明:无
- robots.txt,运营方原话:“要屏蔽这些爬虫,请在 robots.txt 中为相应的爬虫添加 disallow。”
- GeoIPHub 验证:仅 ASN 匹配,未验证
- 核对日期:2026-11-09
Amazonbot (Amazon)
- UA 片段:Amazonbot/0.1
- 证明:仅网页
- robots.txt,运营方原话:“来自这些所列 user agent 的自动抓取遵守 Robots Exclusion Protocol,会遵循 user-agent 以及 allow/disallow 指令。”
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
KimiBot (Moonshot)
- UA 片段:KimiBot/1.0
- 证明:文件(一份文件,三个名称)
- robots.txt,运营方原话:未引用
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
用途,用运营方自己的话说:GPTBot“用于抓取可能被用于训练我们生成式 AI 基础模型的内容”。MistralAI-Training“抓取网页内容,帮助构建用于训练 Mistral 生成式 AI 模型的数据集”。KimiBot“抓取可能用于训练 Kimi 基础模型的内容”。
哪些 AI 爬虫支撑搜索和回答?
有 11 个,其中包括两个位于我们已加载集合中的传统搜索爬虫。
OAI-SearchBot (OpenAI)
- UA 片段:OAI-SearchBot/1.4
- 证明:文件
- robots.txt,运营方原话:“选择退出 OAI-SearchBot 的网站不会出现在 ChatGPT 搜索答案中”
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
Claude-SearchBot (Anthropic)
- UA 片段:Claude-SearchBot
- 证明:文件(共享)
- robots.txt,运营方原话:与 ClaudeBot 相同的 Anthropic 那句话
- GeoIPHub 验证:已验证(以 Anthropic 名义)
- 核对日期:2026-11-09
PerplexityBot (Perplexity)
- UA 片段:PerplexityBot/1.0
- 证明:文件
- robots.txt,运营方原话:未引用
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
MistralAI-Index (Mistral)
- UA 片段:MistralAI-Index/1.0
- 证明:文件
- robots.txt,运营方原话:未引用
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
meta-webindexer (Meta)
- UA 片段:meta-webindexer/1.1
- 证明:无
- robots.txt,运营方原话:与 meta-externalagent 相同的 Meta 那句话
- GeoIPHub 验证:仅 ASN 匹配,未验证
- 核对日期:2026-11-09
Amzn-SearchBot (Amazon)
- UA 片段:Amzn-SearchBot/0.1
- 证明:仅网页
- robots.txt,运营方原话:“如果 robots.txt 文件没有提及 Amzn-SearchBot,但允许其他搜索 bot,Amzn-SearchBot 将按照给其他搜索 bot 的 robots.txt 指令进行抓取。”
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
Applebot (Apple)
- UA 片段:Applebot/0.1
- 证明:文件 + 反向 DNS
- robots.txt,运营方原话:“在针对 Applebot 的一般搜索抓取中,Applebot 通常遵守标准的 robots.txt 指令。”
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
Bingbot (Microsoft)
- UA 片段:Bingbot
- 证明:文件
- robots.txt,运营方原话:未引用(Microsoft 的页面需要 JavaScript,因此我们无法读取)
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
DuckAssistBot (DuckDuckGo)
- UA 片段:DuckAssistBot/1.2
- 证明:文件
- robots.txt,运营方原话:“将文件更新为禁止 DuckAssistBot user agent 后,更改将在 72 小时后生效,DuckAssistBot 将停止抓取您的网站。”
- GeoIPHub 验证:已验证(DuckDuckBot 的地址也会返回这个名称)
- 核对日期:2026-11-09
Kimi-SearchBot (Moonshot)
- UA 片段:Kimi-SearchBot/1.0
- 证明:文件(共享)
- robots.txt,运营方原话:未引用
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
YouBot (You.com)
- UA 片段:YouBot/1.0
- 证明:签名 + 反向 DNS + 仅网页(一个 /24)
- robots.txt,运营方原话:“它遵守 robots.txt 指令和抓取速率偏好”
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
Bingbot 和 Applebot 之所以列在这里,是因为它们在我们已加载的集合中,而且 Apple 说其爬虫可能帮助训练其模型。我们无法读取需要 JavaScript 的 Microsoft 爬虫页面,但它 10 月 30 日的文章是通过 Bingbot 来设置 AI 偏好的。YouBot 是唯一一个条目有三种证明的:位于 you.com/.well-known/http-message-signatures-directory 的签名目录,形如 youbot-68-67-112-106 的反向 DNS,以及声明“合法的 YouBot 请求来自 68.67.112.0/24。”
用途,用运营方自己的话说:PerplexityBot“旨在在 Perplexity 的搜索结果中呈现并链接网站。它不用于为 AI 基础模型抓取内容。”MistralAI-Index“仅用于出于索引目的自动抓取网页”。DuckAssistBot“实时抓取页面,用于我们的 AI 辅助回答”,并且“这些数据不会以任何方式用于训练 AI 模型。”
哪些 AI 爬虫在用户提出要求时抓取页面?
有 7 个,另外还有 Google 的用户触发型 fetcher。
ChatGPT-User (OpenAI)
- UA 片段:ChatGPT-User/1.0
- 证明:文件
- robots.txt,运营方原话:“由于这些操作由用户发起,robots.txt 规则可能不适用。”
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
Claude-User (Anthropic)
- UA 片段:Claude-User
- 证明:文件(共享)
- robots.txt,运营方原话:Anthropic 对其所有 bot 的那句话(见 ClaudeBot);未发现针对用户触发的例外
- GeoIPHub 验证:已验证(以 Anthropic 名义)
- 核对日期:2026-11-09
Perplexity-User (Perplexity)
- UA 片段:Perplexity-User/1.0
- 证明:文件
- robots.txt,运营方原话:“由于是用户请求了这次抓取,这个 fetcher 通常会忽略 robots.txt 规则。”
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
MistralAI-User (Mistral)
- UA 片段:MistralAI-User/1.0
- 证明:文件
- robots.txt,运营方原话:“MistralAI-User 决定这些用户请求可以访问哪些网站。”
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
meta-externalfetcher (Meta)
- UA 片段:meta-externalfetcher/1.1
- 证明:无
- robots.txt,运营方原话:“可能绕过 robots.txt,因为它执行的是用户请求的抓取”
- GeoIPHub 验证:仅 ASN 匹配,未验证
- 核对日期:2026-11-09
Amzn-User (Amazon)
- UA 片段:Amzn-User/0.1
- 证明:仅网页
- robots.txt,运营方原话:“由于 Amzn-User 的操作可能由用户发起,它可能不会遵循所有 robots.txt 指令。”
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
Kimi-User (Moonshot)
- UA 片段:Kimi-User/1.0
- 证明:文件(共享)
- robots.txt,运营方原话:“由于这些操作由用户触发,robots.txt 规则可能不直接适用”
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
Google 的页面还提到了 Google-GeminiNotebook,它“请求 Gemini Notebook 用户作为来源提供的单个 URL”。页面没有说明 Google 的哪份用户触发型 IP 段文件列出了它,所以我们无法测试,也就没有把它放进列表。
哪些 AI bot 是 agent?
有 2 个,都被记录为代表用户浏览网页的 agent。
Google-Agent (Google)
- UA 片段:Google-Agent
- 证明:文件(+ 签名,试行中)
- robots.txt,运营方原话:用户触发型 fetcher“通常忽略 robots.txt 规则”(页面级声明)
- GeoIPHub 验证:已验证
- 核对日期:2026-11-09
Claude-Agent (Anthropic)
- UA 片段:Claude-Agent/1.0
- 证明:文件(SAIL,TOML,不是 JSON)
- robots.txt,运营方原话:“您对 Anthropic 的 robot(爬虫和 fetcher)的偏好是相互独立的,您可以分别管理它们。”(agent 页面没有说明浏览器本身如何处理 robots.txt)
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
Google-Agent“由托管在 Google 基础设施上的 agent 使用,在用户请求下浏览网页并执行操作”。对于 Claude-Agent,Anthropic 说要“匹配 Claude-Agent token,而不是完整字符串”。
哪些 AI bot 不属于以上任何一类?
有 3 个,运营方各自把它们记录为不同的用途。
OAI-AdsBot (OpenAI)
- UA 片段:OAI-AdsBot/1.0
- 证明:文件
- robots.txt,运营方原话:未引用(OpenAI 的页面上没有找到相关声明)
- GeoIPHub 验证:未加载
- 核对日期:2026-11-09
CCBot (Common Crawl)
- UA 片段:CCBot/2.0
- 证明:文件 + 反向 DNS
- robots.txt,运营方原话:页面给出
User-agent: CCBot和Disallow: / - GeoIPHub 验证:已验证(类别
archiver) - 核对日期:2026-11-09
Google-CloudVertexBot (Google)
- UA 片段:Google-CloudVertexBot
- 证明:文件(Google 的通用爬虫文件)
- robots.txt,运营方原话:未引用
- GeoIPHub 验证:已验证(共享的通用爬虫文件)
- 核对日期:2026-11-09
OAI-AdsBot“用于验证作为广告提交到 ChatGPT 的网页是否安全”。Google-CloudVertexBot“按网站所有者的请求进行抓取,用于构建 Vertex AI Agents”。Common Crawl 说“我们注意到有爬虫冒充 CCBot”。Cloudflare 的 AI Crawl Control 参考文档把 CCBot 列为 AI 爬虫;与训练的这一关联来自第三方,并非 Common Crawl 的说法。
屏蔽各类用途的 bot 要付出什么代价,见 屏蔽 AI 爬虫。
用户触发型 bot 对 robots.txt 的处理各不相同,运营方自己是这么说的
ChatGPT-User、Perplexity-User 和 Claude-User 这类 AI 用户触发型 bot 并不遵循同一条 robots.txt 规则:每家运营方的说法都不一样,其中一家甚至没有任何特殊说明。大多数运营方给出的理由是,这类抓取是在替某一个人行事。
- ChatGPT-User (OpenAI):“由于这些操作由用户发起,robots.txt 规则可能不适用。”
- Perplexity-User (Perplexity):“由于是用户请求了这次抓取,这个 fetcher 通常会忽略 robots.txt 规则。”
- 用户触发型 fetcher,包括 Google-Agent (Google):“由于这次抓取是由用户请求的,这些 fetcher 通常会忽略 robots.txt 规则。”
- meta-externalfetcher (Meta):“可能绕过 robots.txt,因为它执行的是用户请求的抓取”
- Amzn-User (Amazon):“由于 Amzn-User 的操作可能由用户发起,它可能不会遵循所有 robots.txt 指令。”
- Kimi-User (Moonshot):“由于这些操作由用户触发,robots.txt 规则可能不直接适用”
- MistralAI-User (Mistral):“MistralAI-User 决定这些用户请求可以访问哪些网站。”
- Claude-User (Anthropic):“Anthropic 的 bot 遵守‘请勿抓取’信号,会遵循 robots.txt 中的行业标准指令。”以及“Claude-User 允许网站所有者控制可以通过这些用户发起的请求访问哪些网站。”
Anthropic 是个例外:它的那句话没有给用户触发型 bot 留任何例外。“可能不适用”“通常忽略”“可能绕过”和“可能不会遵循所有”是四种强度不同的说法,所以对整个分组只用一条规则,会曲解其中大多数。
哪些 AI 爬虫公布了 IP 段?来自 10 家运营方的 22 份 IP 段文件
10 家运营方为我们能找到的 AI bot 公布了 22 份 IP 段文件;GeoIPHub 加载其中 17 份。这些 AI 爬虫 IP 段分为四种状态。OpenAI、Perplexity、Mistral 和 Google 的 agent 文件为每个 bot 各给一份 JSON 文件。Anthropic 的三个 bot 共用一份文件,Kimi 的三份文件以及 DuckDuckGo 的两份文件字节完全相同。Amazon 的三个 bot 只有网页,每个网页各有自己的 creationTime。Meta 和 MistralAI-Training 什么都没有公布,上一节中的那些运营方我们也没找到任何文件。Claude-Agent 以较新的格式发布,是位于 claude.com/.well-known/sail 的 TOML 文件(draft-kelley-webbotauth-sail-00)。ClaudeBot 和 PerplexityBot 的 IP 段会逐一追踪每个文件的一次真实查询。
GeoIPHub 加载来自 10 家运营方的 19 份官方 IP 段文件。其中 17 份在这份列表中;另外两份是 duckduckbot.json(与下面的 DuckDuckGo 文件相同)和 Ahrefs(它不是 AI bot)。这 22 份文件是 20 份互不相同的列表。2026 年 11 月 9 日 09:51 UTC 抓取,全部返回 HTTP 200:
1. GPTBot
- 文件:gptbot.json
- IPv4 / IPv6 前缀:18 / 0
creationTime:2026-09-22- 已加载:是
2. OAI-SearchBot
- 文件:searchbot.json
- IPv4 / IPv6 前缀:39 / 0
creationTime:2026-01-02- 已加载:是
3. ChatGPT-User
- 文件:chatgpt-user.json
- IPv4 / IPv6 前缀:237 / 0
creationTime:2026-11-06- 已加载:是
4. OAI-AdsBot
- 文件:adsbot.json
- IPv4 / IPv6 前缀:2 / 0
creationTime:2026-05-12- 已加载:否
5. ClaudeBot, Claude-User, Claude-SearchBot
- 文件:bots.json
- IPv4 / IPv6 前缀:14 / 0
creationTime:2026-10-20- 已加载:是
6. Claude-Agent
- 文件:sail (TOML)
- IPv4 / IPv6 前缀:9 / 0
creationTime:修改于 2026-10-22- 已加载:否
7. Googlebot 及通用爬虫,包括 Google-CloudVertexBot
- 文件:common-crawlers.json
- IPv4 / IPv6 前缀:170 / 147
creationTime:2026-11-06- 已加载:是
8. 特殊用途爬虫
- 文件:special-crawlers.json
- IPv4 / IPv6 前缀:136 / 136
creationTime:2026-11-06- 已加载:是
9. 用户触发型 fetcher
- 文件:user-triggered-fetchers.json
- IPv4 / IPv6 前缀:544 / 544
creationTime:2026-11-06- 已加载:是
10. 用户触发型 fetcher (google.com)
- 文件:user-triggered-fetchers-google.json
- IPv4 / IPv6 前缀:252 / 252
creationTime:2026-11-06- 已加载:是
11. Google-Agent
- 文件:user-triggered-agents.json
- IPv4 / IPv6 前缀:12 / 8
creationTime:2026-11-06- 已加载:是
12. PerplexityBot
- 文件:perplexitybot.json
- IPv4 / IPv6 前缀:13 / 0
creationTime:2026-10-28- 已加载:是
13. Perplexity-User
- 文件:perplexity-user.json
- IPv4 / IPv6 前缀:10 / 0
creationTime:2026-10-28- 已加载:是
14. MistralAI-User
- 文件:mistralai-user-ips.json
- IPv4 / IPv6 前缀:4 / 0
creationTime:2025-02-19- 已加载:是
15. MistralAI-Index
- 文件:mistralai-index-ips.json
- IPv4 / IPv6 前缀:2 / 0
creationTime:2026-04-19- 已加载:是
16. Bingbot
- 文件:bingbot.json
- IPv4 / IPv6 前缀:29 / 0
creationTime:2024-01-03- 已加载:是
17. Applebot
- 文件:applebot.json
- IPv4 / IPv6 前缀:24 / 0
creationTime:2026-09-15- 已加载:是
18. DuckAssistBot(与 duckduckbot.json 是同一份列表)
- 文件:duckassistbot.json
- IPv4 / IPv6 前缀:486 / 0
creationTime:2026-09-01- 已加载:是
19. CCBot
- 文件:ccbot.json
- IPv4 / IPv6 前缀:4 / 1
creationTime:2026-08-11- 已加载:是
20. KimiBot
- 文件:kimibot.json
- IPv4 / IPv6 前缀:4 / 0
creationTime:2026-05-18- 已加载:否
21. Kimi-User
- 文件:kimi-user.json
- IPv4 / IPv6 前缀:4 / 0
creationTime:2026-05-18- 已加载:否
22. Kimi-SearchBot
- 文件:kimi-searchbot.json
- IPv4 / IPv6 前缀:4 / 0
creationTime:2026-05-18- 已加载:否
文件日期并不能证明列表没有变化:Bingbot 的文件从 28 个前缀变成了 29 个,而日期仍是 2024-01-03。我们在 10 月 29 日的文章中数到 28 个,11 月 9 日数到 29 个,由于没有更早的副本,所以无法说明新增了哪个前缀。Google 的特殊用途文件和用户触发型文件也涵盖非 AI 的 fetcher;Google 把它的 AI fetcher 列在其中。
Amazon 的三个页面不是文件。developer.amazon.com/amazonbot/ip-addresses/(Amazonbot)、.../searchbot-ip-addresses/(Amzn-SearchBot)和 .../live-ip-addresses/(Amzn-User)内嵌的 creationTime 值分别是 2026-09-08、2026-09-08 和 2025-11-04。我们不加载它们。DuckDuckGo 的两份文件 MD5 哈希相同,Kimi 的三份也是如此。Anthropic 的一份文件覆盖三个 bot,并且 Anthropic 说“如果某个爬虫的源 IP 地址在这份列表上,就表明该爬虫来自 Anthropic。”
在这一天,gptbot.json 和 searchbot.json 中有六个前缀完全相同:4.227.36.0/25、74.7.175.128/25、74.7.228.0/25、74.7.230.0/25、74.7.241.128/25 和 74.7.244.0/25。chatgpt-user.json 与它们没有任何共同前缀。我们的 已验证爬虫 IP 列表 介绍了如何用这些文件构建白名单。
GeoIPHub 能验证哪些 AI bot?11 月 9 日 29 个中的 16 个
当一个地址位于我们加载的文件内时,GeoIPHub 的 API 会将其验证通过,而这证明的是运营方,不是 bot。我们从加载的 17 份文件中的 14 份(除 Google 的特殊用途文件及其两份用户触发型 fetcher 文件外)里各取了一个真实地址,另加三个对照案例,不使用密钥,每次间隔约 14 秒,于 2026 年 11 月 9 日 09:52 至 09:55 UTC 进行查询。每个已验证的查询还返回了 verification_method: "ip_range_list"、scoring.recommended_action: "allow" 以及为 0 的 fraud_score。
OAI-SearchBot
- 地址(来自文件):4.227.36.1 (searchbot.json 和 gptbot.json)
verified:truename:OAISearchBotoperator:OpenAIcategory:ai- UTC:09:52:11
GPTBot
- 地址(来自文件):132.196.86.1 (gptbot.json)
verified:truename:GPTBotoperator:OpenAIcategory:ai- UTC:09:52:25
ChatGPT-User
- 地址(来自文件):104.208.184.193
verified:truename:ChatGPTUseroperator:OpenAIcategory:ai- UTC:09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- 地址(来自文件):216.73.216.10 (bots.json)
verified:truename:ClaudeBotoperator:Anthropiccategory:ai- UTC:09:52:52
PerplexityBot
- 地址(来自文件):107.20.236.150
verified:truename:PerplexityBotoperator:Perplexitycategory:ai- UTC:09:53:06
Perplexity-User
- 地址(来自文件):18.97.43.80
verified:truename:PerplexityUseroperator:Perplexitycategory:ai- UTC:09:53:20
MistralAI-User
- 地址(来自文件):20.240.160.161
verified:truename:MistralAIUseroperator:Mistralcategory:ai- UTC:09:53:33
MistralAI-Index
- 地址(来自文件):135.225.57.92
verified:truename:MistralAIIndexoperator:Mistralcategory:ai- UTC:09:53:47
Google-Agent
- 地址(来自文件):136.121.16.1
verified:truename:GoogleUserTriggeredAgentoperator:Googlecategory:ai- UTC:09:54:01
Google-CloudVertexBot
- 地址(来自文件):192.178.4.1 (common-crawlers.json)
verified:truename:Googlebotoperator:Googlecategory:search_engine- UTC:09:54:15
DuckAssistBot
- 地址(来自文件):104.43.54.127
verified:truename:DuckAssistBotoperator:DuckDuckGocategory:ai- UTC:09:54:30
CCBot
- 地址(来自文件):18.97.9.169
verified:truename:CCBotoperator:CommonCrawlcategory:archiver- UTC:09:54:46
Applebot
- 地址(来自文件):17.241.208.161
verified:truename:Applebotoperator:Applecategory:search_engine- UTC:09:55:00
Bingbot
- 地址(来自文件):157.55.39.1
verified:truename:Bingbotoperator:Microsoftcategory:search_engine- UTC:09:55:14
OAI-AdsBot(文件未加载)
- 地址(来自文件):130.131.229.129 (adsbot.json)
verified:false,is_crawler: falsename:无operator:无category:无- UTC:09:55:28
Amazonbot(页面未加载)
- 地址(来自文件):3.81.245.78(Amazon 的页面)
verified:false,is_crawler: falsename:无operator:无category:无- UTC:09:55:42
Meta(网络,无文件)
- 地址(来自文件):31.13.64.1
verified:false,unverified: truename:Facebook-Botoperator:Metacategory:social_preview- UTC:09:55:56
陷阱就在 name 这一字段。name 是最后加载的那份文件的标签,所以 Anthropic 的三个 bot 都返回 ClaudeBot,DuckDuckBot 的地址返回 DuckAssistBot,Google-CloudVertexBot 返回 Googlebot。category 不是用途字段:CCBot 返回 archiver,Applebot 和 Bingbot 返回 search_engine。请以声称的 token 加上 operator 作为判断依据,并且把 CommonCrawl 写成中间没有空格。
出乎意料的是 4.227.36.1。它位于 4.227.36.0/25 之内,而 gptbot.json 和 searchbot.json 都列出了这个前缀。以下是真实响应的精简副本:
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
我们并不是说 GPTBot 的请求会返回 OAISearchBot。是这个同时位于两份文件中的地址返回了那个名称,而我们的查询无法判断是哪个 bot 发出了请求。OpenAI 自己也说它“可能只用一次抓取的结果同时满足两种用途”("may use the results from just one crawl for both use cases")。IP 证明的是 OpenAI,User-Agent 说明的是哪个 bot;OpenAI 那篇文章 介绍了 OpenAI 各个 bot 的具体作用。
未加载的情形很简单。OAI-AdsBot 的文件已经公布,130.131.229.129 也在其中,但我们的 API 返回 is_crawler: false 以及一个托管类的结果(评分 15,allow,AS8075 Microsoft)。Amazonbot 自己的页面列出了 3.81.245.78,API 返回同类结果(评分 16,allow,AS14618 Amazon)。我们的数据无法把真正的 OAI-AdsBot 与该云上的其他任何地址区分开。Meta 的 31.13.64.1 是 Meta 网络(AS32934)上的一个地址,verified: false;我们没有观察到它在抓取。
API 既不返回匹配的是哪份文件,也不返回该文件是何时抓取的,而且查询永远看不到您的 User-Agent。字段详情见 爬虫字段,您也可以把日志中的地址及其 user agent 粘贴到爬虫 IP 验证工具中。它会读取 threat.crawler.verified,并在您的浏览器中把运营方与 user agent 所指的 bot 进行比对。
用正确的文件核对日志中的 IP
这段代码接收日志行中的 IP 及其声称的 User-Agent,只加载 User-Agent 所指 bot 的文件,并报告该地址是否在其中,以及还有哪些其他文件也列出了它。它不做放行或拦截的决定,也不写入任何列表。它只是一个示例,不是解析器:含有两个 bot token 的 User-Agent 会匹配最长的那个。
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
每条日志行的格式是 <ip> <User-Agent>。我们于 2026 年 11 月 9 日 10:01 UTC 在下面这份示例上运行了它,其中 45.33.32.156 是 Nmap 的公开扫描主机(它没有发送过这样的请求),203.0.113.9 和 2001:db8::1 是文档用地址:
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
OAI-AdsBot 在这里能通过,是因为这段代码直接读取文件本身,尽管我们的 API 没有加载它。一个 User-Agent token 对应一份文件,遵循 Perplexity 的规则:“每个 bot 都有自己的 IP 段,所以请把每个 User-Agent 与它自己的 IP 段进行匹配。”文件无法访问时结果是“未验证”,绝不会是“已验证”:当我们把 SSL_CERT_FILE 指向一个不存在的路径时,每一行都打印了 not verified: ... file unavailable。一个错误的 IP 字符串只会打印“not verified”,而不会中断运行。这段代码设置了自己的 User-Agent,因为 claude.com 在 2026 年 11 月 9 日对 Python 默认的 User-Agent 返回了 403,而其他文件都返回了 200。
对于没有文件的 bot,方法见 如何验证 AI 爬虫和 agent:反向 DNS 和签名。Google 说它“也在试验 Web Bot Auth 协议”,使用 https://agent.bot.goog 身份,而 YouBot 发布了一个签名目录。
不会出现在您日志中的名称,以及我们无法找到来源的 bot
其他列表上的一些名称不是爬虫,或者我们打不开任何运营方页面。其中三个是控制 token,它们从不作为请求方出现,所以都无法被记录,也无法按 IP 验证。
Google-Extended (Google)
- 会出现在您的日志中吗?:否
- 运营方的说法:“Google-Extended 没有单独的 HTTP 请求 user agent 字符串。抓取使用 Google 现有的 user agent 字符串完成;robots.txt 的 user-agent token 起控制作用。”
- 遵守方:Google
Applebot-Extended (Apple)
- 会出现在您的日志中吗?:否
- 运营方的说法:“Applebot-Extended 不会抓取网页。”以及“Applebot-Extended 只用于决定如何使用 Applebot user agent 所抓取的数据。”
- 遵守方:Apple
__usage_ai-training (共用(IETF aipref 草案))
- 会出现在您的日志中吗?:否,它是 robots.txt 的组名
- 运营方的说法:Microsoft:“自 2027 年 2 月 1 日起,Microsoft 在抓取时将遵守这些新的偏好”。Google:“打算在 2027 年初支持 AIPREF 共享的机器可读训练偏好信号(使用‘user-agent: __usage_ai-training’)”。Anthropic:“自 2026 年 10 月 30 日起,Anthropic 已开始识别一种机器可读信号”
- 遵守方:Anthropic 自 2026-10-30 起(其页面没有写出该 token);Microsoft 自 2027-02-01 起;Google“2027 年初”(意向);OpenAI 未验证
Anthropic 的页面说,它的信号基于“IETF 在其 aipref 工作组所做工作的一份草案”("a draft based on work done by the IETF ... in its aipref working group")。我们无法打开 OpenAI 的帮助页面,所以对 OpenAI 不作任何论断。
2026 年 11 月 9 日,我们没能找到下列 bot 的运营方自己维护的页面。这份列表说明了我们核对了什么。下面的列表中没有出现的 bot 仍可能存在;我们并不是说这些运营方没有运行爬虫。
ByteDance:Bytespider
- 我们在 2026-11-09 核对了什么:bytedance.com/robots.txt;bytedance.com/en/bytespider (404);bytespider.bytedance.com(无 DNS);zhanzhang.toutiao.com 首页(没有爬虫相关文字)
- 结果:未找到 ByteDance 的页面。第三方对是否存在 IP 段看法不一,所以我们不声明其用途或 IP 段
xAI:与 Grok 相关的 token
- 我们在 2026-11-09 核对了什么:docs.x.ai/llms.txt(没有爬虫或 robots.txt 相关文字);docs.x.ai/docs/crawler (404);x.ai/grok-bot.json (403)
- 结果:什么也没找到
Cohere:cohere-ai、cohere-training-data-crawler
- 我们在 2026-11-09 核对了什么:docs.cohere.com/docs/cohere-web-crawlers(可以打开;bot 表格显示“N/A”);cohere.com/crawler (404);cohere.com/cohere-ai.json (404)
- 结果:该页面写道:“目前,我们不会使用 Cohere 的 bot 或 user agent 来抓取网页内容,用于训练生成式 AI 基础模型。”
DeepSeek:DeepSeekBot
- 我们在 2026-11-09 核对了什么:deepseek.com/robots.txt;api-docs.deepseek.com/llms.txt(无匹配);deepseek.com/deepseekbot.json (404)
- 结果:什么也没找到
有些名称已经过时。anthropic-ai 和 Claude-Web 不在 Anthropic 的页面上,FacebookBot 不在 Meta 的页面上,而 Gemini-Deep-Research 在我们读过的四个 Google 爬虫页面中都没有出现。它们在我们读过的页面上都没有文档,所以我们没有把其中任何一个列为 bot。
这份列表是如何核对的,以及它如何变化
GeoIPHub 通过打开每家运营方的页面、抓取每份文件、重新计数并运行上述查询,来核对这份 AI 爬虫列表。只有当我们重新核对某一个条目时,该条目的日期才会改变。
我们观察到的变化,附各自日期:Bingbot 的文件在日期冻结于 2024-01-03 的情况下,从 28 个前缀变成了 29 个。ChatGPT-User 的文件先是 234 个前缀,10 月 29 日是 235 个,然后在 2026 年 11 月 6 日的文件中是 237 个。Perplexity 的两份文件在 10 月 27 日分别有 4 个和 8 个前缀,在 10 月 28 日是 10 个和 13 个。Anthropic 的文件在我们的“屏蔽 AI 爬虫”一文中有 38 个前缀(文件日期为 10 月 7 日),现在有 14 个,日期为 10 月 20 日。无论是对运营方还是对我们的 API,我们都不声明更新计划。API 不返回抓取日期,所以运营方最近新增的前缀可能还无法通过验证。
请求头中的名称只是一个声明,而当运营方发布了文件时,证明就是运营方的文件。
常见问题
什么是 AI 爬虫列表?
这是一份清单,列出 AI 公司和搜索产品用来抓取网页的自动化客户端,并标明每个客户端的 User-Agent、用途(训练、搜索、用户触发抓取或 agent)以及如何证明其身份。截至 2026 年 11 月 9 日,GeoIPHub 的列表收录了运营方公开记录的 29 个 bot,GeoIPHub 的 API 按 IP 验证其中 16 个。
GPTBot 和 ClaudeBot 有什么区别?
GPTBot 是 OpenAI 的训练爬虫,ClaudeBot 是 Anthropic 的训练爬虫。两家都发布了 IP 段文件,Anthropic 的这一份文件还同时覆盖 Claude-User 和 Claude-SearchBot。GeoIPHub 的 API 可以验证来自任一文件的地址。OpenAI 各个 bot 的具体用途见 GPTBot vs OAI-SearchBot vs ChatGPT-User。
哪些 AI 爬虫公布了 IP 段?
截至 2026 年 11 月 9 日,有 10 家运营方为我们能找到的 AI bot 公布了 22 份 IP 段文件:OpenAI、Anthropic、Google、Perplexity、Mistral、Microsoft、Apple、DuckDuckGo、Common Crawl 和 Moonshot。GeoIPHub 加载其中 17 份。Amazon 把地址列在网页上,Meta 和 MistralAI-Training 则没有公布。
可以通过 User-Agent 验证 AI 爬虫吗?
不可以。User-Agent 只是一个字符串,任何客户端都可以发送。GeoIPHub 的查询只接收 IP:它能告诉您该地址是否位于 OpenAI 或 Anthropic 的文件内,而把该运营方与 User-Agent 所声称的 bot 进行比对,则由您自己的代码完成。
Meta 的 AI 爬虫使用什么 User-Agent?
Meta 记录了三个:用于训练的 meta-externalagent/1.1,用于 Meta AI 搜索的 meta-webindexer/1.1,以及用于用户请求抓取的 meta-externalfetcher/1.1。Meta 没有公布 IP 段文件,因此 GeoIPHub 按 ASN 匹配其网络,并返回 verified: false。
CCBot 是 AI 爬虫吗?
CCBot 是 Common Crawl 的爬虫,Common Crawl 为它发布了 IP 文件和反向 DNS。其他列表把它归为 AI 爬虫,是因为它构建的存档可以用于训练;这一关联出自他们,并非 Common Crawl 的说法。GeoIPHub 验证它的文件,并返回类别 archiver。
GeoIPHub API 背后的团队
由 GeoIPHub 团队撰写,即构建 GeoIPHub IP 情报 API 及其扫描器的团队。草稿在 AI 辅助下完成,并由团队编辑;除非标注为示例,API 示例均为针对线上 API 的真实查询。