Segurança de rede
Lista de rastreadores de IA: User-Agents de 29 bots e quais você pode verificar por IP
Uma lista de rastreadores de IA com 29 bots por função, com User-Agents, texto do robots.txt e arquivos de faixas, e os 16 que o GeoIPHub verifica por IP, conferida em 9 de novembro de 2026.
Escopo: bots que um operador documenta em uma página que conseguimos abrir em 9 de novembro de 2026, conforme usados para IA. A Meta também documenta o meta-externalads, um rastreador de anúncios, que não contamos. Os nomes que circulam em outras listas sem documentação do operador estão em uma lista separada, com o que conferimos.
Os operadores publicam uma forma de comprovar 25 destes 29 bots. A API do GeoIPHub verifica 16. Os outros nove não são uma lacuna no que os operadores documentam: são arquivos e páginas que não carregamos, e a lista diz quais.
Outras listas dão nomes e tokens, mas um nome em um cabeçalho User-Agent não prova nada, porque qualquer um pode digitá-lo. A comprovação dos operadores vem de cinco formas: um arquivo JSON, uma página da web com endereços, DNS reverso, uma assinatura ou nada. Este post faz parte do nosso trabalho sobre detecção de bots por IP. A seguir: cada bot por função, os 22 arquivos de faixas com suas contagens e datas, o que a API do GeoIPHub retornou para um endereço real de 14 dos arquivos que carregamos, um trecho de código que confere uma linha de log com o arquivo certo, e os nomes que nunca chegam aos seus logs ou que não conseguimos documentar.
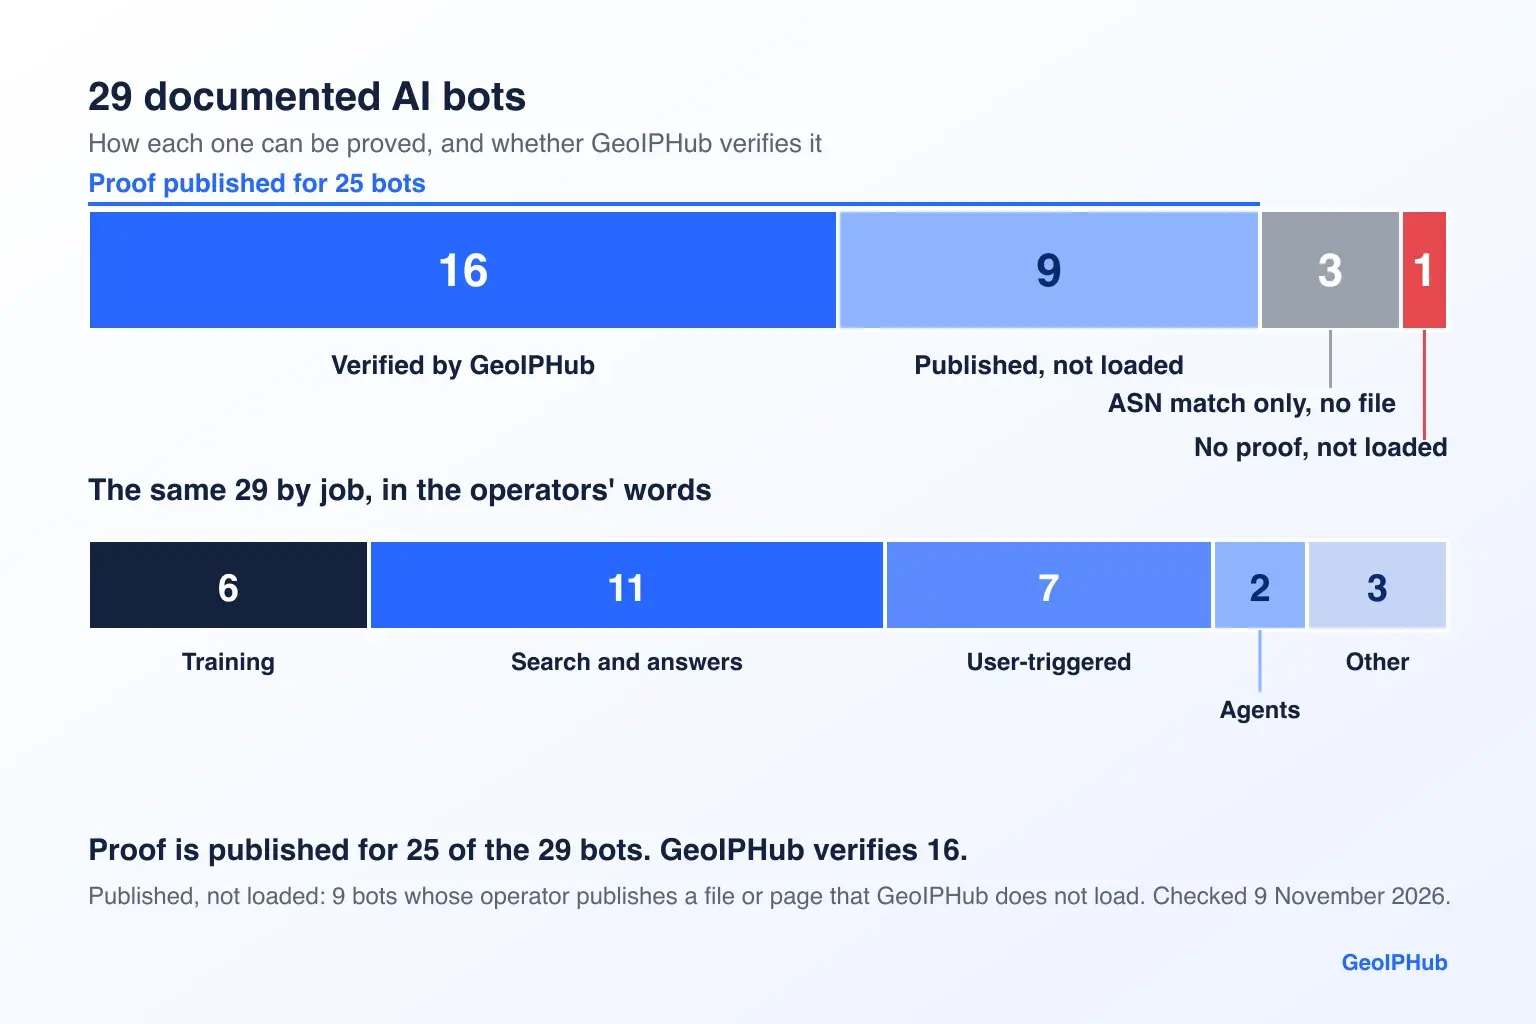
A lista de rastreadores de IA: 29 bots por função
Esta lista de rastreadores de IA organiza 29 bots documentados e seus user agents pela função que o operador declara: treinamento, busca, busca acionada pelo usuário, agentes e um pequeno grupo que não é nenhuma dessas. Quatro termos aparecem em todas as entradas. Comprovação é o que o operador publica: um arquivo de faixas, uma página da web com endereços, DNS reverso, uma assinatura ou nada. Verificado significa que um endereço do arquivo do próprio bot retornou verified: true na API do GeoIPHub na data indicada. Apenas correspondência por ASN significa que reconhecemos a rede do operador e retornamos verified: false. Não carregado significa que não carregamos a lista do operador.
O agrupamento segue as palavras dos operadores e não é limpo. A OpenAI diz "If your site has allowed both bots, we may use the results from just one crawl for both use cases" (se o seu site permitiu ambos os bots, podemos usar os resultados de um único rastreamento para ambos os casos de uso). A Meta diz "use cases such as training" (casos de uso como treinamento). A Amazon diz "may be used to train" (pode ser usado para treinar). O rastreador da Apple é voltado primeiro para busca e "may also be used to help train" (também pode ser usado para ajudar a treinar) seus modelos. A documentação de bots da Cloudflare traça a mesma divisão em três: Search ("Crawling to build search indexes or RAG databases", rastreamento para construir índices de busca ou bancos de dados RAG), Agent ("User-directed agents visiting a page on behalf of a human", agentes dirigidos pelo usuário que visitam uma página em nome de uma pessoa) e Training ("Crawling to train or fine-tune models", rastreamento para treinar ou ajustar modelos).
Quais rastreadores de IA treinam modelos?
Seis, segundo as próprias palavras dos operadores.
GPTBot (OpenAI)
- Trecho do UA: GPTBot/1.4
- Comprovação: arquivo
- robots.txt, palavras do operador: "Disallowing GPTBot indicates a site’s content should not be used in training generative AI foundation models." (Bloquear o GPTBot indica que o conteúdo de um site não deve ser usado para treinar modelos de base de IA generativa.)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
ClaudeBot (Anthropic)
- Trecho do UA: ClaudeBot
- Comprovação: arquivo (compartilhado)
- robots.txt, palavras do operador: "Anthropic's Bots respect "do not crawl" signals by honoring industry standard directives in robots.txt." (Os bots da Anthropic respeitam sinais de "não rastrear" ao seguir as diretivas padrão do setor no robots.txt.)
- Verificado pelo GeoIPHub: verificado (como Anthropic)
- Conferido: 2026-11-09
MistralAI-Training (Mistral)
- Trecho do UA: MistralAI-Training/1.0
- Comprovação: nenhuma
- robots.txt, palavras do operador: "Webmasters can disallow this user agent in their robots.txt file." (Webmasters podem bloquear este user agent em seu arquivo robots.txt.)
- Verificado pelo GeoIPHub: não carregado (mistralai-training-ips.json retorna 404)
- Conferido: 2026-11-09
meta-externalagent (Meta)
- Trecho do UA: meta-externalagent/1.1
- Comprovação: nenhuma
- robots.txt, palavras do operador: "In order to block these crawlers, add a disallow for the relevant crawler to robots.txt." (Para bloquear esses rastreadores, adicione um disallow para o rastreador correspondente no robots.txt.)
- Verificado pelo GeoIPHub: apenas correspondência por ASN, não verificado
- Conferido: 2026-11-09
Amazonbot (Amazon)
- Trecho do UA: Amazonbot/0.1
- Comprovação: apenas página da web
- robots.txt, palavras do operador: "Automated crawling from these listed user agents respects the Robots Exclusion Protocol, honoring the user-agent and the allow/disallow directives." (O rastreamento automatizado desses user agents listados respeita o Protocolo de Exclusão de Robôs, seguindo o user-agent e as diretivas allow/disallow.)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
KimiBot (Moonshot)
- Trecho do UA: KimiBot/1.0
- Comprovação: arquivo (um arquivo, três nomes)
- robots.txt, palavras do operador: não citado
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
Finalidade, nas palavras dos operadores: o GPTBot é "used to crawl content that may be used in training our generative AI foundation models" (usado para rastrear conteúdo que pode ser usado para treinar nossos modelos de base de IA generativa). O MistralAI-Training "crawls web content to help build datasets for training Mistral generative AI models" (rastreia conteúdo da web para ajudar a construir conjuntos de dados para treinar os modelos de IA generativa da Mistral). O KimiBot "crawls content potentially used to train Kimi's foundation models" (rastreia conteúdo potencialmente usado para treinar os modelos de base do Kimi).
Quais rastreadores de IA alimentam busca e respostas?
Onze, incluindo dois rastreadores de busca clássicos que estão no nosso conjunto carregado.
OAI-SearchBot (OpenAI)
- Trecho do UA: OAI-SearchBot/1.4
- Comprovação: arquivo
- robots.txt, palavras do operador: "Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers" (Sites que optaram por sair do OAI-SearchBot não serão exibidos nas respostas de busca do ChatGPT)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
Claude-SearchBot (Anthropic)
- Trecho do UA: Claude-SearchBot
- Comprovação: arquivo (compartilhado)
- robots.txt, palavras do operador: a mesma frase da Anthropic do ClaudeBot
- Verificado pelo GeoIPHub: verificado (como Anthropic)
- Conferido: 2026-11-09
PerplexityBot (Perplexity)
- Trecho do UA: PerplexityBot/1.0
- Comprovação: arquivo
- robots.txt, palavras do operador: não citado
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
MistralAI-Index (Mistral)
- Trecho do UA: MistralAI-Index/1.0
- Comprovação: arquivo
- robots.txt, palavras do operador: não citado
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
meta-webindexer (Meta)
- Trecho do UA: meta-webindexer/1.1
- Comprovação: nenhuma
- robots.txt, palavras do operador: a mesma frase da Meta do meta-externalagent
- Verificado pelo GeoIPHub: apenas correspondência por ASN, não verificado
- Conferido: 2026-11-09
Amzn-SearchBot (Amazon)
- Trecho do UA: Amzn-SearchBot/0.1
- Comprovação: apenas página da web
- robots.txt, palavras do operador: "If robots.txt files don't mention Amzn-SearchBot but allow other search bots, Amzn-SearchBot will crawl in accordance with the robots.txt directives given to other search bots." (Se os arquivos robots.txt não mencionam o Amzn-SearchBot mas permitem outros bots de busca, o Amzn-SearchBot rastreará de acordo com as diretivas do robots.txt dadas a outros bots de busca.)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
Applebot (Apple)
- Trecho do UA: Applebot/0.1
- Comprovação: arquivo + DNS reverso
- robots.txt, palavras do operador: "Applebot respects standard robots.txt directives in general search crawls that are targeted at Applebot." (O Applebot respeita as diretivas padrão do robots.txt em rastreamentos de busca gerais direcionados ao Applebot.)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
Bingbot (Microsoft)
- Trecho do UA: Bingbot
- Comprovação: arquivo
- robots.txt, palavras do operador: não citado (a página da Microsoft exige JavaScript, então não conseguimos lê-la)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
DuckAssistBot (DuckDuckGo)
- Trecho do UA: DuckAssistBot/1.2
- Comprovação: arquivo
- robots.txt, palavras do operador: "Once you've updated the file to disallow the DuckAssistBot user agent, the change will take effect after 72 hours and DuckAssistBot will stop crawling your site." (Depois de atualizar o arquivo para bloquear o user agent DuckAssistBot, a alteração terá efeito após 72 horas e o DuckAssistBot deixará de rastrear seu site.)
- Verificado pelo GeoIPHub: verificado (endereços do DuckDuckBot também retornam este nome)
- Conferido: 2026-11-09
Kimi-SearchBot (Moonshot)
- Trecho do UA: Kimi-SearchBot/1.0
- Comprovação: arquivo (compartilhado)
- robots.txt, palavras do operador: não citado
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
YouBot (You.com)
- Trecho do UA: YouBot/1.0
- Comprovação: assinatura + DNS reverso + apenas página da web (um /24)
- robots.txt, palavras do operador: "It respects robots.txt directives and crawl rate preferences" (Respeita as diretivas do robots.txt e as preferências de taxa de rastreamento)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
Bingbot e Applebot estão aqui porque estão no nosso conjunto carregado e a Apple diz que seu rastreador pode ajudar a treinar seus modelos. Não conseguimos ler a página de rastreadores da Microsoft, que exige JavaScript, mas o post dela de 30 de outubro define as preferências de IA por meio do Bingbot. O YouBot é a única entrada com três comprovações: um diretório de assinaturas em you.com/.well-known/http-message-signatures-directory, DNS reverso no formato youbot-68-67-112-106 e a declaração "Legitimate YouBot requests originate from 68.67.112.0/24." (Requisições legítimas do YouBot vêm de 68.67.112.0/24.)
Finalidade, nas palavras dos operadores: o PerplexityBot é "designed to surface and link websites in search results on Perplexity. It is not used to crawl content for AI foundation models." (projetado para exibir e vincular sites nos resultados de busca do Perplexity. Não é usado para rastrear conteúdo para modelos de base de IA.) O MistralAI-Index é "for automated crawling of the web for indexing purposes only" (para o rastreamento automatizado da web apenas para fins de indexação). O DuckAssistBot "crawls pages in real-time for our AI-assisted answers" (rastreia páginas em tempo real para nossas respostas assistidas por IA) e "This data is not used in any way to train AI models." (Esses dados não são usados de nenhuma forma para treinar modelos de IA.)
Quais rastreadores de IA buscam uma página porque um usuário pediu?
Sete, além dos fetchers acionados pelo usuário do Google.
ChatGPT-User (OpenAI)
- Trecho do UA: ChatGPT-User/1.0
- Comprovação: arquivo
- robots.txt, palavras do operador: "Because these actions are initiated by a user, robots.txt rules may not apply." (Como essas ações são iniciadas por um usuário, as regras do robots.txt podem não se aplicar.)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
Claude-User (Anthropic)
- Trecho do UA: Claude-User
- Comprovação: arquivo (compartilhado)
- robots.txt, palavras do operador: a frase da Anthropic para todos os seus bots (veja ClaudeBot); não encontramos nenhuma exceção para o que é acionado pelo usuário
- Verificado pelo GeoIPHub: verificado (como Anthropic)
- Conferido: 2026-11-09
Perplexity-User (Perplexity)
- Trecho do UA: Perplexity-User/1.0
- Comprovação: arquivo
- robots.txt, palavras do operador: "Since a user requested the fetch, this fetcher generally ignores robots.txt rules." (Como um usuário solicitou a busca, este fetcher geralmente ignora as regras do robots.txt.)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
MistralAI-User (Mistral)
- Trecho do UA: MistralAI-User/1.0
- Comprovação: arquivo
- robots.txt, palavras do operador: "MistralAI-User governs which sites these user requests can be made to." (O MistralAI-User rege a quais sites essas requisições de usuários podem ser feitas.)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
meta-externalfetcher (Meta)
- Trecho do UA: meta-externalfetcher/1.1
- Comprovação: nenhuma
- robots.txt, palavras do operador: "may bypass robots.txt because it performs fetches that were requested by the user" (pode ignorar o robots.txt porque realiza buscas solicitadas pelo usuário)
- Verificado pelo GeoIPHub: apenas correspondência por ASN, não verificado
- Conferido: 2026-11-09
Amzn-User (Amazon)
- Trecho do UA: Amzn-User/0.1
- Comprovação: apenas página da web
- robots.txt, palavras do operador: "Because actions taken by Amzn-User can be initiated by a user, it may not follow all robots.txt directives." (Como as ações do Amzn-User podem ser iniciadas por um usuário, ele pode não seguir todas as diretivas do robots.txt.)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
Kimi-User (Moonshot)
- Trecho do UA: Kimi-User/1.0
- Comprovação: arquivo (compartilhado)
- robots.txt, palavras do operador: "because actions are user-triggered, robots.txt rules may not directly apply" (como as ações são acionadas pelo usuário, as regras do robots.txt podem não se aplicar diretamente)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
A página do Google também nomeia o Google-GeminiNotebook, que "requests individual URLs that Gemini Notebook users have provided as sources" (solicita URLs individuais que usuários do Gemini Notebook forneceram como fontes). Ela não diz em qual dos arquivos de faixas de busca acionada pelo usuário do Google ele aparece, então não conseguimos testá-lo e o deixamos de fora da lista.
Quais bots de IA são agentes?
Dois, ambos documentados como agentes que navegam pela web para um usuário.
Google-Agent (Google)
- Trecho do UA: Google-Agent
- Comprovação: arquivo (+ assinatura, em teste)
- robots.txt, palavras do operador: os fetchers acionados pelo usuário "generally ignore robots.txt rules" (geralmente ignoram as regras do robots.txt) (declaração em nível de página)
- Verificado pelo GeoIPHub: verificado
- Conferido: 2026-11-09
Claude-Agent (Anthropic)
- Trecho do UA: Claude-Agent/1.0
- Comprovação: arquivo (SAIL, TOML, não JSON)
- robots.txt, palavras do operador: "Your preferences for Anthropic's robots (crawlers and fetchers) are independent and you can manage them separately." (Suas preferências para os robôs da Anthropic (rastreadores e fetchers) são independentes e você pode gerenciá-las separadamente.) (a página do agente não trata do robots.txt para o próprio navegador)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
O Google-Agent é "used by agents hosted on Google infrastructure to navigate the web and perform actions upon user request" (usado por agentes hospedados na infraestrutura do Google para navegar pela web e executar ações a pedido do usuário). Sobre o Claude-Agent, a Anthropic diz para "match on the Claude-Agent token rather than the full string" (comparar com o token Claude-Agent em vez da string completa).
Quais bots de IA não são nenhum destes?
Três, cada um documentado por seu operador para uma função diferente.
OAI-AdsBot (OpenAI)
- Trecho do UA: OAI-AdsBot/1.0
- Comprovação: arquivo
- robots.txt, palavras do operador: não citado (nenhuma declaração encontrada na página da OpenAI)
- Verificado pelo GeoIPHub: não carregado
- Conferido: 2026-11-09
CCBot (Common Crawl)
- Trecho do UA: CCBot/2.0
- Comprovação: arquivo + DNS reverso
- robots.txt, palavras do operador: a página traz
User-agent: CCBoteDisallow: / - Verificado pelo GeoIPHub: verificado (categoria
archiver) - Conferido: 2026-11-09
Google-CloudVertexBot (Google)
- Trecho do UA: Google-CloudVertexBot
- Comprovação: arquivo (arquivo de rastreadores comuns do Google)
- robots.txt, palavras do operador: não citado
- Verificado pelo GeoIPHub: verificado (arquivo compartilhado de rastreadores comuns)
- Conferido: 2026-11-09
O OAI-AdsBot é "used to validate the safety of web pages submitted as ads on ChatGPT" (usado para validar a segurança de páginas da web enviadas como anúncios no ChatGPT). O Google-CloudVertexBot "crawls requested by the site owners' for building Vertex AI Agents" (rastreia a pedido dos proprietários de sites para construir Vertex AI Agents). O Common Crawl diz "we are aware of crawlers falsely identifying themselves as CCBot" (sabemos que há rastreadores que se identificam falsamente como CCBot). A referência do AI Crawl Control da Cloudflare lista o CCBot como rastreador de IA; esse vínculo com o treinamento é de um terceiro, não do Common Crawl.
O custo de bloquear cada função está em bloquear rastreadores de IA.
Bots acionados pelo usuário tratam o robots.txt de formas diferentes, nas palavras dos próprios operadores
Bots de IA acionados pelo usuário, como ChatGPT-User, Perplexity-User e Claude-User, não compartilham uma única regra de robots.txt: cada operador diz algo diferente, e um não diz nada de especial. A busca age em nome de uma pessoa, que é a razão que a maioria deles dá.
- ChatGPT-User (OpenAI): "Because these actions are initiated by a user, robots.txt rules may not apply." (Como essas ações são iniciadas por um usuário, as regras do robots.txt podem não se aplicar.)
- Perplexity-User (Perplexity): "Since a user requested the fetch, this fetcher generally ignores robots.txt rules." (Como um usuário solicitou a busca, este fetcher geralmente ignora as regras do robots.txt.)
- fetchers acionados pelo usuário, incluindo o Google-Agent (Google): "Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules." (Como a busca foi solicitada por um usuário, esses fetchers geralmente ignoram as regras do robots.txt.)
- meta-externalfetcher (Meta): "may bypass robots.txt because it performs fetches that were requested by the user" (pode ignorar o robots.txt porque realiza buscas solicitadas pelo usuário)
- Amzn-User (Amazon): "Because actions taken by Amzn-User can be initiated by a user, it may not follow all robots.txt directives." (Como as ações do Amzn-User podem ser iniciadas por um usuário, ele pode não seguir todas as diretivas do robots.txt.)
- Kimi-User (Moonshot): "because actions are user-triggered, robots.txt rules may not directly apply" (como as ações são acionadas pelo usuário, as regras do robots.txt podem não se aplicar diretamente)
- MistralAI-User (Mistral): "MistralAI-User governs which sites these user requests can be made to." (O MistralAI-User rege a quais sites essas requisições de usuários podem ser feitas.)
- Claude-User (Anthropic): "Anthropic's Bots respect "do not crawl" signals by honoring industry standard directives in robots.txt." (Os bots da Anthropic respeitam sinais de "não rastrear" ao seguir as diretivas padrão do setor no robots.txt.) e "Claude-User allows site owners to control which sites can be accessed through these user-initiated requests." (O Claude-User permite que os proprietários de sites controlem quais sites podem ser acessados por meio dessas requisições iniciadas pelo usuário.)
A Anthropic é a exceção: a frase dela não tem nenhuma exceção para o que é acionado pelo usuário. "May not apply" (pode não se aplicar), "generally ignore" (geralmente ignoram), "may bypass" (pode ignorar) e "may not follow all" (pode não seguir todas) são quatro graus diferentes de força, então uma regra única para todo o grupo distorceria a maioria deles.
Quais rastreadores de IA publicam faixas de IP? 22 arquivos de faixas de 10 operadores
Dez operadores publicam 22 arquivos de faixas para os bots de IA que conseguimos encontrar; o GeoIPHub carrega 17 deles. Essas faixas de IP de rastreadores de IA aparecem em quatro estados. OpenAI, Perplexity, Mistral e o arquivo de agentes do Google dão um arquivo JSON por bot. Os três bots da Anthropic compartilham um arquivo, e os três arquivos do Kimi e os dois do DuckDuckGo são idênticos byte a byte. Os três bots da Amazon têm apenas uma página da web, cada uma com seu próprio creationTime. Meta e MistralAI-Training não publicam nada, e não encontramos nenhum arquivo dos operadores da última seção. O Claude-Agent publica em um formato mais novo, um arquivo TOML em claude.com/.well-known/sail (draft-kelley-webbotauth-sail-00). Os intervalos de IP do ClaudeBot e do PerplexityBot acompanha uma consulta real de cada arquivo.
O GeoIPHub carrega 19 arquivos oficiais de faixas de 10 operadores. 17 deles estão nesta lista; os outros dois são duckduckbot.json, idêntico ao arquivo do DuckDuckGo abaixo, e o da Ahrefs, que não é um bot de IA. Os 22 arquivos são 20 listas distintas. Obtidos em 9 de novembro de 2026 às 09:51 UTC, todos com HTTP 200:
1. GPTBot
- Arquivo: gptbot.json
- Prefixos IPv4 / IPv6: 18 / 0
creationTime: 2026-09-22- Carregado: sim
2. OAI-SearchBot
- Arquivo: searchbot.json
- Prefixos IPv4 / IPv6: 39 / 0
creationTime: 2026-01-02- Carregado: sim
3. ChatGPT-User
- Arquivo: chatgpt-user.json
- Prefixos IPv4 / IPv6: 237 / 0
creationTime: 2026-11-06- Carregado: sim
4. OAI-AdsBot
- Arquivo: adsbot.json
- Prefixos IPv4 / IPv6: 2 / 0
creationTime: 2026-05-12- Carregado: não
5. ClaudeBot, Claude-User, Claude-SearchBot
- Arquivo: bots.json
- Prefixos IPv4 / IPv6: 14 / 0
creationTime: 2026-10-20- Carregado: sim
6. Claude-Agent
- Arquivo: sail (TOML)
- Prefixos IPv4 / IPv6: 9 / 0
creationTime: modificado 2026-10-22- Carregado: não
7. Googlebot e rastreadores comuns, incluindo Google-CloudVertexBot
- Arquivo: common-crawlers.json
- Prefixos IPv4 / IPv6: 170 / 147
creationTime: 2026-11-06- Carregado: sim
8. Rastreadores de casos especiais
- Arquivo: special-crawlers.json
- Prefixos IPv4 / IPv6: 136 / 136
creationTime: 2026-11-06- Carregado: sim
9. Fetchers acionados pelo usuário
- Arquivo: user-triggered-fetchers.json
- Prefixos IPv4 / IPv6: 544 / 544
creationTime: 2026-11-06- Carregado: sim
10. Fetchers acionados pelo usuário (google.com)
- Arquivo: user-triggered-fetchers-google.json
- Prefixos IPv4 / IPv6: 252 / 252
creationTime: 2026-11-06- Carregado: sim
11. Google-Agent
- Arquivo: user-triggered-agents.json
- Prefixos IPv4 / IPv6: 12 / 8
creationTime: 2026-11-06- Carregado: sim
12. PerplexityBot
- Arquivo: perplexitybot.json
- Prefixos IPv4 / IPv6: 13 / 0
creationTime: 2026-10-28- Carregado: sim
13. Perplexity-User
- Arquivo: perplexity-user.json
- Prefixos IPv4 / IPv6: 10 / 0
creationTime: 2026-10-28- Carregado: sim
14. MistralAI-User
- Arquivo: mistralai-user-ips.json
- Prefixos IPv4 / IPv6: 4 / 0
creationTime: 2025-02-19- Carregado: sim
15. MistralAI-Index
- Arquivo: mistralai-index-ips.json
- Prefixos IPv4 / IPv6: 2 / 0
creationTime: 2026-04-19- Carregado: sim
16. Bingbot
- Arquivo: bingbot.json
- Prefixos IPv4 / IPv6: 29 / 0
creationTime: 2024-01-03- Carregado: sim
17. Applebot
- Arquivo: applebot.json
- Prefixos IPv4 / IPv6: 24 / 0
creationTime: 2026-09-15- Carregado: sim
18. DuckAssistBot (mesma lista que duckduckbot.json)
- Arquivo: duckassistbot.json
- Prefixos IPv4 / IPv6: 486 / 0
creationTime: 2026-09-01- Carregado: sim
19. CCBot
- Arquivo: ccbot.json
- Prefixos IPv4 / IPv6: 4 / 1
creationTime: 2026-08-11- Carregado: sim
20. KimiBot
- Arquivo: kimibot.json
- Prefixos IPv4 / IPv6: 4 / 0
creationTime: 2026-05-18- Carregado: não
21. Kimi-User
- Arquivo: kimi-user.json
- Prefixos IPv4 / IPv6: 4 / 0
creationTime: 2026-05-18- Carregado: não
22. Kimi-SearchBot
- Arquivo: kimi-searchbot.json
- Prefixos IPv4 / IPv6: 4 / 0
creationTime: 2026-05-18- Carregado: não
A data de um arquivo não prova que a lista não mudou: o arquivo do Bingbot passou de 28 para 29 prefixos enquanto sua data continuou 2024-01-03. Contamos 28 no nosso post de 29 de outubro e 29 em 9 de novembro, e não temos cópia anterior, então não podemos dizer qual prefixo foi adicionado. Os arquivos de casos especiais e de fetchers acionados pelo usuário do Google também cobrem fetchers que não são de IA; o Google lista seus fetchers de IA entre eles.
As três páginas da Amazon não são arquivos. developer.amazon.com/amazonbot/ip-addresses/ (Amazonbot), .../searchbot-ip-addresses/ (Amzn-SearchBot) e .../live-ip-addresses/ (Amzn-User) trazem valores creationTime embutidos de 2026-09-08, 2026-09-08 e 2025-11-04. Não as carregamos. Os dois arquivos do DuckDuckGo têm o mesmo hash MD5, assim como os três do Kimi. O único arquivo da Anthropic cobre três bots, e a Anthropic diz "If a crawler has a source IP address on this list, it indicates that the crawler is coming from Anthropic." (Se um rastreador tem um endereço IP de origem nesta lista, isso indica que o rastreador vem da Anthropic.)
Seis prefixos são idênticos em gptbot.json e searchbot.json nesta data: 4.227.36.0/25, 74.7.175.128/25, 74.7.228.0/25, 74.7.230.0/25, 74.7.241.128/25 e 74.7.244.0/25. O chatgpt-user.json não compartilha nenhum com eles. Nossa lista de IPs de rastreadores verificados mostra como montar uma allowlist a partir desses arquivos.
Quais bots de IA o GeoIPHub consegue verificar? 16 de 29 em 9 de novembro
A API do GeoIPHub verifica um endereço quando ele está dentro de um arquivo que carregamos, e isso comprova o operador, não o bot. Consultamos um endereço real de 14 dos 17 arquivos que carregamos (todos exceto o arquivo de casos especiais do Google e seus dois arquivos de fetchers acionados pelo usuário), mais três casos de contraste, sem chave, com cerca de 14 segundos de intervalo, em 9 de novembro de 2026, das 09:52 às 09:55 UTC. Cada consulta verificada também retornou verification_method: "ip_range_list", scoring.recommended_action: "allow" e um fraud_score de 0.
OAI-SearchBot
- Endereço (do arquivo): 4.227.36.1 (searchbot.json e gptbot.json)
verified: truename: OAISearchBotoperator: OpenAIcategory: ai- UTC: 09:52:11
GPTBot
- Endereço (do arquivo): 132.196.86.1 (gptbot.json)
verified: truename: GPTBotoperator: OpenAIcategory: ai- UTC: 09:52:25
ChatGPT-User
- Endereço (do arquivo): 104.208.184.193
verified: truename: ChatGPTUseroperator: OpenAIcategory: ai- UTC: 09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- Endereço (do arquivo): 216.73.216.10 (bots.json)
verified: truename: ClaudeBotoperator: Anthropiccategory: ai- UTC: 09:52:52
PerplexityBot
- Endereço (do arquivo): 107.20.236.150
verified: truename: PerplexityBotoperator: Perplexitycategory: ai- UTC: 09:53:06
Perplexity-User
- Endereço (do arquivo): 18.97.43.80
verified: truename: PerplexityUseroperator: Perplexitycategory: ai- UTC: 09:53:20
MistralAI-User
- Endereço (do arquivo): 20.240.160.161
verified: truename: MistralAIUseroperator: Mistralcategory: ai- UTC: 09:53:33
MistralAI-Index
- Endereço (do arquivo): 135.225.57.92
verified: truename: MistralAIIndexoperator: Mistralcategory: ai- UTC: 09:53:47
Google-Agent
- Endereço (do arquivo): 136.121.16.1
verified: truename: GoogleUserTriggeredAgentoperator: Googlecategory: ai- UTC: 09:54:01
Google-CloudVertexBot
- Endereço (do arquivo): 192.178.4.1 (common-crawlers.json)
verified: truename: Googlebotoperator: Googlecategory: search_engine- UTC: 09:54:15
DuckAssistBot
- Endereço (do arquivo): 104.43.54.127
verified: truename: DuckAssistBotoperator: DuckDuckGocategory: ai- UTC: 09:54:30
CCBot
- Endereço (do arquivo): 18.97.9.169
verified: truename: CCBotoperator: CommonCrawlcategory: archiver- UTC: 09:54:46
Applebot
- Endereço (do arquivo): 17.241.208.161
verified: truename: Applebotoperator: Applecategory: search_engine- UTC: 09:55:00
Bingbot
- Endereço (do arquivo): 157.55.39.1
verified: truename: Bingbotoperator: Microsoftcategory: search_engine- UTC: 09:55:14
OAI-AdsBot (arquivo não carregado)
- Endereço (do arquivo): 130.131.229.129 (adsbot.json)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC: 09:55:28
Amazonbot (página não carregada)
- Endereço (do arquivo): 3.81.245.78 (página da Amazon)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC: 09:55:42
Meta (rede, sem arquivo)
- Endereço (do arquivo): 31.13.64.1
verified: false,unverified: truename: Facebook-Botoperator: Metacategory: social_preview- UTC: 09:55:56
As armadilhas estão no campo name. name é o rótulo do arquivo que foi carregado por último, então os três bots da Anthropic retornam ClaudeBot, endereços do DuckDuckBot retornam DuckAssistBot e o Google-CloudVertexBot retorna Googlebot. category não é um campo de função: o CCBot retorna archiver, e Applebot e Bingbot retornam search_engine. Use como chave o token declarado mais operator, e escreva CommonCrawl sem espaço.
A surpresa foi 4.227.36.1. Ele está dentro de 4.227.36.0/25, que aparece tanto em gptbot.json quanto em searchbot.json. Uma cópia reduzida da resposta real:
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
Não estamos dizendo que uma requisição do GPTBot retorna OAISearchBot. O endereço, que está nos dois arquivos, retorna esse nome, e nossa consulta não consegue saber qual bot enviou uma requisição. A própria OpenAI diz que "may use the results from just one crawl for both use cases" (pode usar os resultados de um único rastreamento para ambos os casos de uso). O IP comprova a OpenAI e o User-Agent diz qual bot é; o post sobre a OpenAI explica o que cada bot da OpenAI faz.
Os casos não carregados são simples. O arquivo do OAI-AdsBot está publicado e 130.131.229.129 está dentro dele, mas nossa API retorna is_crawler: false e uma resposta de hospedagem (pontuação 15, allow, AS8075 Microsoft). A própria página do Amazonbot lista 3.81.245.78 e a API retorna o mesmo tipo de resposta (pontuação 16, allow, AS14618 Amazon). Nada nos nossos dados separa um OAI-AdsBot real de qualquer outro endereço dessa nuvem. O 31.13.64.1 da Meta é um endereço da rede da Meta (AS32934), verified: false; não observamos esse endereço rastreando.
A API não retorna qual arquivo correspondeu nem quando foi obtido, e uma consulta nunca vê o seu User-Agent. Os detalhes dos campos estão em os campos de rastreador, e você pode colar um endereço dos seus logs e o user agent dele no verificador de IP de rastreadores. Ele lê threat.crawler.verified e compara o operador com o bot que o seu user agent nomeia, no seu navegador.
Confira um IP dos seus logs com o arquivo certo
Este trecho de código recebe o IP de uma linha de log e o User-Agent que ela declara, carrega somente o arquivo do bot nomeado no User-Agent e informa se o endereço está nele e quais outros arquivos também o listam. Ele não toma nenhuma decisão de permitir ou bloquear e não grava nenhuma lista. É um exemplo, não um parser: um User-Agent com dois tokens de bot corresponde ao mais longo.
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
Cada linha de log é <ip> <User-Agent>. Executamos em 9 de novembro de 2026 às 10:01 UTC com esta amostra, em que 45.33.32.156 é o host público de varredura do Nmap (ele não enviou nenhuma requisição desse tipo) e 203.0.113.9 e 2001:db8::1 são endereços de documentação:
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
O OAI-AdsBot passa aqui porque o trecho lê o próprio arquivo, mesmo que nossa API não o carregue. Um token de User-Agent corresponde a um arquivo, seguindo a regra da Perplexity: "Each bot has its own IP ranges, so match each User-Agent against its own IP ranges." (Cada bot tem suas próprias faixas de IP, então compare cada User-Agent com as suas próprias faixas de IP.) Um arquivo inacessível significa "not verified", nunca "verified": com SSL_CERT_FILE apontando para um caminho que não existe, todas as linhas imprimiram not verified: ... file unavailable. Uma string de IP inválida imprime "not verified" em vez de interromper a execução. O trecho define seu próprio User-Agent porque o claude.com retornou 403 para o User-Agent padrão do Python em 9 de novembro de 2026, enquanto os outros arquivos retornaram 200.
Para os bots sem arquivo, os métodos estão em como verificar rastreadores e agentes de IA: DNS reverso e assinaturas. O Google diz que "is also experimenting with the Web Bot Auth protocol" (também está experimentando o protocolo Web Bot Auth), usando a identidade https://agent.bot.goog, e o YouBot publica um diretório de assinaturas.
Nomes que nunca chegam aos seus logs e bots que não conseguimos documentar
Alguns nomes de outras listas não são rastreadores, ou não têm uma página do operador que pudéssemos abrir. Três são tokens de controle que nunca aparecem como solicitante, então nenhum deles pode ser registrado em log nem verificado por IP.
Google-Extended (Google)
- Nos seus logs?: Não
- Palavras do operador: "Google-Extended doesn't have a separate HTTP request user agent string. Crawling is done with existing Google user agent strings; the robots.txt user-agent token is used in a control capacity." (O Google-Extended não tem uma string de user agent de requisição HTTP separada. O rastreamento é feito com as strings de user agent existentes do Google; o token user-agent do robots.txt é usado em função de controle.)
- Respeitado por: Google
Applebot-Extended (Apple)
- Nos seus logs?: Não
- Palavras do operador: "Applebot-Extended does not crawl webpages." (O Applebot-Extended não rastreia páginas da web.) e "Applebot-Extended is only used to determine how to use the data crawled by the Applebot user agent." (O Applebot-Extended é usado apenas para determinar como usar os dados rastreados pelo user agent Applebot.)
- Respeitado por: Apple
__usage_ai-training (compartilhado (rascunho aipref do IETF))
- Nos seus logs?: Não, é o nome de um grupo do robots.txt
- Palavras do operador: Microsoft: "Starting February 1, 2027, Microsoft will honor the new preferences as it crawls" (A partir de 1º de fevereiro de 2027, a Microsoft respeitará as novas preferências ao rastrear). Google: "intends to support the AIPREF shared machine-readable training preference signal (with "user-agent: __usage_ai-training") in early 2027" (pretende dar suporte ao sinal compartilhado de preferência de treinamento legível por máquina AIPREF (com "user-agent: __usage_ai-training") no início de 2027). Anthropic: "As of October 30, 2026, Anthropic has begun recognizing a machine-readable signal" (Desde 30 de outubro de 2026, a Anthropic começou a reconhecer um sinal legível por máquina)
- Respeitado por: Anthropic desde 2026-10-30 (a página dela não nomeia o token); Microsoft desde 2027-02-01; Google "no início de 2027" (intenção); OpenAI não verificado
A página da Anthropic diz que o sinal dela se baseia em "a draft based on work done by the IETF ... in its aipref working group" (um rascunho baseado no trabalho feito pelo IETF ... em seu grupo de trabalho aipref). Não conseguimos abrir as páginas de ajuda da OpenAI, então não afirmamos nada sobre a OpenAI.
Em 9 de novembro de 2026, não conseguimos encontrar uma página mantida pelo operador para os bots abaixo. Esta lista diz o que conferimos. Um bot que não esteja aqui ainda pode existir; não estamos dizendo que esses operadores não executam nenhum rastreador.
ByteDance: Bytespider
- O que conferimos em 2026-11-09: bytedance.com/robots.txt; bytedance.com/en/bytespider (404); bytespider.bytedance.com (sem DNS); página inicial de zhanzhang.toutiao.com (sem texto sobre rastreador)
- Resultado: Nenhuma página da ByteDance encontrada. Terceiros divergem sobre a existência de faixas, então não afirmamos nenhuma função nem faixa
xAI: tokens relacionados ao Grok
- O que conferimos em 2026-11-09: docs.x.ai/llms.txt (sem texto sobre rastreador ou robots.txt); docs.x.ai/docs/crawler (404); x.ai/grok-bot.json (403)
- Resultado: Nada encontrado
Cohere: cohere-ai, cohere-training-data-crawler
- O que conferimos em 2026-11-09: docs.cohere.com/docs/cohere-web-crawlers (abre; a tabela de bots diz "N/A"); cohere.com/crawler (404); cohere.com/cohere-ai.json (404)
- Resultado: A página diz: "We do not use Cohere bots or user agents for the purpose of crawling or scraping web content to train generative AI foundation models at this time." (Não usamos bots ou user agents da Cohere com a finalidade de rastrear ou extrair conteúdo da web para treinar modelos de base de IA generativa neste momento.)
DeepSeek: DeepSeekBot
- O que conferimos em 2026-11-09: deepseek.com/robots.txt; api-docs.deepseek.com/llms.txt (sem correspondências); deepseek.com/deepseekbot.json (404)
- Resultado: Nada encontrado
Alguns nomes estão desatualizados. anthropic-ai e Claude-Web não estão na página da Anthropic, FacebookBot não está na página da Meta e Gemini-Deep-Research não aparece em nenhuma das quatro páginas de rastreadores do Google que lemos. Eles não estão documentados nas páginas que lemos, então não listamos nenhum deles como bot.
Como esta lista foi conferida e como ela muda
O GeoIPHub conferiu esta lista de rastreadores de IA abrindo a página de cada operador, obtendo cada arquivo, recontando e executando as consultas acima. A data de uma entrada só muda quando conferimos aquela entrada de novo.
Mudanças que vimos, cada uma com sua data: o arquivo do Bingbot passou de 28 para 29 prefixos com uma data congelada de 2024-01-03. O arquivo do ChatGPT-User tinha 234 prefixos, depois 235 em 29 de outubro, e depois 237 em um arquivo datado de 6 de novembro de 2026. Os dois arquivos da Perplexity tinham 4 e 8 prefixos em 27 de outubro e 10 e 13 em 28 de outubro. O arquivo da Anthropic tinha 38 prefixos no nosso post sobre bloquear rastreadores de IA (arquivo datado de 7 de outubro) e agora tem 14, datado de 20 de outubro. Não indicamos nenhum cronograma de atualização, nem para os operadores nem para a nossa API. A API não retorna a data de obtenção, então um prefixo que um operador adicionou recentemente pode ainda não ser verificado.
O nome no cabeçalho é uma declaração, e a comprovação é o arquivo do operador quando o operador publica um.
Perguntas frequentes
O que é uma lista de rastreadores de IA?
Uma lista dos clientes automatizados que empresas de IA e produtos de busca executam para buscar páginas da web, com o user agent de cada um, sua função (treinamento, busca, busca acionada pelo usuário ou agente) e a forma de comprovar sua identidade. Em 9 de novembro de 2026, a lista do GeoIPHub tem 29 bots que os operadores documentam, e a API do GeoIPHub verifica 16 deles por IP.
Qual é a diferença entre GPTBot e ClaudeBot?
O GPTBot é o rastreador de treinamento da OpenAI e o ClaudeBot é o da Anthropic. Cada um publica um arquivo de faixas, e o único arquivo da Anthropic também cobre Claude-User e Claude-SearchBot. A API do GeoIPHub verifica um endereço de qualquer um dos dois arquivos. O que cada bot da OpenAI faz está em GPTBot vs OAI-SearchBot vs ChatGPT-User.
Quais rastreadores de IA publicam faixas de IP?
Em 9 de novembro de 2026, dez operadores publicam 22 arquivos de faixas para os bots de IA que conseguimos encontrar: OpenAI, Anthropic, Google, Perplexity, Mistral, Microsoft, Apple, DuckDuckGo, Common Crawl e Moonshot. O GeoIPHub carrega 17 deles. A Amazon lista endereços em páginas da web, e Meta e MistralAI-Training não publicam nenhum.
Posso verificar um rastreador de IA pelo user agent?
Não. Um user agent é uma string que qualquer cliente pode enviar. A consulta do GeoIPHub recebe apenas o IP: ela pode dizer que o endereço está dentro do arquivo da OpenAI ou da Anthropic, e o seu próprio código compara esse operador com o bot que o User-Agent nomeia.
Qual user agent o rastreador de IA da Meta usa?
A Meta documenta meta-externalagent/1.1 para treinamento, meta-webindexer/1.1 para a busca do Meta AI e meta-externalfetcher/1.1 para buscas solicitadas pelo usuário. A Meta não publica nenhum arquivo de faixas, então o GeoIPHub reconhece sua rede por ASN e retorna verified: false.
O CCBot é um rastreador de IA?
O CCBot é o rastreador do Common Crawl, e o Common Crawl publica um arquivo de IPs e DNS reverso para ele. Outras listas o chamam de rastreador de IA porque o arquivo que ele constrói pode ser usado para treinamento; esse vínculo é delas, não uma declaração do Common Crawl. O GeoIPHub verifica o arquivo dele e retorna a categoria archiver.
A equipe por trás da API do GeoIPHub
Escrito pela equipe do GeoIPHub, as pessoas que constroem a API de inteligência de IP do GeoIPHub e seu scanner. Os rascunhos são preparados com auxílio de IA e editados pela equipe; os exemplos de API são consultas reais à API em produção, salvo quando indicados como ilustrativos.