네트워크 보안
AI 크롤러 목록: 봇 29개의 User-Agent와 IP로 검증할 수 있는 봇
역할별로 정리한 AI 크롤러 29개의 User-Agent, robots.txt 문구, IP 대역 파일과 GeoIPHub가 IP로 검증하는 16개 봇을 2026년 11월 9일 기준으로 확인했습니다.
범위: 2026년 11월 9일에 우리가 열어 볼 수 있었던 페이지에서 운영자가 AI용으로 문서화한 봇입니다. Meta는 광고 크롤러인 meta-externalads도 문서화하지만 집계하지 않았습니다. 운영자 문서 없이 다른 목록에서 돌아다니는 이름은 별도 목록에 확인한 내용과 함께 정리했습니다.
운영자는 이 봇 29개 중 25개에 대해 증명 방법을 공개합니다. GeoIPHub API가 검증하는 것은 16개입니다. 나머지 아홉 개는 운영자 문서의 공백이 아니라 우리가 불러오지 않는 파일과 페이지이며, 목록에 어느 쪽인지 적었습니다.
다른 목록들은 이름과 토큰만 알려 주지만, User-Agent 헤더의 이름은 누구나 입력할 수 있으므로 아무것도 증명하지 못합니다. 운영자가 제공하는 증명은 JSON 파일, 주소가 적힌 웹 페이지, 역방향 DNS, 서명, 또는 없음의 다섯 가지입니다. 이 글은 IP 기반 봇 탐지 작업의 일부입니다. 이후 내용은 다음과 같습니다. 역할별 봇, 개수와 날짜가 있는 대역 파일 22개, 우리가 불러오는 파일 17개 중 14개에서 가져온 실제 주소에 GeoIPHub API가 반환한 결과, 로그 한 줄을 올바른 파일과 대조하는 스니펫, 그리고 로그에 나타나지 않는 이름과 출처를 찾지 못한 이름입니다.
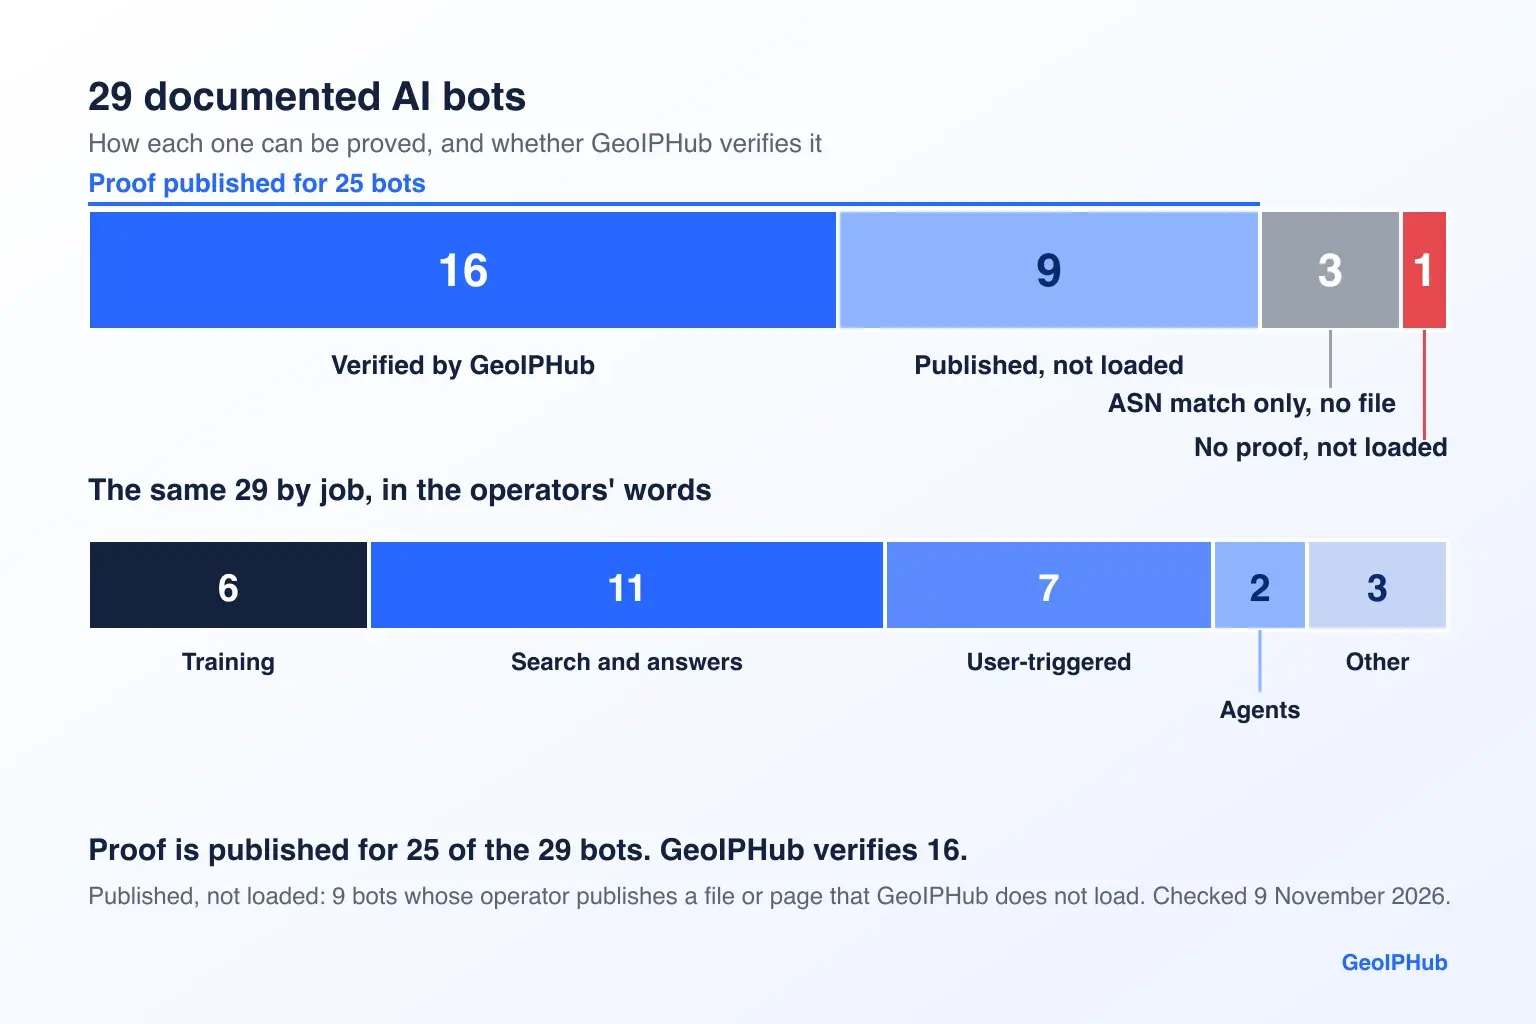
AI 크롤러 목록: 역할별 봇 29개
이 AI 크롤러 목록은 문서화된 봇 29개와 AI 크롤러 User-Agent를 운영자가 밝힌 역할별로 분류합니다. 학습, 검색, 사용자 요청 페치, 에이전트, 그리고 이 중 어디에도 속하지 않는 짧은 그룹입니다. 모든 항목에서 네 가지 용어를 씁니다. 증명(Proof)은 운영자가 공개하는 것으로, 대역 파일, 주소가 적힌 웹 페이지, 역방향 DNS, 서명, 또는 없음을 뜻합니다. 검증됨(Verified)은 해당 봇 자신의 파일에 있는 주소가 표시된 날짜에 GeoIPHub API에서 verified: true를 반환했다는 뜻입니다. ASN 매칭만(ASN match only)은 운영자의 네트워크를 매칭하고 verified: false를 반환한다는 뜻입니다. 미로드(Not loaded)는 우리가 해당 운영자의 목록을 불러오지 않는다는 뜻입니다.
분류는 운영자의 표현을 따르며 깔끔하게 나뉘지 않습니다. OpenAI는 "If your site has allowed both bots, we may use the results from just one crawl for both use cases"(사이트가 두 봇을 모두 허용했다면 한 번의 크롤링 결과를 두 용도에 모두 사용할 수 있습니다)라고 합니다. Meta는 "use cases such as training"(학습 같은 사용 사례)이라고 합니다. Amazon은 "may be used to train"(학습에 사용될 수 있음)이라고 합니다. Apple의 크롤러는 검색이 우선이지만 "may also be used to help train"(학습을 돕는 데도 사용될 수 있음) 자사 모델이라고 합니다. Cloudflare의 봇 문서도 같은 세 갈래 구분을 씁니다. Search("검색 색인이나 RAG 데이터베이스를 만들기 위한 크롤링"), Agent("사람을 대신해 페이지를 방문하는 사용자 지시형 에이전트"), Training("모델을 학습하거나 미세 조정하기 위한 크롤링")입니다.
모델을 학습시키는 AI 크롤러는 무엇입니까?
운영자 본인들의 표현으로는 여섯 개입니다.
GPTBot (OpenAI)
- UA 조각: GPTBot/1.4
- 증명: 파일
- robots.txt, 운영자의 표현: "GPTBot을 허용하지 않는다는 것은 사이트의 콘텐츠가 생성형 AI 파운데이션 모델 학습에 사용되어서는 안 된다는 뜻입니다."
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
ClaudeBot (Anthropic)
- UA 조각: ClaudeBot
- 증명: 파일(공유)
- robots.txt, 운영자의 표현: "Anthropic의 봇은 robots.txt의 업계 표준 지시문을 따름으로써 '크롤링 금지' 신호를 존중합니다."
- GeoIPHub 검증: 검증됨(Anthropic으로)
- 확인일: 2026-11-09
MistralAI-Training (Mistral)
- UA 조각: MistralAI-Training/1.0
- 증명: 없음
- robots.txt, 운영자의 표현: "웹마스터는 robots.txt 파일에서 이 user agent를 허용하지 않을 수 있습니다."
- GeoIPHub 검증: 미로드(mistralai-training-ips.json이 404 반환)
- 확인일: 2026-11-09
meta-externalagent (Meta)
- UA 조각: meta-externalagent/1.1
- 증명: 없음
- robots.txt, 운영자의 표현: "이 크롤러들을 차단하려면 robots.txt에 해당 크롤러에 대한 disallow를 추가하십시오."
- GeoIPHub 검증: ASN 매칭만, 미검증
- 확인일: 2026-11-09
Amazonbot (Amazon)
- UA 조각: Amazonbot/0.1
- 증명: 웹 페이지만
- robots.txt, 운영자의 표현: "나열된 이 user agent의 자동 크롤링은 Robots Exclusion Protocol을 존중하며 user-agent와 allow/disallow 지시문을 따릅니다."
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
KimiBot (Moonshot)
- UA 조각: KimiBot/1.0
- 증명: 파일(파일 하나, 이름 셋)
- robots.txt, 운영자의 표현: 인용하지 않음
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
운영자가 밝힌 목적은 다음과 같습니다. GPTBot은 "생성형 AI 파운데이션 모델 학습에 사용될 수 있는 콘텐츠를 크롤링하는 데 쓰입니다". MistralAI-Training은 "Mistral 생성형 AI 모델을 학습시키기 위한 데이터셋 구축을 돕고자 웹 콘텐츠를 크롤링합니다". KimiBot은 "Kimi의 파운데이션 모델 학습에 쓰일 가능성이 있는 콘텐츠를 크롤링합니다".
검색과 답변을 지원하는 AI 크롤러는 무엇입니까?
열한 개이며, 우리가 불러오는 목록에 있는 고전적인 검색 크롤러 두 개를 포함합니다.
OAI-SearchBot (OpenAI)
- UA 조각: OAI-SearchBot/1.4
- 증명: 파일
- robots.txt, 운영자의 표현: "OAI-SearchBot을 옵트아웃한 사이트는 ChatGPT 검색 답변에 표시되지 않습니다"
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
Claude-SearchBot (Anthropic)
- UA 조각: Claude-SearchBot
- 증명: 파일(공유)
- robots.txt, 운영자의 표현: ClaudeBot과 같은 Anthropic 문장
- GeoIPHub 검증: 검증됨(Anthropic으로)
- 확인일: 2026-11-09
PerplexityBot (Perplexity)
- UA 조각: PerplexityBot/1.0
- 증명: 파일
- robots.txt, 운영자의 표현: 인용하지 않음
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
MistralAI-Index (Mistral)
- UA 조각: MistralAI-Index/1.0
- 증명: 파일
- robots.txt, 운영자의 표현: 인용하지 않음
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
meta-webindexer (Meta)
- UA 조각: meta-webindexer/1.1
- 증명: 없음
- robots.txt, 운영자의 표현: meta-externalagent와 같은 Meta 문장
- GeoIPHub 검증: ASN 매칭만, 미검증
- 확인일: 2026-11-09
Amzn-SearchBot (Amazon)
- UA 조각: Amzn-SearchBot/0.1
- 증명: 웹 페이지만
- robots.txt, 운영자의 표현: "robots.txt 파일이 Amzn-SearchBot을 언급하지 않으면서 다른 검색 봇은 허용하는 경우, Amzn-SearchBot은 다른 검색 봇에 주어진 robots.txt 지시문에 따라 크롤링합니다."
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
Applebot (Apple)
- UA 조각: Applebot/0.1
- 증명: 파일 + 역방향 DNS
- robots.txt, 운영자의 표현: "Applebot은 Applebot을 대상으로 하는 일반 검색 크롤링에서 표준 robots.txt 지시문을 존중합니다."
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
Bingbot (Microsoft)
- UA 조각: Bingbot
- 증명: 파일
- robots.txt, 운영자의 표현: 인용하지 않음(Microsoft의 페이지는 JavaScript가 필요해 읽지 못했음)
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
DuckAssistBot (DuckDuckGo)
- UA 조각: DuckAssistBot/1.2
- 증명: 파일
- robots.txt, 운영자의 표현: "파일을 업데이트해 DuckAssistBot user agent를 허용하지 않으면 변경 사항이 72시간 후에 적용되고 DuckAssistBot은 사이트 크롤링을 멈춥니다."
- GeoIPHub 검증: 검증됨(DuckDuckBot 주소도 이 이름을 반환)
- 확인일: 2026-11-09
Kimi-SearchBot (Moonshot)
- UA 조각: Kimi-SearchBot/1.0
- 증명: 파일(공유)
- robots.txt, 운영자의 표현: 인용하지 않음
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
YouBot (You.com)
- UA 조각: YouBot/1.0
- 증명: 서명 + 역방향 DNS + 웹 페이지만(/24 하나)
- robots.txt, 운영자의 표현: "robots.txt 지시문과 크롤 속도 선호 설정을 존중합니다"
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
Bingbot과 Applebot이 여기 있는 이유는 우리가 불러오는 목록에 들어 있고, Apple이 자사 크롤러가 모델 학습을 도울 수도 있다고 밝혔기 때문입니다. Microsoft의 크롤러 페이지는 JavaScript가 필요해 읽지 못했지만, 10월 30일 게시글에서 AI 선호 설정을 Bingbot을 통해 지정합니다. YouBot은 증명이 셋인 유일한 항목입니다. you.com/.well-known/http-message-signatures-directory의 서명 디렉터리, youbot-68-67-112-106 형태의 역방향 DNS, 그리고 "Legitimate YouBot requests originate from 68.67.112.0/24."(정상적인 YouBot 요청은 68.67.112.0/24에서 발생합니다.)라는 문장입니다.
운영자가 밝힌 목적은 다음과 같습니다. PerplexityBot은 "Perplexity의 검색 결과에서 웹사이트를 노출하고 연결하도록 설계되었습니다. AI 파운데이션 모델용 콘텐츠를 크롤링하는 데는 쓰이지 않습니다." MistralAI-Index는 "오직 색인 목적의 웹 자동 크롤링용"입니다. DuckAssistBot은 "AI 지원 답변을 위해 페이지를 실시간으로 크롤링"하며 "이 데이터는 어떤 식으로든 AI 모델 학습에 사용되지 않습니다."
사용자가 요청해서 페이지를 가져오는 AI 크롤러는 무엇입니까?
일곱 개이며, Google의 사용자 요청형 페처는 별도입니다.
ChatGPT-User (OpenAI)
- UA 조각: ChatGPT-User/1.0
- 증명: 파일
- robots.txt, 운영자의 표현: "이러한 동작은 사용자가 시작하므로 robots.txt 규칙이 적용되지 않을 수 있습니다."
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
Claude-User (Anthropic)
- UA 조각: Claude-User
- 증명: 파일(공유)
- robots.txt, 운영자의 표현: 모든 봇에 대한 Anthropic의 문장(ClaudeBot 참조), 사용자 요청형 예외 조항은 찾지 못함
- GeoIPHub 검증: 검증됨(Anthropic으로)
- 확인일: 2026-11-09
Perplexity-User (Perplexity)
- UA 조각: Perplexity-User/1.0
- 증명: 파일
- robots.txt, 운영자의 표현: "사용자가 요청한 페치이므로 이 페처는 일반적으로 robots.txt 규칙을 무시합니다."
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
MistralAI-User (Mistral)
- UA 조각: MistralAI-User/1.0
- 증명: 파일
- robots.txt, 운영자의 표현: "MistralAI-User는 이러한 사용자 요청이 어떤 사이트에 대해 이루어질 수 있는지를 관리합니다."
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
meta-externalfetcher (Meta)
- UA 조각: meta-externalfetcher/1.1
- 증명: 없음
- robots.txt, 운영자의 표현: "사용자가 요청한 페치를 수행하므로 robots.txt를 우회할 수 있습니다"
- GeoIPHub 검증: ASN 매칭만, 미검증
- 확인일: 2026-11-09
Amzn-User (Amazon)
- UA 조각: Amzn-User/0.1
- 증명: 웹 페이지만
- robots.txt, 운영자의 표현: "Amzn-User의 동작은 사용자가 시작할 수 있으므로 모든 robots.txt 지시문을 따르지 않을 수 있습니다."
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
Kimi-User (Moonshot)
- UA 조각: Kimi-User/1.0
- 증명: 파일(공유)
- robots.txt, 운영자의 표현: "동작이 사용자 요청에 의해 이루어지므로 robots.txt 규칙이 직접 적용되지 않을 수 있습니다"
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
Google의 페이지는 Google-GeminiNotebook도 언급하며, 이 봇은 "Gemini Notebook 사용자가 소스로 제공한 개별 URL을 요청합니다". Google의 사용자 요청형 대역 파일 중 어느 것이 이 봇을 나열하는지는 밝히지 않아서 테스트할 수 없었고, 목록에서 뺐습니다.
에이전트인 AI 봇은 무엇입니까?
두 개이며, 둘 다 사용자를 대신해 웹을 탐색하는 에이전트로 문서화되어 있습니다.
Google-Agent (Google)
- UA 조각: Google-Agent
- 증명: 파일(+ 서명, 시험 중)
- robots.txt, 운영자의 표현: 사용자 요청형 페처는 "일반적으로 robots.txt 규칙을 무시합니다"(페이지 전체 수준의 진술)
- GeoIPHub 검증: 검증됨
- 확인일: 2026-11-09
Claude-Agent (Anthropic)
- UA 조각: Claude-Agent/1.0
- 증명: 파일(SAIL, JSON이 아닌 TOML)
- robots.txt, 운영자의 표현: "Anthropic의 로봇(크롤러와 페처)에 대한 선호 설정은 서로 독립적이며 따로 관리할 수 있습니다." (에이전트 페이지는 브라우저 자체에 대한 robots.txt를 다루지 않음)
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
Google-Agent는 "Google 인프라에서 호스팅되는 에이전트가 사용자 요청에 따라 웹을 탐색하고 작업을 수행하는 데 쓰입니다". Claude-Agent에 대해 Anthropic은 "전체 문자열이 아니라 Claude-Agent 토큰으로 매칭하라"고 합니다.
이 중 어디에도 속하지 않는 AI 봇은 무엇입니까?
세 개이며, 각각 운영자가 다른 용도로 문서화했습니다.
OAI-AdsBot (OpenAI)
- UA 조각: OAI-AdsBot/1.0
- 증명: 파일
- robots.txt, 운영자의 표현: 인용하지 않음(OpenAI 페이지에서 해당 진술을 찾지 못함)
- GeoIPHub 검증: 미로드
- 확인일: 2026-11-09
CCBot (Common Crawl)
- UA 조각: CCBot/2.0
- 증명: 파일 + 역방향 DNS
- robots.txt, 운영자의 표현: 페이지에
User-agent: CCBot과Disallow: /가 나와 있음 - GeoIPHub 검증: 검증됨(카테고리
archiver) - 확인일: 2026-11-09
Google-CloudVertexBot (Google)
- UA 조각: Google-CloudVertexBot
- 증명: 파일(Google의 공통 크롤러 파일)
- robots.txt, 운영자의 표현: 인용하지 않음
- GeoIPHub 검증: 검증됨(공통 크롤러 파일 공유)
- 확인일: 2026-11-09
OAI-AdsBot은 "ChatGPT에서 광고로 제출된 웹 페이지의 안전성을 검증하는 데 쓰입니다". Google-CloudVertexBot은 "Vertex AI Agents를 구축하기 위해 사이트 소유자가 요청한 크롤링을 수행합니다". Common Crawl은 "CCBot이라고 허위로 신분을 밝히는 크롤러가 있음을 알고 있습니다"라고 말합니다. Cloudflare의 AI Crawl Control 레퍼런스는 CCBot을 AI 크롤러로 나열하지만, 학습과의 그 연결은 제3자의 해석이지 Common Crawl의 것이 아닙니다.
각 역할을 차단할 때 치르는 비용은 AI 크롤러 차단에서 다룹니다.
사용자 요청형 봇은 robots.txt를 다르게 처리하며, 운영자의 표현도 제각각입니다
ChatGPT-User, Perplexity-User, Claude-User 같은 AI 사용자 요청형 봇은 하나의 robots.txt 규칙을 공유하지 않습니다. 운영자마다 말이 다르고, 한 곳은 특별한 말을 전혀 하지 않습니다. 대부분이 드는 이유는 같습니다. 그 페치가 한 사람을 위해 동작한다는 것입니다.
- ChatGPT-User (OpenAI): "이러한 동작은 사용자가 시작하므로 robots.txt 규칙이 적용되지 않을 수 있습니다."
- Perplexity-User (Perplexity): "사용자가 요청한 페치이므로 이 페처는 일반적으로 robots.txt 규칙을 무시합니다."
- Google-Agent를 포함한 사용자 요청형 페처 (Google): "사용자가 요청한 페치이므로 이 페처들은 일반적으로 robots.txt 규칙을 무시합니다."
- meta-externalfetcher (Meta): "사용자가 요청한 페치를 수행하므로 robots.txt를 우회할 수 있습니다"
- Amzn-User (Amazon): "Amzn-User의 동작은 사용자가 시작할 수 있으므로 모든 robots.txt 지시문을 따르지 않을 수 있습니다."
- Kimi-User (Moonshot): "동작이 사용자 요청에 의해 이루어지므로 robots.txt 규칙이 직접 적용되지 않을 수 있습니다"
- MistralAI-User (Mistral): "MistralAI-User는 이러한 사용자 요청이 어떤 사이트에 대해 이루어질 수 있는지를 관리합니다."
- Claude-User (Anthropic): "Anthropic의 봇은 robots.txt의 업계 표준 지시문을 따름으로써 '크롤링 금지' 신호를 존중합니다." 그리고 "Claude-User를 통해 사이트 소유자는 이러한 사용자 요청형 요청으로 접근할 수 있는 사이트를 제어할 수 있습니다."
Anthropic이 예외입니다. 이 문장에는 사용자 요청형에 대한 예외가 없습니다. "적용되지 않을 수 있음(may not apply)", "일반적으로 무시(generally ignore)", "우회할 수 있음(may bypass)", "모두 따르지 않을 수 있음(may not follow all)"은 서로 강도가 다른 네 가지 표현이므로, 그룹 전체에 규칙 하나를 적용하면 대부분을 잘못 설명하게 됩니다.
IP 대역을 공개하는 AI 크롤러는 어디입니까? 운영자 10곳의 대역 파일 22개
운영자 10곳이 우리가 찾을 수 있었던 AI 봇용 대역 파일 22개를 공개하며, GeoIPHub는 그중 17개를 불러옵니다. 이 AI 크롤러 IP 대역은 네 가지 상태로 나뉩니다. OpenAI, Perplexity, Mistral, Google의 에이전트 파일은 봇마다 JSON 파일 하나를 제공합니다. Anthropic의 봇 세 개는 파일 하나를 공유하고, Kimi의 파일 세 개와 DuckDuckGo의 파일 두 개는 바이트 단위로 동일합니다. Amazon의 봇 세 개는 웹 페이지만 있고 각각 고유한 creationTime이 있습니다. Meta와 MistralAI-Training은 아무것도 공개하지 않으며, 마지막 절의 운영자들에서는 파일을 찾지 못했습니다. Claude-Agent는 더 새로운 형식인 claude.com/.well-known/sail의 TOML 파일(draft-kelley-webbotauth-sail-00)로 공개합니다. ClaudeBot과 PerplexityBot의 IP 대역에서는 각 파일에서 실제로 조회한 결과를 따라가 봅니다.
GeoIPHub는 운영자 10곳의 공식 대역 파일 19개를 불러옵니다. 그중 17개가 이 목록에 있고, 나머지 둘은 아래 DuckDuckGo 파일과 동일한 duckduckbot.json과 AI 봇이 아닌 Ahrefs입니다. 파일 22개는 서로 다른 목록 20개입니다. 2026년 11월 9일 09:51 UTC에 모두 HTTP 200으로 가져왔습니다.
1. GPTBot
- 파일: gptbot.json
- IPv4 / IPv6 프리픽스: 18 / 0
creationTime: 2026-09-22- 로드 여부: 예
2. OAI-SearchBot
- 파일: searchbot.json
- IPv4 / IPv6 프리픽스: 39 / 0
creationTime: 2026-01-02- 로드 여부: 예
3. ChatGPT-User
- 파일: chatgpt-user.json
- IPv4 / IPv6 프리픽스: 237 / 0
creationTime: 2026-11-06- 로드 여부: 예
4. OAI-AdsBot
- 파일: adsbot.json
- IPv4 / IPv6 프리픽스: 2 / 0
creationTime: 2026-05-12- 로드 여부: 아니요
5. ClaudeBot, Claude-User, Claude-SearchBot
- 파일: bots.json
- IPv4 / IPv6 프리픽스: 14 / 0
creationTime: 2026-10-20- 로드 여부: 예
6. Claude-Agent
- 파일: sail (TOML)
- IPv4 / IPv6 프리픽스: 9 / 0
creationTime: 수정일 2026-10-22- 로드 여부: 아니요
7. Googlebot 및 Google-CloudVertexBot을 포함한 공통 크롤러
- 파일: common-crawlers.json
- IPv4 / IPv6 프리픽스: 170 / 147
creationTime: 2026-11-06- 로드 여부: 예
8. 특수 목적 크롤러
- 파일: special-crawlers.json
- IPv4 / IPv6 프리픽스: 136 / 136
creationTime: 2026-11-06- 로드 여부: 예
9. 사용자 요청형 페처
- 파일: user-triggered-fetchers.json
- IPv4 / IPv6 프리픽스: 544 / 544
creationTime: 2026-11-06- 로드 여부: 예
10. 사용자 요청형 페처(google.com)
- 파일: user-triggered-fetchers-google.json
- IPv4 / IPv6 프리픽스: 252 / 252
creationTime: 2026-11-06- 로드 여부: 예
11. Google-Agent
- 파일: user-triggered-agents.json
- IPv4 / IPv6 프리픽스: 12 / 8
creationTime: 2026-11-06- 로드 여부: 예
12. PerplexityBot
- 파일: perplexitybot.json
- IPv4 / IPv6 프리픽스: 13 / 0
creationTime: 2026-10-28- 로드 여부: 예
13. Perplexity-User
- 파일: perplexity-user.json
- IPv4 / IPv6 프리픽스: 10 / 0
creationTime: 2026-10-28- 로드 여부: 예
14. MistralAI-User
- 파일: mistralai-user-ips.json
- IPv4 / IPv6 프리픽스: 4 / 0
creationTime: 2025-02-19- 로드 여부: 예
15. MistralAI-Index
- 파일: mistralai-index-ips.json
- IPv4 / IPv6 프리픽스: 2 / 0
creationTime: 2026-04-19- 로드 여부: 예
16. Bingbot
- 파일: bingbot.json
- IPv4 / IPv6 프리픽스: 29 / 0
creationTime: 2024-01-03- 로드 여부: 예
17. Applebot
- 파일: applebot.json
- IPv4 / IPv6 프리픽스: 24 / 0
creationTime: 2026-09-15- 로드 여부: 예
18. DuckAssistBot(duckduckbot.json과 같은 목록)
- 파일: duckassistbot.json
- IPv4 / IPv6 프리픽스: 486 / 0
creationTime: 2026-09-01- 로드 여부: 예
19. CCBot
- 파일: ccbot.json
- IPv4 / IPv6 프리픽스: 4 / 1
creationTime: 2026-08-11- 로드 여부: 예
20. KimiBot
- 파일: kimibot.json
- IPv4 / IPv6 프리픽스: 4 / 0
creationTime: 2026-05-18- 로드 여부: 아니요
21. Kimi-User
- 파일: kimi-user.json
- IPv4 / IPv6 프리픽스: 4 / 0
creationTime: 2026-05-18- 로드 여부: 아니요
22. Kimi-SearchBot
- 파일: kimi-searchbot.json
- IPv4 / IPv6 프리픽스: 4 / 0
creationTime: 2026-05-18- 로드 여부: 아니요
파일의 날짜가 목록이 바뀌지 않았다는 증거는 아닙니다. Bingbot의 파일은 날짜가 2024-01-03으로 그대로인 채 프리픽스가 28개에서 29개로 늘었습니다. 10월 29일 글에서는 28개로, 11월 9일에는 29개로 셌고 이전 사본이 없어서 어떤 프리픽스가 추가되었는지는 말할 수 없습니다. Google의 특수 목적 파일과 사용자 요청형 파일은 AI가 아닌 페처도 포괄하며, Google은 AI 페처를 그 안에 나열합니다.
Amazon의 페이지 세 곳은 파일이 아닙니다. developer.amazon.com/amazonbot/ip-addresses/(Amazonbot), .../searchbot-ip-addresses/(Amzn-SearchBot), .../live-ip-addresses/(Amzn-User)에는 각각 2026-09-08, 2026-09-08, 2025-11-04의 creationTime 값이 내장되어 있습니다. 우리는 이 페이지를 불러오지 않습니다. DuckDuckGo의 파일 두 개는 MD5 해시가 같고, Kimi의 세 개도 마찬가지입니다. Anthropic의 파일 하나는 봇 세 개를 포괄하며, Anthropic은 "If a crawler has a source IP address on this list, it indicates that the crawler is coming from Anthropic."(크롤러의 출발지 IP 주소가 이 목록에 있다면 그 크롤러는 Anthropic에서 오는 것입니다.)라고 밝힙니다.
이 날짜 기준으로 gptbot.json과 searchbot.json에서 동일한 프리픽스는 여섯 개입니다. 4.227.36.0/25, 74.7.175.128/25, 74.7.228.0/25, 74.7.230.0/25, 74.7.241.128/25, 74.7.244.0/25입니다. chatgpt-user.json은 이들과 겹치는 것이 없습니다. 이 파일들로 허용 목록을 만드는 방법은 검증된 크롤러 IP 목록에서 보여 줍니다.
GeoIPHub가 검증할 수 있는 AI 봇은 무엇입니까? 11월 9일 기준 29개 중 16개
GeoIPHub API는 주소가 우리가 불러오는 파일 안에 있을 때 검증하며, 이는 봇이 아니라 운영자를 증명합니다. 우리가 불러오는 파일 17개 중 14개(Google의 특수 목적 파일과 사용자 요청형 페처 파일 두 개 제외)에서 실제 주소를 하나씩, 그리고 대조용 사례 세 개를 키 없이 약 14초 간격으로 2026년 11월 9일 09:52부터 09:55 UTC까지 조회했습니다. 검증된 조회은 모두 verification_method: "ip_range_list", scoring.recommended_action: "allow", fraud_score 0도 함께 반환했습니다.
OAI-SearchBot
- 주소(파일 출처): 4.227.36.1 (searchbot.json 및 gptbot.json)
verified: truename: OAISearchBotoperator: OpenAIcategory: ai- UTC: 09:52:11
GPTBot
- 주소(파일 출처): 132.196.86.1 (gptbot.json)
verified: truename: GPTBotoperator: OpenAIcategory: ai- UTC: 09:52:25
ChatGPT-User
- 주소(파일 출처): 104.208.184.193
verified: truename: ChatGPTUseroperator: OpenAIcategory: ai- UTC: 09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- 주소(파일 출처): 216.73.216.10 (bots.json)
verified: truename: ClaudeBotoperator: Anthropiccategory: ai- UTC: 09:52:52
PerplexityBot
- 주소(파일 출처): 107.20.236.150
verified: truename: PerplexityBotoperator: Perplexitycategory: ai- UTC: 09:53:06
Perplexity-User
- 주소(파일 출처): 18.97.43.80
verified: truename: PerplexityUseroperator: Perplexitycategory: ai- UTC: 09:53:20
MistralAI-User
- 주소(파일 출처): 20.240.160.161
verified: truename: MistralAIUseroperator: Mistralcategory: ai- UTC: 09:53:33
MistralAI-Index
- 주소(파일 출처): 135.225.57.92
verified: truename: MistralAIIndexoperator: Mistralcategory: ai- UTC: 09:53:47
Google-Agent
- 주소(파일 출처): 136.121.16.1
verified: truename: GoogleUserTriggeredAgentoperator: Googlecategory: ai- UTC: 09:54:01
Google-CloudVertexBot
- 주소(파일 출처): 192.178.4.1 (common-crawlers.json)
verified: truename: Googlebotoperator: Googlecategory: search_engine- UTC: 09:54:15
DuckAssistBot
- 주소(파일 출처): 104.43.54.127
verified: truename: DuckAssistBotoperator: DuckDuckGocategory: ai- UTC: 09:54:30
CCBot
- 주소(파일 출처): 18.97.9.169
verified: truename: CCBotoperator: CommonCrawlcategory: archiver- UTC: 09:54:46
Applebot
- 주소(파일 출처): 17.241.208.161
verified: truename: Applebotoperator: Applecategory: search_engine- UTC: 09:55:00
Bingbot
- 주소(파일 출처): 157.55.39.1
verified: truename: Bingbotoperator: Microsoftcategory: search_engine- UTC: 09:55:14
OAI-AdsBot(파일 미로드)
- 주소(파일 출처): 130.131.229.129 (adsbot.json)
verified: false,is_crawler: falsename: 없음operator: 없음category: 없음- UTC: 09:55:28
Amazonbot(페이지 미로드)
- 주소(파일 출처): 3.81.245.78 (Amazon의 페이지)
verified: false,is_crawler: falsename: 없음operator: 없음category: 없음- UTC: 09:55:42
Meta(네트워크, 파일 없음)
- 주소(파일 출처): 31.13.64.1
verified: false,unverified: truename: Facebook-Botoperator: Metacategory: social_preview- UTC: 09:55:56
함정은 name 필드에 있습니다. name은 마지막으로 로드된 파일의 라벨이므로 Anthropic의 봇 세 개는 모두 ClaudeBot을 반환하고, DuckDuckBot 주소는 DuckAssistBot을 반환하며, Google-CloudVertexBot은 Googlebot을 반환합니다. category는 역할 필드가 아닙니다. CCBot은 archiver를 반환하고 Applebot과 Bingbot은 search_engine을 반환합니다. 주장된 토큰과 operator를 함께 키로 사용하고, CommonCrawl은 공백 없이 쓰십시오.
놀라웠던 것은 4.227.36.1입니다. 이 주소는 gptbot.json과 searchbot.json이 모두 나열하는 4.227.36.0/25 안에 있습니다. 실제 응답을 줄인 사본은 다음과 같습니다.
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
GPTBot 요청이 OAISearchBot을 반환한다고 말하려는 것이 아닙니다. 두 파일에 모두 있는 그 주소가 그 이름을 반환하는 것이며, 우리 조회는 어떤 봇이 요청을 보냈는지 구분하지 못합니다. OpenAI 스스로도 "may use the results from just one crawl for both use cases"(한 번의 크롤링 결과를 두 용도에 모두 사용할 수 있다)고 말합니다. IP는 OpenAI임을 증명하고 User-Agent는 어느 봇인지를 말해 줍니다. OpenAI 봇 각각의 역할은 OpenAI 글에서 다룹니다.
미로드 사례는 단순합니다. OAI-AdsBot의 파일은 공개되어 있고 130.131.229.129는 그 안에 있지만, 우리 API는 is_crawler: false와 호스팅 응답(점수 15, allow, AS8075 Microsoft)을 반환합니다. Amazonbot 자체 페이지에 나열된 3.81.245.78도 API가 같은 종류의 응답(점수 16, allow, AS14618 Amazon)을 반환합니다. 우리 데이터에는 진짜 OAI-AdsBot을 그 클라우드의 다른 주소와 구분할 근거가 없습니다. Meta의 31.13.64.1은 Meta 네트워크(AS32934)의 주소이며 verified: false입니다. 이 주소가 크롤링하는 것은 관찰하지 못했습니다.
API는 어떤 파일이 일치했는지도, 그 파일을 언제 가져왔는지도 반환하지 않으며, 조회는 여러분의 User-Agent를 보지 못합니다. 필드에 대한 자세한 내용은 크롤러 필드에 있고, 로그에서 가져온 주소와 User-Agent를 크롤러 IP 검증 도구에 붙여 넣을 수도 있습니다. 이 도구는 threat.crawler.verified를 읽고, 운영자를 User-Agent가 지목한 봇과 브라우저에서 비교합니다.
로그의 IP를 올바른 파일과 대조하기
이 스니펫은 로그 한 줄의 IP와 그 줄이 주장하는 User-Agent를 받아, User-Agent에 적힌 봇의 파일만 불러온 뒤 주소가 그 파일에 있는지, 그리고 다른 어떤 파일에도 있는지 보고합니다. 허용이나 차단을 결정하지 않으며 목록도 쓰지 않습니다. 파서가 아니라 샘플입니다. 봇 토큰이 둘인 User-Agent는 더 긴 쪽과 매칭됩니다.
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
각 로그 줄은 <ip> <User-Agent> 형식입니다. 2026년 11월 9일 10:01 UTC에 아래 샘플로 실행했습니다. 45.33.32.156은 Nmap의 공개 스캔 호스트(그런 요청을 보낸 적 없음)이고 203.0.113.9와 2001:db8::1은 문서용 주소입니다.
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
OAI-AdsBot은 우리 API가 이 파일을 불러오지 않는데도 스니펫이 파일을 직접 읽기 때문에 여기서는 통과합니다. User-Agent 토큰 하나는 파일 하나에 대응하며, 이는 Perplexity의 규칙을 따릅니다. "Each bot has its own IP ranges, so match each User-Agent against its own IP ranges."(각 봇에는 자체 IP 대역이 있으므로 각 User-Agent를 자신의 IP 대역과 대조하십시오.) 파일에 접근할 수 없으면 결과는 "검증됨"이 아니라 "not verified"입니다. SSL_CERT_FILE을 존재하지 않는 경로로 지정했더니 모든 줄에 not verified: ... file unavailable이 출력되었습니다. 잘못된 IP 문자열은 실행을 멈추지 않고 "not verified"를 출력합니다. 스니펫이 자체 User-Agent를 설정하는 이유는 2026년 11월 9일에 claude.com이 Python의 기본 User-Agent에 403을 반환했고 다른 파일들은 200을 반환했기 때문입니다.
파일이 없는 봇에 대한 방법은 AI 크롤러와 에이전트를 검증하는 방법에 있습니다. 역방향 DNS와 서명입니다. Google은 https://agent.bot.goog 아이덴티티를 사용해 "is also experimenting with the Web Bot Auth protocol"(Web Bot Auth 프로토콜도 실험 중)이라고 밝히며, YouBot은 서명 디렉터리를 공개합니다.
로그에 나타나지 않는 이름, 그리고 출처를 찾지 못한 봇
다른 목록에 있는 이름 중에는 크롤러가 아니거나 우리가 열어 볼 수 있는 운영자 페이지가 없는 것들이 있습니다. 세 개는 요청자로 나타나지 않는 제어용 토큰이라 기록할 수도, IP로 검증할 수도 없습니다.
Google-Extended (Google)
- 로그에 나타나는가?: 아니요
- 운영자의 표현: "Google-Extended에는 별도의 HTTP 요청 user agent 문자열이 없습니다. 크롤링은 기존 Google user agent 문자열로 이루어지며, robots.txt user-agent 토큰은 제어 용도로 사용됩니다."
- 존중하는 곳: Google
Applebot-Extended (Apple)
- 로그에 나타나는가?: 아니요
- 운영자의 표현: "Applebot-Extended는 웹페이지를 크롤링하지 않습니다." 그리고 "Applebot-Extended는 Applebot user agent가 크롤링한 데이터를 어떻게 사용할지 결정하는 데만 쓰입니다."
- 존중하는 곳: Apple
__usage_ai-training (공유(IETF aipref 초안))
- 로그에 나타나는가?: 아니요, robots.txt 그룹 이름임
- 운영자의 표현: Microsoft: "2027년 2월 1일부터 Microsoft는 크롤링할 때 새 선호 설정을 따릅니다". Google: "2027년 초에 AIPREF 공통 기계 판독형 학습 선호 신호('user-agent: __usage_ai-training' 사용)를 지원할 계획입니다". Anthropic: "2026년 10월 30일부터 Anthropic은 기계 판독형 신호를 인식하기 시작했습니다"
- 존중하는 곳: 2026-10-30부터 Anthropic(해당 페이지는 토큰 이름을 밝히지 않음), 2027-02-01부터 Microsoft, "2027년 초" Google(계획), OpenAI는 확인하지 못함
Anthropic의 페이지는 이 신호가 "IETF의 aipref 워킹 그룹에서 진행한 작업을 바탕으로 한 초안"에 기반한다고 밝힙니다. OpenAI의 도움말 페이지는 열 수 없었으므로 OpenAI에 대해서는 어떤 주장도 하지 않습니다.
2026년 11월 9일에 아래 봇에 대해서는 운영자가 직접 관리하는 페이지를 찾지 못했습니다. 이 목록은 우리가 확인한 내용을 보여 줍니다. 여기에 없는 봇이 존재할 수도 있으며, 이 운영자들이 크롤러를 운영하지 않는다는 뜻은 아닙니다.
ByteDance: Bytespider
- 2026-11-09에 확인한 것: bytedance.com/robots.txt, bytedance.com/en/bytespider(404), bytespider.bytedance.com(DNS 없음), zhanzhang.toutiao.com 홈 페이지(크롤러 관련 텍스트 없음)
- 결과: ByteDance 페이지를 찾지 못함. 대역이 존재하는지에 대해 제3자의 의견이 엇갈리므로 역할도 대역도 단정하지 않음
xAI: Grok 관련 토큰
- 2026-11-09에 확인한 것: docs.x.ai/llms.txt(크롤러나 robots.txt 관련 텍스트 없음), docs.x.ai/docs/crawler(404), x.ai/grok-bot.json(403)
- 결과: 찾은 것 없음
Cohere: cohere-ai, cohere-training-data-crawler
- 2026-11-09에 확인한 것: docs.cohere.com/docs/cohere-web-crawlers(열림, 봇 표에 "N/A"로 표시), cohere.com/crawler(404), cohere.com/cohere-ai.json(404)
- 결과: 페이지에는 이렇게 적혀 있음. "현재로서는 생성형 AI 파운데이션 모델을 학습시키기 위해 웹 콘텐츠를 크롤링하거나 스크래핑하는 목적으로 Cohere 봇이나 user agent를 사용하지 않습니다."
DeepSeek: DeepSeekBot
- 2026-11-09에 확인한 것: deepseek.com/robots.txt, api-docs.deepseek.com/llms.txt(일치 항목 없음), deepseek.com/deepseekbot.json(404)
- 결과: 찾은 것 없음
일부 이름은 오래된 것입니다. anthropic-ai와 Claude-Web은 Anthropic의 페이지에 없고, FacebookBot은 Meta의 페이지에 없으며, Gemini-Deep-Research는 우리가 읽은 Google 크롤러 페이지 네 곳 어디에도 나오지 않습니다. 우리가 읽은 페이지에 문서화되어 있지 않으므로 이 중 어느 것도 봇으로 나열하지 않습니다.
이 목록을 확인한 방법과 변경 방식
GeoIPHub는 각 운영자의 페이지를 열고, 각 파일을 가져오고, 다시 세고, 위의 조회를 실행하는 방식으로 이 AI 크롤러 목록을 확인했습니다. 항목의 날짜는 해당 항목을 다시 확인할 때만 바뀝니다.
우리가 본 변경 사항과 그 날짜는 다음과 같습니다. Bingbot의 파일은 날짜가 2024-01-03으로 고정된 채 프리픽스가 28개에서 29개로 늘었습니다. ChatGPT-User의 파일은 234개였다가 10월 29일에 235개가 되었고, 2026년 11월 6일 날짜의 파일에서는 237개였습니다. Perplexity의 파일 두 개는 10월 27일에 4개와 8개, 10월 28일에 10개와 13개였습니다. Anthropic의 파일은 우리의 AI 크롤러 차단 글에서 프리픽스가 38개였고(파일 날짜 10월 7일), 지금은 10월 20일 날짜에 14개입니다. 운영자에 대해서도 우리 API에 대해서도 갱신 일정은 밝히지 않습니다. API는 가져온 날짜를 반환하지 않으므로, 운영자가 최근에 추가한 프리픽스는 아직 검증되지 않을 수 있습니다.
헤더의 이름은 주장일 뿐이며, 운영자가 파일을 공개한다면 증명은 그 운영자의 파일입니다.
자주 묻는 질문
AI 크롤러 목록이란 무엇입니까?
AI 기업과 검색 제품이 웹 페이지를 가져오기 위해 운영하는 자동화 클라이언트의 목록입니다. 각 항목에는 User-Agent, 역할(학습, 검색, 사용자 요청 페치, 에이전트), 증명할 수 있는 방법이 들어 있습니다. 2026년 11월 9일 기준 GeoIPHub 목록에는 운영자가 문서화한 봇 29개가 있으며, GeoIPHub API는 그중 16개를 IP로 검증합니다.
GPTBot과 ClaudeBot은 무엇이 다릅니까?
GPTBot은 OpenAI의 학습용 크롤러이고 ClaudeBot은 Anthropic의 크롤러입니다. 둘 다 대역 파일을 공개하며, Anthropic의 파일 하나는 Claude-User와 Claude-SearchBot도 포괄합니다. GeoIPHub API는 두 파일 어느 쪽의 주소든 검증합니다. OpenAI 봇 각각의 역할은 GPTBot vs OAI-SearchBot vs ChatGPT-User에서 다룹니다.
IP 대역을 공개하는 AI 크롤러는 어디입니까?
2026년 11월 9일 기준 운영자 10곳이 우리가 찾을 수 있었던 AI 봇용 대역 파일 22개를 공개합니다. OpenAI, Anthropic, Google, Perplexity, Mistral, Microsoft, Apple, DuckDuckGo, Common Crawl, Moonshot입니다. GeoIPHub는 그중 17개를 불러옵니다. Amazon은 웹 페이지에 주소를 나열하고, Meta와 MistralAI-Training은 아무것도 공개하지 않습니다.
User-Agent만으로 AI 크롤러를 검증할 수 있습니까?
아니요. User-Agent는 어떤 클라이언트든 보낼 수 있는 문자열입니다. GeoIPHub 조회는 IP만 받습니다. 그 주소가 OpenAI 또는 Anthropic의 파일 안에 있는지는 알려 줄 수 있고, 그 운영자가 User-Agent에 적힌 봇과 일치하는지는 여러분의 코드가 비교합니다.
Meta의 AI 크롤러는 어떤 User-Agent를 씁니까?
Meta는 학습용으로 meta-externalagent/1.1, Meta AI 검색용으로 meta-webindexer/1.1, 사용자 요청 페치용으로 meta-externalfetcher/1.1을 문서화합니다. Meta는 대역 파일을 공개하지 않으므로 GeoIPHub는 ASN으로 해당 네트워크를 매칭하고 verified: false를 반환합니다.
CCBot은 AI 크롤러입니까?
CCBot은 Common Crawl의 크롤러이며, Common Crawl은 이를 위해 IP 파일과 역방향 DNS를 공개합니다. 다른 목록들은 이 크롤러가 만드는 아카이브가 학습에 쓰일 수 있다는 이유로 AI 크롤러라고 부르지만, 그 연결은 그쪽의 해석이지 Common Crawl의 발표가 아닙니다. GeoIPHub는 해당 파일을 검증하며 카테고리 archiver를 반환합니다.
GeoIPHub API를 만드는 팀
GeoIPHub IP 인텔리전스 API와 스캐너를 만드는 GeoIPHub 팀이 작성했습니다. 초안은 AI의 도움을 받아 준비하고 팀이 편집합니다. API 예시는 예시용으로 표시된 경우를 제외하고 라이브 API에 대한 실제 조회 결과입니다.