Sécurité réseau
Liste des robots d'exploration IA : User-Agents de 29 bots et ceux que vous pouvez vérifier par IP
Une liste des robots d'exploration IA : 29 bots classés par fonction, avec User-Agents, formulation robots.txt et fichiers de plages, dont les 16 que GeoIPHub vérifie par IP, contrôlée le 9 novembre 2026.
Périmètre : les bots qu'un opérateur documente sur une page que nous avons pu ouvrir le 9 novembre 2026, tels qu'utilisés pour l'IA. Meta documente aussi meta-externalads, un robot publicitaire, que nous n'avons pas compté. Les noms qui circulent sur d'autres listes sans documentation de l'opérateur figurent dans une liste à part, avec ce que nous avons vérifié.
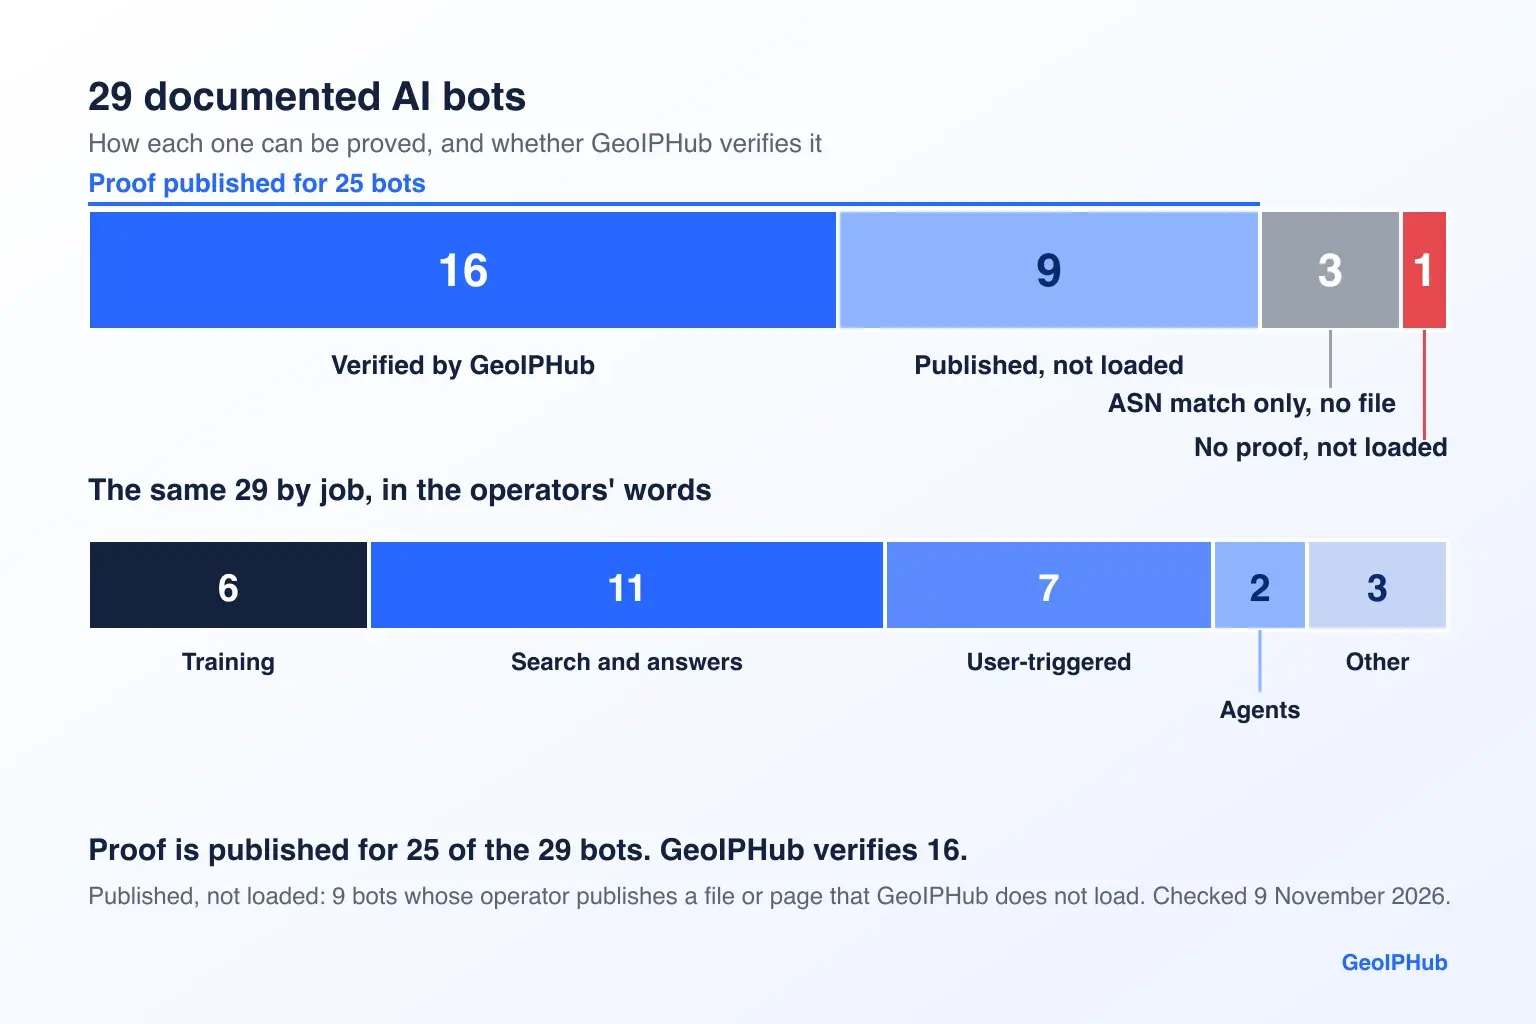
Les opérateurs publient un moyen de prouver 25 de ces 29 bots. L'API de GeoIPHub en vérifie 16. Les neuf autres ne sont pas un manque dans ce que les opérateurs documentent : ce sont des fichiers et des pages que nous ne chargeons pas, et la liste précise lesquels.
D'autres listes donnent des noms et des tokens, mais un nom dans un en-tête User-Agent ne prouve rien, car n'importe qui peut le saisir. La preuve des opérateurs prend cinq formes : un fichier JSON, une page web d'adresses, un reverse DNS, une signature ou rien. Cet article s'inscrit dans notre travail sur la détection des bots par IP. Ci-dessous : chaque bot par fonction, les 22 fichiers de plages avec leurs effectifs et leurs dates, ce que l'API de GeoIPHub a renvoyé pour une vraie adresse issue de 14 des fichiers que nous chargeons, un extrait de code qui compare une ligne de journal au bon fichier, et les noms qui n'apparaissent jamais dans vos journaux ou que nous n'avons pas pu sourcer.
La liste des robots d'exploration IA : 29 bots par fonction
Cette liste de robots d'exploration IA classe 29 bots documentés et leurs User-Agents selon la fonction que leur opérateur indique : entraînement, recherche, récupération déclenchée par l'utilisateur, agents, et un court groupe qui n'est rien de cela. Quatre termes reviennent dans chaque entrée. Preuve désigne ce que l'opérateur publie : un fichier de plages, une page web d'adresses, un reverse DNS, une signature ou rien. Vérifié signifie qu'une adresse issue du fichier propre à ce bot a renvoyé verified: true dans l'API de GeoIPHub à la date indiquée. Association par ASN seulement signifie que nous associons le réseau de l'opérateur et renvoyons verified: false. Non chargé signifie que nous ne chargeons pas la liste de l'opérateur.
Le regroupement suit les mots des opérateurs et n'est pas net. OpenAI écrit : « If your site has allowed both bots, we may use the results from just one crawl for both use cases » (« Si votre site a autorisé les deux bots, nous pouvons utiliser les résultats d'une seule exploration pour les deux usages »). Meta écrit « use cases such as training » (« des usages tels que l'entraînement »). Amazon écrit « may be used to train » (« peut servir à entraîner »). Le robot d'Apple est d'abord un robot de recherche et « may also be used to help train » ses modèles (« peut aussi servir à aider à entraîner »). La documentation de Cloudflare sur les bots trace la même répartition en trois : Search (« exploration pour construire des index de recherche ou des bases RAG »), Agent (« agents pilotés par l'utilisateur qui visitent une page au nom d'une personne ») et Training (« exploration pour entraîner ou affiner des modèles »).
Quels robots d'exploration IA entraînent des modèles ?
Six, selon la formulation même de leurs opérateurs.
GPTBot (OpenAI)
- Fragment UA : GPTBot/1.4
- Preuve : fichier
- robots.txt, mots de l'opérateur : « Interdire GPTBot indique que le contenu d'un site ne doit pas être utilisé pour entraîner des modèles de fondation d'IA générative. »
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
ClaudeBot (Anthropic)
- Fragment UA : ClaudeBot
- Preuve : fichier (partagé)
- robots.txt, mots de l'opérateur : « Les bots d'Anthropic respectent les signaux « ne pas explorer » en honorant les directives standard du secteur dans robots.txt. »
- Vérifié par GeoIPHub : vérifié (en tant qu'Anthropic)
- Contrôlé : 2026-11-09
MistralAI-Training (Mistral)
- Fragment UA : MistralAI-Training/1.0
- Preuve : aucune
- robots.txt, mots de l'opérateur : « Les webmasters peuvent interdire ce user-agent dans leur fichier robots.txt. »
- Vérifié par GeoIPHub : non chargé (mistralai-training-ips.json renvoie 404)
- Contrôlé : 2026-11-09
meta-externalagent (Meta)
- Fragment UA : meta-externalagent/1.1
- Preuve : aucune
- robots.txt, mots de l'opérateur : « Pour bloquer ces robots, ajoutez un Disallow pour le robot concerné dans robots.txt. »
- Vérifié par GeoIPHub : association par ASN seulement, non vérifié
- Contrôlé : 2026-11-09
Amazonbot (Amazon)
- Fragment UA : Amazonbot/0.1
- Preuve : page web seulement
- robots.txt, mots de l'opérateur : « L'exploration automatisée par ces user-agents listés respecte le Robots Exclusion Protocol, en honorant le user-agent et les directives allow/disallow. »
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
KimiBot (Moonshot)
- Fragment UA : KimiBot/1.0
- Preuve : fichier (un fichier, trois noms)
- robots.txt, mots de l'opérateur : non cité
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
L'objectif, dans les mots des opérateurs : GPTBot est « utilisé pour explorer du contenu susceptible de servir à entraîner nos modèles de fondation d'IA générative ». MistralAI-Training « explore du contenu web pour aider à constituer des jeux de données d'entraînement des modèles d'IA générative de Mistral ». KimiBot « explore du contenu potentiellement utilisé pour entraîner les modèles de fondation de Kimi ».
Quels robots d'exploration IA alimentent la recherche et les réponses ?
Onze, dont deux robots de recherche classiques présents dans notre ensemble chargé.
OAI-SearchBot (OpenAI)
- Fragment UA : OAI-SearchBot/1.4
- Preuve : fichier
- robots.txt, mots de l'opérateur : « Les sites qui ont désactivé OAI-SearchBot ne seront pas affichés dans les réponses de recherche de ChatGPT »
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
Claude-SearchBot (Anthropic)
- Fragment UA : Claude-SearchBot
- Preuve : fichier (partagé)
- robots.txt, mots de l'opérateur : même phrase d'Anthropic que pour ClaudeBot
- Vérifié par GeoIPHub : vérifié (en tant qu'Anthropic)
- Contrôlé : 2026-11-09
PerplexityBot (Perplexity)
- Fragment UA : PerplexityBot/1.0
- Preuve : fichier
- robots.txt, mots de l'opérateur : non cité
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
MistralAI-Index (Mistral)
- Fragment UA : MistralAI-Index/1.0
- Preuve : fichier
- robots.txt, mots de l'opérateur : non cité
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
meta-webindexer (Meta)
- Fragment UA : meta-webindexer/1.1
- Preuve : aucune
- robots.txt, mots de l'opérateur : même phrase de Meta que pour meta-externalagent
- Vérifié par GeoIPHub : association par ASN seulement, non vérifié
- Contrôlé : 2026-11-09
Amzn-SearchBot (Amazon)
- Fragment UA : Amzn-SearchBot/0.1
- Preuve : page web seulement
- robots.txt, mots de l'opérateur : « Si les fichiers robots.txt ne mentionnent pas Amzn-SearchBot mais autorisent d'autres bots de recherche, Amzn-SearchBot explorera conformément aux directives robots.txt données aux autres bots de recherche. »
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
Applebot (Apple)
- Fragment UA : Applebot/0.1
- Preuve : fichier + reverse DNS
- robots.txt, mots de l'opérateur : « Applebot respecte en général les directives robots.txt standard lors des explorations de recherche générales ciblant Applebot. »
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
Bingbot (Microsoft)
- Fragment UA : Bingbot
- Preuve : fichier
- robots.txt, mots de l'opérateur : non cité (la page de Microsoft nécessite JavaScript, nous n'avons donc pas pu la lire)
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
DuckAssistBot (DuckDuckGo)
- Fragment UA : DuckAssistBot/1.2
- Preuve : fichier
- robots.txt, mots de l'opérateur : « Une fois le fichier mis à jour pour interdire le user-agent DuckAssistBot, la modification prendra effet après 72 heures et DuckAssistBot cessera d'explorer votre site. »
- Vérifié par GeoIPHub : vérifié (les adresses de DuckDuckBot renvoient aussi ce nom)
- Contrôlé : 2026-11-09
Kimi-SearchBot (Moonshot)
- Fragment UA : Kimi-SearchBot/1.0
- Preuve : fichier (partagé)
- robots.txt, mots de l'opérateur : non cité
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
YouBot (You.com)
- Fragment UA : YouBot/1.0
- Preuve : signature + reverse DNS + page web seulement (un /24)
- robots.txt, mots de l'opérateur : « Il respecte les directives robots.txt et les préférences de fréquence d'exploration »
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
Bingbot et Applebot figurent ici parce qu'ils sont dans notre ensemble chargé et qu'Apple dit que son robot peut aider à entraîner ses modèles. Nous n'avons pas pu lire la page de Microsoft sur son robot, qui nécessite JavaScript, mais son article du 30 octobre définit les préférences IA via Bingbot. YouBot est la seule entrée avec trois preuves : un répertoire de signatures à you.com/.well-known/http-message-signatures-directory, un reverse DNS de la forme youbot-68-67-112-106 et la déclaration « Les requêtes légitimes de YouBot proviennent de 68.67.112.0/24. »
L'objectif, dans les mots des opérateurs : PerplexityBot est « conçu pour faire apparaître et lier des sites dans les résultats de recherche de Perplexity. Il n'est pas utilisé pour explorer du contenu destiné aux modèles de fondation d'IA. » MistralAI-Index sert « à l'exploration automatisée du web à des fins d'indexation uniquement ». DuckAssistBot « explore des pages en temps réel pour nos réponses assistées par IA » et « Ces données ne sont en aucun cas utilisées pour entraîner des modèles d'IA. »
Quels robots d'exploration IA récupèrent une page parce qu'un utilisateur l'a demandé ?
Sept, plus les fetchers déclenchés par l'utilisateur de Google.
ChatGPT-User (OpenAI)
- Fragment UA : ChatGPT-User/1.0
- Preuve : fichier
- robots.txt, mots de l'opérateur : « Ces actions étant initiées par un utilisateur, les règles robots.txt peuvent ne pas s'appliquer. »
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
Claude-User (Anthropic)
- Fragment UA : Claude-User
- Preuve : fichier (partagé)
- robots.txt, mots de l'opérateur : la phrase d'Anthropic pour tous ses bots (voir ClaudeBot) ; aucune exception pour les requêtes déclenchées par l'utilisateur trouvée
- Vérifié par GeoIPHub : vérifié (en tant qu'Anthropic)
- Contrôlé : 2026-11-09
Perplexity-User (Perplexity)
- Fragment UA : Perplexity-User/1.0
- Preuve : fichier
- robots.txt, mots de l'opérateur : « Puisqu'un utilisateur a demandé la récupération, ce fetcher ignore généralement les règles robots.txt. »
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
MistralAI-User (Mistral)
- Fragment UA : MistralAI-User/1.0
- Preuve : fichier
- robots.txt, mots de l'opérateur : « MistralAI-User détermine sur quels sites ces requêtes d'utilisateurs peuvent être effectuées. »
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
meta-externalfetcher (Meta)
- Fragment UA : meta-externalfetcher/1.1
- Preuve : aucune
- robots.txt, mots de l'opérateur : « peut contourner robots.txt car il effectue des récupérations demandées par l'utilisateur »
- Vérifié par GeoIPHub : association par ASN seulement, non vérifié
- Contrôlé : 2026-11-09
Amzn-User (Amazon)
- Fragment UA : Amzn-User/0.1
- Preuve : page web seulement
- robots.txt, mots de l'opérateur : « Les actions d'Amzn-User pouvant être initiées par un utilisateur, il peut ne pas suivre toutes les directives robots.txt. »
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
Kimi-User (Moonshot)
- Fragment UA : Kimi-User/1.0
- Preuve : fichier (partagé)
- robots.txt, mots de l'opérateur : « les actions étant déclenchées par l'utilisateur, les règles robots.txt peuvent ne pas s'appliquer directement »
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
La page de Google nomme aussi Google-GeminiNotebook, qui « demande des URL individuelles que les utilisateurs de Gemini Notebook ont fournies comme sources ». Elle ne dit pas lequel des fichiers de plages de Google pour les fetchers déclenchés par l'utilisateur le liste ; nous n'avons donc pas pu le tester et l'avons laissé hors de la liste.
Quels bots IA sont des agents ?
Deux, tous deux documentés comme des agents qui naviguent sur le web pour un utilisateur.
Google-Agent (Google)
- Fragment UA : Google-Agent
- Preuve : fichier (+ signature, en test)
- robots.txt, mots de l'opérateur : les fetchers déclenchés par l'utilisateur « ignorent généralement les règles robots.txt » (déclaration au niveau de la page)
- Vérifié par GeoIPHub : vérifié
- Contrôlé : 2026-11-09
Claude-Agent (Anthropic)
- Fragment UA : Claude-Agent/1.0
- Preuve : fichier (SAIL, TOML, pas JSON)
- robots.txt, mots de l'opérateur : « Vos préférences pour les robots d'Anthropic (robots d'exploration et fetchers) sont indépendantes et vous pouvez les gérer séparément. » (la page de l'agent n'aborde pas robots.txt pour le navigateur lui-même)
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
Google-Agent est « utilisé par des agents hébergés sur l'infrastructure de Google pour naviguer sur le web et effectuer des actions à la demande de l'utilisateur ». Pour Claude-Agent, Anthropic indique de « faire la correspondance sur le token Claude-Agent plutôt que sur la chaîne complète ».
Quels bots IA ne sont rien de tout cela ?
Trois, chacun documenté par son opérateur pour une fonction différente.
OAI-AdsBot (OpenAI)
- Fragment UA : OAI-AdsBot/1.0
- Preuve : fichier
- robots.txt, mots de l'opérateur : non cité (aucune déclaration trouvée sur la page d'OpenAI)
- Vérifié par GeoIPHub : non chargé
- Contrôlé : 2026-11-09
CCBot (Common Crawl)
- Fragment UA : CCBot/2.0
- Preuve : fichier + reverse DNS
- robots.txt, mots de l'opérateur : la page donne
User-agent: CCBotetDisallow: / - Vérifié par GeoIPHub : vérifié (catégorie
archiver) - Contrôlé : 2026-11-09
Google-CloudVertexBot (Google)
- Fragment UA : Google-CloudVertexBot
- Preuve : fichier (le fichier des robots communs de Google)
- robots.txt, mots de l'opérateur : non cité
- Vérifié par GeoIPHub : vérifié (fichier partagé des robots communs)
- Contrôlé : 2026-11-09
OAI-AdsBot est « utilisé pour valider la sécurité des pages web soumises comme annonces sur ChatGPT ». Google-CloudVertexBot « explore à la demande des propriétaires de sites pour construire des agents Vertex AI ». Common Crawl dit : « nous savons que des robots se font faussement passer pour CCBot ». La référence AI Crawl Control de Cloudflare liste CCBot comme robot d'exploration IA ; ce lien avec l'entraînement est celui d'un tiers, pas celui de Common Crawl.
Ce que coûte le blocage de chaque fonction est détaillé dans bloquer les robots d'exploration IA.
Les bots déclenchés par l'utilisateur traitent robots.txt différemment, selon les mots mêmes de leurs opérateurs
Les bots IA déclenchés par l'utilisateur comme ChatGPT-User, Perplexity-User et Claude-User ne partagent pas une même règle robots.txt : chaque opérateur dit quelque chose de différent, et l'un ne dit rien de particulier. La récupération agit pour une seule personne, ce qui est la raison qu'invoquent la plupart d'entre eux.
- ChatGPT-User (OpenAI) : « Ces actions étant initiées par un utilisateur, les règles robots.txt peuvent ne pas s'appliquer. »
- Perplexity-User (Perplexity) : « Puisqu'un utilisateur a demandé la récupération, ce fetcher ignore généralement les règles robots.txt. »
- fetchers déclenchés par l'utilisateur, dont Google-Agent (Google) : « La récupération ayant été demandée par un utilisateur, ces fetchers ignorent généralement les règles robots.txt. »
- meta-externalfetcher (Meta) : « peut contourner robots.txt car il effectue des récupérations demandées par l'utilisateur »
- Amzn-User (Amazon) : « Les actions d'Amzn-User pouvant être initiées par un utilisateur, il peut ne pas suivre toutes les directives robots.txt. »
- Kimi-User (Moonshot) : « les actions étant déclenchées par l'utilisateur, les règles robots.txt peuvent ne pas s'appliquer directement »
- MistralAI-User (Mistral) : « MistralAI-User détermine sur quels sites ces requêtes d'utilisateurs peuvent être effectuées. »
- Claude-User (Anthropic) : « Les bots d'Anthropic respectent les signaux « ne pas explorer » en honorant les directives standard du secteur dans robots.txt. » et « Claude-User permet aux propriétaires de sites de contrôler les sites auxquels ces requêtes initiées par l'utilisateur peuvent accéder. »
Anthropic fait figure d'exception : sa phrase ne prévoit aucune exception pour les requêtes déclenchées par l'utilisateur. « Peuvent ne pas s'appliquer », « ignorent généralement », « peut contourner » et « peut ne pas suivre toutes » sont quatre degrés de force différents ; une seule règle pour tout le groupe en déformerait la plupart.
Quels robots d'exploration IA publient leurs plages d'IP ? 22 fichiers de plages de 10 opérateurs
Dix opérateurs publient 22 fichiers de plages pour les bots IA que nous avons pu trouver ; GeoIPHub en charge 17. Ces plages d'IP de robots d'exploration IA se présentent sous quatre états. OpenAI, Perplexity, Mistral et le fichier d'agents de Google fournissent un fichier JSON par bot. Les trois bots d'Anthropic partagent un seul fichier, et les trois fichiers de Kimi ainsi que les deux fichiers de DuckDuckGo sont identiques octet pour octet. Les trois bots d'Amazon n'ont qu'une page web, chacune avec son propre creationTime. Meta et MistralAI-Training ne publient rien, et nous n'avons trouvé aucun fichier chez les opérateurs de la dernière section. Claude-Agent publie dans un format plus récent, un fichier TOML à claude.com/.well-known/sail (draft-kelley-webbotauth-sail-00). Les plages IP de ClaudeBot et de PerplexityBot suivent une vraie requête issue de chaque fichier.
GeoIPHub charge 19 fichiers de plages officiels de 10 opérateurs. 17 d'entre eux figurent dans cette liste ; les deux autres sont duckduckbot.json, identique au fichier DuckDuckGo ci-dessous, et Ahrefs, qui n'est pas un bot IA. Les 22 fichiers forment 20 listes distinctes. Récupérés le 9 novembre 2026 à 09:51 UTC, tous avec HTTP 200 :
1. GPTBot
- Fichier : gptbot.json
- Préfixes IPv4 / IPv6 : 18 / 0
creationTime: 2026-09-22- Chargé : oui
2. OAI-SearchBot
- Fichier : searchbot.json
- Préfixes IPv4 / IPv6 : 39 / 0
creationTime: 2026-01-02- Chargé : oui
3. ChatGPT-User
- Fichier : chatgpt-user.json
- Préfixes IPv4 / IPv6 : 237 / 0
creationTime: 2026-11-06- Chargé : oui
4. OAI-AdsBot
- Fichier : adsbot.json
- Préfixes IPv4 / IPv6 : 2 / 0
creationTime: 2026-05-12- Chargé : non
5. ClaudeBot, Claude-User, Claude-SearchBot
- Fichier : bots.json
- Préfixes IPv4 / IPv6 : 14 / 0
creationTime: 2026-10-20- Chargé : oui
6. Claude-Agent
- Fichier : sail (TOML)
- Préfixes IPv4 / IPv6 : 9 / 0
creationTime: modifié 2026-10-22- Chargé : non
7. Googlebot et robots communs, dont Google-CloudVertexBot
- Fichier : common-crawlers.json
- Préfixes IPv4 / IPv6 : 170 / 147
creationTime: 2026-11-06- Chargé : oui
8. Robots à cas particuliers
- Fichier : special-crawlers.json
- Préfixes IPv4 / IPv6 : 136 / 136
creationTime: 2026-11-06- Chargé : oui
9. Fetchers déclenchés par l'utilisateur
- Fichier : user-triggered-fetchers.json
- Préfixes IPv4 / IPv6 : 544 / 544
creationTime: 2026-11-06- Chargé : oui
10. Fetchers déclenchés par l'utilisateur (google.com)
- Fichier : user-triggered-fetchers-google.json
- Préfixes IPv4 / IPv6 : 252 / 252
creationTime: 2026-11-06- Chargé : oui
11. Google-Agent
- Fichier : user-triggered-agents.json
- Préfixes IPv4 / IPv6 : 12 / 8
creationTime: 2026-11-06- Chargé : oui
12. PerplexityBot
- Fichier : perplexitybot.json
- Préfixes IPv4 / IPv6 : 13 / 0
creationTime: 2026-10-28- Chargé : oui
13. Perplexity-User
- Fichier : perplexity-user.json
- Préfixes IPv4 / IPv6 : 10 / 0
creationTime: 2026-10-28- Chargé : oui
14. MistralAI-User
- Fichier : mistralai-user-ips.json
- Préfixes IPv4 / IPv6 : 4 / 0
creationTime: 2025-02-19- Chargé : oui
15. MistralAI-Index
- Fichier : mistralai-index-ips.json
- Préfixes IPv4 / IPv6 : 2 / 0
creationTime: 2026-04-19- Chargé : oui
16. Bingbot
- Fichier : bingbot.json
- Préfixes IPv4 / IPv6 : 29 / 0
creationTime: 2024-01-03- Chargé : oui
17. Applebot
- Fichier : applebot.json
- Préfixes IPv4 / IPv6 : 24 / 0
creationTime: 2026-09-15- Chargé : oui
18. DuckAssistBot (même liste que duckduckbot.json)
- Fichier : duckassistbot.json
- Préfixes IPv4 / IPv6 : 486 / 0
creationTime: 2026-09-01- Chargé : oui
19. CCBot
- Fichier : ccbot.json
- Préfixes IPv4 / IPv6 : 4 / 1
creationTime: 2026-08-11- Chargé : oui
20. KimiBot
- Fichier : kimibot.json
- Préfixes IPv4 / IPv6 : 4 / 0
creationTime: 2026-05-18- Chargé : non
21. Kimi-User
- Fichier : kimi-user.json
- Préfixes IPv4 / IPv6 : 4 / 0
creationTime: 2026-05-18- Chargé : non
22. Kimi-SearchBot
- Fichier : kimi-searchbot.json
- Préfixes IPv4 / IPv6 : 4 / 0
creationTime: 2026-05-18- Chargé : non
La date d'un fichier ne prouve pas que la liste est inchangée : le fichier de Bingbot est passé de 28 à 29 préfixes alors que sa date restait 2024-01-03. Nous en comptions 28 dans notre article du 29 octobre et 29 le 9 novembre, et nous n'avons aucune copie antérieure, donc nous ne pouvons pas dire quel préfixe a été ajouté. Les fichiers à cas particuliers et déclenchés par l'utilisateur de Google couvrent aussi des fetchers non IA ; Google y liste ses fetchers IA.
Les trois pages d'Amazon ne sont pas des fichiers. developer.amazon.com/amazonbot/ip-addresses/ (Amazonbot), .../searchbot-ip-addresses/ (Amzn-SearchBot) et .../live-ip-addresses/ (Amzn-User) portent des valeurs creationTime intégrées de 2026-09-08, 2026-09-08 et 2025-11-04. Nous ne les chargeons pas. Les deux fichiers de DuckDuckGo ont le même hachage MD5, comme les trois de Kimi. L'unique fichier d'Anthropic couvre trois bots, et Anthropic dit : « Si un robot a une adresse IP source figurant sur cette liste, cela indique que le robot provient d'Anthropic. »
Six préfixes sont identiques dans gptbot.json et searchbot.json à cette date : 4.227.36.0/25, 74.7.175.128/25, 74.7.228.0/25, 74.7.230.0/25, 74.7.241.128/25 et 74.7.244.0/25. chatgpt-user.json n'en partage aucun avec eux. Notre liste d'IP de robots d'exploration vérifiés montre comment construire une allowlist à partir de ces fichiers.
Quels bots IA GeoIPHub peut-il vérifier ? 16 sur 29 au 9 novembre
L'API de GeoIPHub vérifie une adresse lorsqu'elle se trouve dans un fichier que nous chargeons, et cela prouve l'opérateur, pas le bot. Nous avons interrogé une vraie adresse issue de 14 des 17 fichiers que nous chargeons (tous sauf le fichier à cas particuliers de Google et ses deux fichiers de fetchers déclenchés par l'utilisateur), plus trois cas de contraste, sans clé, à environ 14 secondes d'intervalle, le 9 novembre 2026 de 09:52 à 09:55 UTC. Chaque requête vérifiée a aussi renvoyé verification_method: "ip_range_list", scoring.recommended_action: "allow" et un fraud_score de 0.
OAI-SearchBot
- Adresse (issue du fichier) : 4.227.36.1 (searchbot.json et gptbot.json)
verified: truename: OAISearchBotoperator: OpenAIcategory: ai- UTC : 09:52:11
GPTBot
- Adresse (issue du fichier) : 132.196.86.1 (gptbot.json)
verified: truename: GPTBotoperator: OpenAIcategory: ai- UTC : 09:52:25
ChatGPT-User
- Adresse (issue du fichier) : 104.208.184.193
verified: truename: ChatGPTUseroperator: OpenAIcategory: ai- UTC : 09:52:39
ClaudeBot, Claude-SearchBot, Claude-User
- Adresse (issue du fichier) : 216.73.216.10 (bots.json)
verified: truename: ClaudeBotoperator: Anthropiccategory: ai- UTC : 09:52:52
PerplexityBot
- Adresse (issue du fichier) : 107.20.236.150
verified: truename: PerplexityBotoperator: Perplexitycategory: ai- UTC : 09:53:06
Perplexity-User
- Adresse (issue du fichier) : 18.97.43.80
verified: truename: PerplexityUseroperator: Perplexitycategory: ai- UTC : 09:53:20
MistralAI-User
- Adresse (issue du fichier) : 20.240.160.161
verified: truename: MistralAIUseroperator: Mistralcategory: ai- UTC : 09:53:33
MistralAI-Index
- Adresse (issue du fichier) : 135.225.57.92
verified: truename: MistralAIIndexoperator: Mistralcategory: ai- UTC : 09:53:47
Google-Agent
- Adresse (issue du fichier) : 136.121.16.1
verified: truename: GoogleUserTriggeredAgentoperator: Googlecategory: ai- UTC : 09:54:01
Google-CloudVertexBot
- Adresse (issue du fichier) : 192.178.4.1 (common-crawlers.json)
verified: truename: Googlebotoperator: Googlecategory: search_engine- UTC : 09:54:15
DuckAssistBot
- Adresse (issue du fichier) : 104.43.54.127
verified: truename: DuckAssistBotoperator: DuckDuckGocategory: ai- UTC : 09:54:30
CCBot
- Adresse (issue du fichier) : 18.97.9.169
verified: truename: CCBotoperator: CommonCrawlcategory: archiver- UTC : 09:54:46
Applebot
- Adresse (issue du fichier) : 17.241.208.161
verified: truename: Applebotoperator: Applecategory: search_engine- UTC : 09:55:00
Bingbot
- Adresse (issue du fichier) : 157.55.39.1
verified: truename: Bingbotoperator: Microsoftcategory: search_engine- UTC : 09:55:14
OAI-AdsBot (fichier non chargé)
- Adresse (issue du fichier) : 130.131.229.129 (adsbot.json)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC : 09:55:28
Amazonbot (page non chargée)
- Adresse (issue du fichier) : 3.81.245.78 (page d'Amazon)
verified: false,is_crawler: falsename: noneoperator: nonecategory: none- UTC : 09:55:42
Meta (réseau, pas de fichier)
- Adresse (issue du fichier) : 31.13.64.1
verified: false,unverified: truename: Facebook-Botoperator: Metacategory: social_preview- UTC : 09:55:56
Les pièges se trouvent dans le champ name. name est l'étiquette du dernier fichier chargé, donc les trois bots d'Anthropic renvoient tous ClaudeBot, les adresses de DuckDuckBot renvoient DuckAssistBot, et Google-CloudVertexBot renvoie Googlebot. category n'est pas un champ de fonction : CCBot renvoie archiver, et Applebot et Bingbot renvoient search_engine. Servez-vous du token revendiqué plus operator comme clé, et écrivez CommonCrawl sans espace.
La surprise a été 4.227.36.1. Cette adresse se trouve dans 4.227.36.0/25, que gptbot.json et searchbot.json listent tous deux. Une copie abrégée de la vraie réponse :
{
  "threat": {
    "is_crawler": true,
    "crawler": {
      "verified": true,
      "unverified": false,
      "name": "OAISearchBot",
      "operator": "OpenAI",
      "category": "ai",
      "verification_method": "ip_range_list"
    }
  },
  "scoring": { "fraud_score": 0, "recommended_action": "allow" },
  "asn": { "asn": 8075 }
}
Nous ne disons pas qu'une requête de GPTBot renvoie OAISearchBot. L'adresse, qui figure dans les deux fichiers, renvoie ce nom, et notre requête ne peut pas dire quel bot a envoyé une requête. OpenAI dit lui-même qu'il « peut utiliser les résultats d'une seule exploration pour les deux usages ». L'IP prouve OpenAI et le User-Agent dit de quel bot il s'agit ; l'article sur OpenAI détaille ce que fait chaque bot d'OpenAI.
Les cas non chargés sont simples. Le fichier d'OAI-AdsBot est publié et 130.131.229.129 s'y trouve, mais notre API renvoie is_crawler: false et une réponse d'hébergement (score 15, allow, AS8075 Microsoft). La page même d'Amazonbot liste 3.81.245.78 et l'API renvoie le même type de réponse (score 16, allow, AS14618 Amazon). Rien dans nos données ne distingue un vrai OAI-AdsBot de n'importe quelle autre adresse de ce cloud. L'adresse 31.13.64.1 de Meta est une adresse du réseau de Meta (AS32934), verified: false ; nous ne l'avons pas observée en train d'explorer.
L'API ne renvoie ni quel fichier a correspondu ni quand il a été récupéré, et une requête ne voit jamais votre User-Agent. Les détails des champs se trouvent dans les champs de robots d'exploration, et vous pouvez coller une adresse issue de vos journaux, avec son user agent, dans le vérificateur d'IP de robots d'exploration. Il lit threat.crawler.verified et compare l'opérateur au bot que nomme votre user agent, dans votre navigateur.
Comparer une IP de vos journaux au bon fichier
Cet extrait prend l'IP d'une ligne de journal et le User-Agent qu'elle revendique, charge uniquement le fichier du bot nommé dans le User-Agent, et indique si l'adresse y figure et quels autres fichiers la listent aussi. Il ne prend aucune décision d'autorisation ou de blocage et n'écrit aucune liste. C'est un exemple, pas un analyseur : un User-Agent contenant deux tokens de bots correspond au plus long.
import ipaddress, json, sys, urllib.request

# claude.com returns 403 to Python's default User-Agent, so send our own.
HEADERS = {"User-Agent": "ai-log-check/1.0 (+https://geoiphub.com)"}
FILES = {  # claimed UA token (lowercase), mapped to that bot's own range file; add bots in the same JSON shape
    "gptbot": "https://openai.com/gptbot.json",
    "oai-searchbot": "https://openai.com/searchbot.json",
    "chatgpt-user": "https://openai.com/chatgpt-user.json",
    "oai-adsbot": "https://openai.com/adsbot.json",
    "claudebot": "https://claude.com/crawling/bots.json",
    "claude-searchbot": "https://claude.com/crawling/bots.json",
    "claude-user": "https://claude.com/crawling/bots.json",
    "perplexitybot": "https://www.perplexity.ai/perplexitybot.json",
    "perplexity-user": "https://www.perplexity.ai/perplexity-user.json",
    "mistralai-user": "https://mistral.ai/mistralai-user-ips.json",
    "mistralai-index": "https://mistral.ai/mistralai-index-ips.json",
    "duckassistbot": "https://duckduckgo.com/duckassistbot.json",
    "ccbot": "https://index.commoncrawl.org/ccbot.json",
}
_cache = {}

def nets(url):
    """Prefixes of one file; None if it cannot be fetched or parsed (fail closed)."""
    if url not in _cache:
        try:
            req = urllib.request.Request(url, headers=HEADERS)
            data = json.load(urllib.request.urlopen(req, timeout=15))
            _cache[url] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"])
                           for p in data["prefixes"]]
        except Exception:
            _cache[url] = None
    return _cache[url]

def check(ip, ua):
    ua = ua.lower()
    # A UA with two bot tokens matches the longest; this is a sample, not a parser.
    token = next((t for t in sorted(FILES, key=len, reverse=True) if t in ua), None)
    if token is None:
        return "no AI bot claimed", []
    try:
        addr = ipaddress.ip_address(ip)
    except ValueError:
        return f"not verified: {ip!r} is not an IP address", []
    own = nets(FILES[token])
    if own is None:
        return f"not verified: {token} file unavailable", []
    hits = sorted({u.rsplit("/", 1)[-1] for u in set(FILES.values())
                   if (n := nets(u)) and any(addr in x for x in n)})
    own_name = FILES[token].rsplit("/", 1)[-1]
    if own_name in hits:
        return f"{token}: in {own_name}", [h for h in hits if h != own_name]
    return f"not verified: {ip} is not in {own_name}", hits

if __name__ == "__main__":
    for line in sys.stdin:  # each line: <ip> <user agent>
        ip, _, ua = line.strip().partition(" ")
        verdict, also = check(ip, ua)
        print(ip, "|", verdict, "| also in:", ", ".join(also) or "-")
Chaque ligne de journal a la forme <ip> <User-Agent>. Nous l'avons exécuté le 9 novembre 2026 à 10:01 UTC sur cet échantillon, où 45.33.32.156 est l'hôte public d'analyse de Nmap (il n'a envoyé aucune requête de ce type) et 203.0.113.9 et 2001:db8::1 sont des adresses de documentation :
132.196.86.1 Mozilla/5.0 compatible; GPTBot/1.4
216.73.216.10 Mozilla/5.0 compatible; Claude-SearchBot
130.131.229.129 Mozilla/5.0 compatible; OAI-AdsBot/1.0
45.33.32.156 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; GPTBot/1.4
4.227.36.1 Mozilla/5.0 compatible; OAI-SearchBot/1.4
203.0.113.9 Mozilla/5.0 (Windows NT 10.0) Chrome/126.0
2001:db8::1 Mozilla/5.0 compatible; CCBot/2.0
132.196.86.1 | gptbot: in gptbot.json | also in: -
216.73.216.10 | claude-searchbot: in bots.json | also in: -
130.131.229.129 | oai-adsbot: in adsbot.json | also in: -
45.33.32.156 | not verified: 45.33.32.156 is not in gptbot.json | also in: -
4.227.36.1 | gptbot: in gptbot.json | also in: searchbot.json
4.227.36.1 | oai-searchbot: in searchbot.json | also in: gptbot.json
203.0.113.9 | no AI bot claimed | also in: -
2001:db8::1 | not verified: 2001:db8::1 is not in ccbot.json | also in: -
OAI-AdsBot passe ici parce que l'extrait lit lui-même le fichier, même si notre API ne le charge pas. Un token User-Agent correspond à un fichier, selon la règle de Perplexity : « Chaque bot a ses propres plages d'IP, donc comparez chaque User-Agent à ses propres plages d'IP. » Un fichier inaccessible signifie « not verified », jamais « verified » : avec SSL_CERT_FILE pointant vers un chemin inexistant, chaque ligne affichait not verified: ... file unavailable. Une chaîne d'IP invalide affiche « not verified » au lieu d'arrêter l'exécution. L'extrait définit son propre User-Agent parce que claude.com a renvoyé 403 au User-Agent par défaut de Python le 9 novembre 2026 alors que les autres fichiers renvoyaient 200.
Pour les bots sans fichier, les méthodes sont décrites dans comment vérifier les robots d'exploration et agents IA : reverse DNS et signatures. Google dit qu'il « expérimente aussi le protocole Web Bot Auth », avec l'identité https://agent.bot.goog, et YouBot publie un répertoire de signatures.
Les noms qui n'atteignent jamais vos journaux, et les bots que nous n'avons pas pu sourcer
Certains noms figurant sur d'autres listes ne sont pas des robots d'exploration, ou n'ont pas de page d'opérateur que nous avons pu ouvrir. Trois sont des tokens de contrôle qui n'apparaissent jamais comme demandeur ; aucun d'eux ne peut donc être journalisé ni vérifié par IP.
Google-Extended (Google)
- Dans vos journaux ? : Non
- Mots de l'opérateur : « Google-Extended n'a pas de chaîne user-agent de requête HTTP distincte. L'exploration est effectuée avec les chaînes user-agent Google existantes ; le token user-agent de robots.txt est utilisé à titre de contrôle. »
- Honoré par : Google
Applebot-Extended (Apple)
- Dans vos journaux ? : Non
- Mots de l'opérateur : « Applebot-Extended n'explore pas les pages web. » et « Applebot-Extended sert uniquement à déterminer comment utiliser les données explorées par le user-agent Applebot. »
- Honoré par : Apple
__usage_ai-training (partagé (brouillon IETF aipref))
- Dans vos journaux ? : Non, c'est un nom de groupe de robots.txt
- Mots de l'opérateur : Microsoft : « À partir du 1er février 2027, Microsoft honorera les nouvelles préférences lors de son exploration ». Google : « prévoit de prendre en charge le signal partagé de préférence d'entraînement lisible par machine AIPREF (avec « user-agent: __usage_ai-training ») début 2027 ». Anthropic : « Depuis le 30 octobre 2026, Anthropic a commencé à reconnaître un signal lisible par machine »
- Honoré par : Anthropic depuis 2026-10-30 (sa page ne nomme pas le token) ; Microsoft depuis 2027-02-01 ; Google « début 2027 » (intention) ; OpenAI non vérifié
La page d'Anthropic dit que son signal repose sur « un brouillon fondé sur les travaux de l'IETF ... dans son groupe de travail aipref ». Nous n'avons pas pu ouvrir les pages d'aide d'OpenAI, nous ne faisons donc aucune affirmation sur OpenAI.
Le 9 novembre 2026, nous n'avons trouvé aucune page tenue par l'opérateur pour les bots ci-dessous. Cette liste indique ce que nous avons vérifié. Un bot absent d'ici peut quand même exister ; nous ne disons pas que ces opérateurs n'exploitent aucun robot d'exploration.
ByteDance : Bytespider
- Ce que nous avons vérifié le 2026-11-09 : bytedance.com/robots.txt ; bytedance.com/en/bytespider (404) ; bytespider.bytedance.com (pas de DNS) ; page d'accueil de zhanzhang.toutiao.com (aucun texte sur un robot)
- Résultat : Aucune page de ByteDance trouvée. Des tiers ne s'accordent pas sur l'existence de plages, nous n'indiquons donc ni fonction ni plage
xAI : tokens liés à Grok
- Ce que nous avons vérifié le 2026-11-09 : docs.x.ai/llms.txt (aucun texte sur un robot ou robots.txt) ; docs.x.ai/docs/crawler (404) ; x.ai/grok-bot.json (403)
- Résultat : Rien trouvé
Cohere : cohere-ai, cohere-training-data-crawler
- Ce que nous avons vérifié le 2026-11-09 : docs.cohere.com/docs/cohere-web-crawlers (s'ouvre ; le tableau des bots indique « N/A ») ; cohere.com/crawler (404) ; cohere.com/cohere-ai.json (404)
- Résultat : La page dit : « Nous n'utilisons pas, pour le moment, de bots ou de user-agents Cohere pour explorer ou extraire du contenu web afin d'entraîner des modèles de fondation d'IA générative. »
DeepSeek : DeepSeekBot
- Ce que nous avons vérifié le 2026-11-09 : deepseek.com/robots.txt ; api-docs.deepseek.com/llms.txt (aucune correspondance) ; deepseek.com/deepseekbot.json (404)
- Résultat : Rien trouvé
Certains noms sont périmés. anthropic-ai et Claude-Web ne figurent pas sur la page d'Anthropic, FacebookBot ne figure pas sur la page de Meta, et Gemini-Deep-Research n'apparaît sur aucune des quatre pages de robots d'exploration de Google que nous avons lues. Ils ne sont pas documentés sur les pages lues, nous n'en listons donc aucun comme bot.
Comment cette liste a été contrôlée, et comment elle évolue
GeoIPHub a contrôlé cette liste de robots d'exploration IA en ouvrant la page de chaque opérateur, en récupérant chaque fichier, en recomptant et en exécutant les requêtes ci-dessus. La date d'une entrée ne change que lorsque nous recontrôlons cette entrée.
Les changements que nous avons constatés, chacun avec sa date : le fichier de Bingbot est passé de 28 à 29 préfixes sous une date figée au 2024-01-03. Le fichier de ChatGPT-User comptait 234 préfixes, puis 235 le 29 octobre, puis 237 dans un fichier daté du 6 novembre 2026. Les deux fichiers de Perplexity comptaient 4 et 8 préfixes le 27 octobre, et 10 et 13 le 28 octobre. Le fichier d'Anthropic avait 38 préfixes dans notre article sur le blocage des robots d'exploration IA (fichier daté du 7 octobre) et en a 14, daté du 20 octobre. Nous n'indiquons aucun calendrier de mise à jour, ni pour les opérateurs ni pour notre API. L'API ne renvoie pas la date de récupération ; un préfixe qu'un opérateur a ajouté récemment peut donc ne pas encore être vérifié.
Le nom dans l'en-tête est une revendication, et la preuve est le fichier de l'opérateur lorsque l'opérateur en publie un.
Questions fréquentes
Qu'est-ce qu'une liste de robots d'exploration IA ?
Une liste des clients automatisés que les entreprises d'IA et les produits de recherche exploitent pour récupérer des pages web, avec le User-Agent de chacun, sa fonction (entraînement, recherche, récupération déclenchée par l'utilisateur ou agent) et la manière de le prouver. Au 9 novembre 2026, la liste de GeoIPHub compte 29 bots documentés par leurs opérateurs, et l'API de GeoIPHub en vérifie 16 par IP.
Quelle est la différence entre GPTBot et ClaudeBot ?
GPTBot est le robot d'entraînement d'OpenAI et ClaudeBot celui d'Anthropic. Chacun publie un fichier de plages, et l'unique fichier d'Anthropic couvre aussi Claude-User et Claude-SearchBot. L'API de GeoIPHub vérifie une adresse issue de l'un ou l'autre fichier. Ce que fait chaque bot d'OpenAI est détaillé dans GPTBot vs OAI-SearchBot vs ChatGPT-User.
Quels robots d'exploration IA publient leurs plages d'IP ?
Au 9 novembre 2026, dix opérateurs publient 22 fichiers de plages pour des bots IA que nous avons pu trouver : OpenAI, Anthropic, Google, Perplexity, Mistral, Microsoft, Apple, DuckDuckGo, Common Crawl et Moonshot. GeoIPHub en charge 17. Amazon indique des adresses sur des pages web, et Meta et MistralAI-Training n'en publient aucune.
Peut-on vérifier un robot d'exploration IA par son User-Agent ?
Non. Un User-Agent est une chaîne que n'importe quel client peut envoyer. La requête de GeoIPHub ne prend que l'IP : elle peut vous dire que l'adresse figure dans le fichier d'OpenAI ou d'Anthropic, et c'est votre propre code qui compare cet opérateur au bot que nomme le User-Agent.
Quel User-Agent le robot d'exploration IA de Meta utilise-t-il ?
Meta documente meta-externalagent/1.1 pour l'entraînement, meta-webindexer/1.1 pour la recherche Meta AI et meta-externalfetcher/1.1 pour les récupérations demandées par l'utilisateur. Meta ne publie aucun fichier de plages, donc GeoIPHub associe son réseau par ASN et renvoie verified: false.
CCBot est-il un robot d'exploration IA ?
CCBot est le robot d'exploration de Common Crawl, qui publie pour lui un fichier d'IP et un reverse DNS. D'autres listes l'appellent un robot d'exploration IA parce que l'archive qu'il constitue peut servir à l'entraînement ; ce lien est le leur, pas une déclaration de Common Crawl. GeoIPHub vérifie son fichier et renvoie la catégorie archiver.
L'équipe derrière l'API GeoIPHub
Rédigé par l'équipe GeoIPHub, les personnes qui développent l'API de renseignement IP GeoIPHub et son scanner. Les brouillons sont préparés avec l'aide de l'IA et relus par l'équipe ; les exemples d'API sont de vraies requêtes sur l'API en production, sauf mention « illustratif ».
 Renseignement IP